 Français
 English
 Deutsch
 Español
 Italiano

Il y a six semaines, j'aurais rédigé cet article différemment.
En juillet, Moonshot AI a mis en ligne sur Hugging Face un modèle de pointe comportant 2 800 milliards de paramètres et l'a rendu accessible à tous. Le 28 août, Z.ai a enfin publié les poids du GLM-5.3 qu’elle gardait sous le coude depuis deux semaines — après avoir découvert que son propre modèle pouvait enchaîner des exploits d’une manière que personne ne lui avait demandée. Et le 1er septembre, Anthropic a lancé Claude Fable 5.1 et a rendu le travail des agents jusqu’à 451 TP3T moins cher sans modifier le prix affiché.
Trois modèles. Trois réponses totalement différentes à la question de savoir ce qu’un laboratoire d’IA doit au public. Et pour la première fois depuis le début de toute cette affaire, les options « open-weight » ne constituent pas un choix de compromis.
Voilà en quoi consiste réellement l'histoire de la fin de l'année 2026, et elle mérite bien environ huit mille mots, car c'est dans les détails que se cachent tout l'argent et toutes les erreurs.
J'ai rassemblé les documents techniques, les fiches de spécifications, les textes des licences — en les examinant minutieusement, ligne par ligne, car deux de ces trois éléments ne correspondent pas à ce que les gens appellent communément ainsi —, les benchmarks des fournisseurs, les notes des agrégateurs indépendants, les taux réels par jeton, ainsi que la toute nouvelle grille tarifaire d'Ollama. J’ai ensuite effectué les calculs de coûts sur la base d’un mois de travail normal, plutôt que d’un scénario de jour de lancement.
Voici le résultat.
En bref — Le verdict en 60 secondes
Le GLM-5.3 est actuellement le meilleur rapport qualité-prix en matière d'IA, et de loin. Selon les résultats d'Artificial Analysis, ses performances se situent à moins d'un demi-point de celles de Kimi K3 et à environ trois points et demi derrière celles de Claude Opus 5, avec $1,40 en entrée et $4,40 en sortie par million de tokens. Pour la même tâche d’agent, son coût représente environ un sixième de celui de Fable 5.1. Les poids sont téléchargeables. Si vous cherchez un modèle sur lequel baser votre agent et que vous ne dirigez pas une entreprise générant $10 milliards de chiffre d’affaires, c’est celui-ci qu’il vous faut.
Kimi K3 est le logiciel le plus performant que vous puissiez télécharger légalement. 2,8 billions de paramètres, 104 milliards actifs, un véritable contexte de 1 million, une vision native, le meilleur score de navigation agentique jamais publié (BrowseComp 91,2), et — le chiffre qui devrait mettre fin au débat selon lequel “ les modèles ouverts sont à la traîne ” — 88,3 sur Terminal-Bench 2.1, contre 88,0 pour Claude Fable 5 et 88,8 pour GPT-5.6 Sol sur la même version. Il coûte également $3/$15 — soit plus du double du GLM-5.3 — et ses 1,5 To de poids nécessitent un rack, et non une station de travail. C'est le modèle que l'on utilise lorsque la tâche est difficile et longue, et celui que l'on cite lorsque quelqu'un vous dit que les poids ouverts ont une génération de retard.
Le Claude Fable 5.1 reste le modèle vers lequel on se tourne lorsque la moindre erreur peut coûter cher. Il fait figure de référence en matière de travail agentique soutenu pendant plusieurs heures et de débogage fastidieux qui n’apparaît jamais clairement dans un classement. Le 1er septembre, Anthropic a réduit les lectures de cache de 75%, ce qui rend les longues sessions d’agents nettement moins coûteuses qu’auparavant. Son prix par tâche est également six fois supérieur à celui du GLM-5.3, il s’agit d’une offre fermée, et elle est désormais soumise à des restrictions anti-distillation qui empêchent le fonctionnement de certaines intégrations existantes.
La phrase qui résume tout en un mot : Les modèles « open-weight » ont réduit l'écart de performances à environ trois à cinq mois, et ils ont complètement comblé l'écart de prix. Ce que vous achetez réellement chez Anthropic en septembre 2026, c'est la fiabilité sur les tâches les plus difficiles de type 10% — et le droit de ne pas avoir à vous soucier de tout cela.
Et le rebondissement que personne n'ose avouer à voix haute : Ni Kimi K3 ni GLM-5.3 ne sont désormais distribués sous licence open source. Les deux projets sont passés cet été à des conditions sur mesure, subordonnées à des conditions commerciales. Des poids ouverts, oui. De l'open source, non. Lisez la section sur les licences avant que votre équipe juridique ne s'en charge.
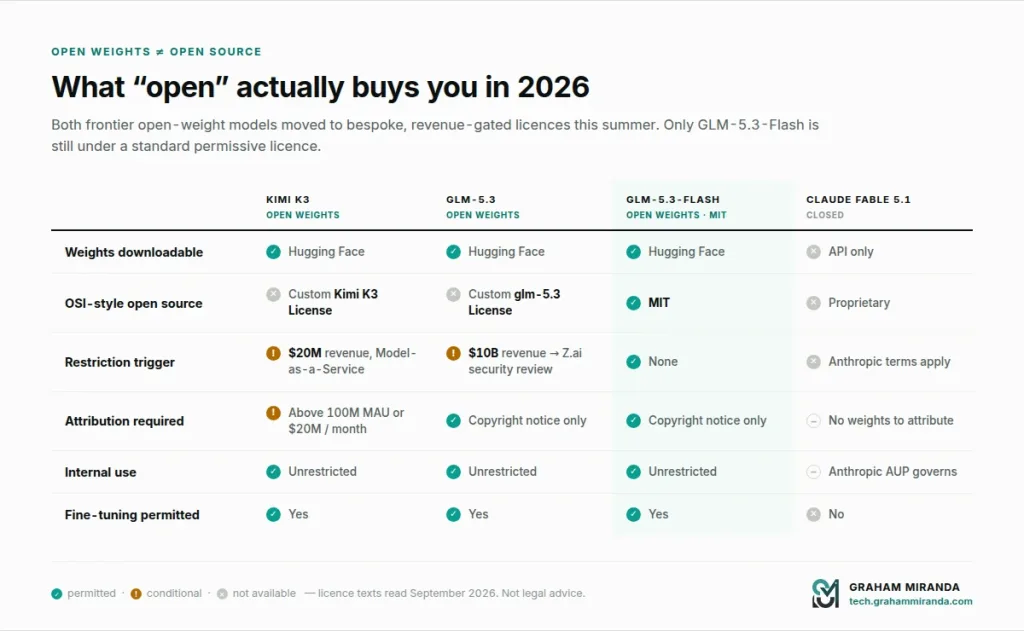
Tableau comparatif rapide
| Kimi K3 | GLM-5.3 | Claude Fable 5.1 | |
|---|---|---|---|
| Créateur | Moonshot AI | Z.ai (Zhipu AI) | Anthropique |
| Publié | 16 juillet 2026 (API) · 27 juillet (pesée) | 14 août 2026 (API) · 28 août (pesée) | 1er septembre 2026 |
| Poids disponibles | Oui | Oui | Non |
| Licence | Licence Kimi K3 (personnalisée, soumise à des conditions de revenus) | Licence glm-5.3 (personnalisée, liée au chiffre d'affaires) | Exclusif |
| Nombre total de paramètres | 2,8 T | 753B | Non divulgué |
| Actif par jeton | 104B (16 sur 896 experts) | environ 40 milliards (estimation) | Non divulgué |
| Architecture | KDA + résidus d'attention, LatentMoE stable, 69 couches KDA + 24 couches MLA à porte | Le modèle MoE, qui repose sur la même base que le GLM-5.2, tire profit uniquement de l'apprentissage postérieur. | Non divulgué |
| Fenêtre de contexte | 1,048,576 | 1,000,000 | 1,000,000 |
| Puissance maximale | 131 072 en défaut (jusqu'à 1 048 576) | 128,000 | 128,000 |
| Saisie multimodale | Texte, image, vidéo (MoonViT-V2) | Texte uniquement | Texte, image |
| Réflexion | Toujours activé | Toujours actif, effort_de_raisonnement min/max/max. | Fonctionnement permanent, adaptatif, effort par message (bêta) |
| Prix d'entrée / 1M | $3.00 | $1.40 | $10.00 |
| Données d'entrée mises en cache / 1 Mo | $0.30 | $0.26 | $0.25 |
| Prix de vente / 1 M | $15.00 | $4.40 | $50.00 |
| Indice d'intelligence AA | 59.7 | 59.5 | Pas encore noté (Fable 5 : 62,1) |
| Coût par tâche d'évaluation AA | $0.84 | $0.68 | — (Opus 5 : $2.34) |
| Empreinte de l'hébergement autonome | environ 1,5 To (MXFP4 natif) | ~1,5 To BF16 / ~750 Go FP8 | N/A |
| Sur Ollama | kimi-k3:cloud | glm-5.3 : cloud | Via Claude Code / Claude Desktop en tant que client |
Tous les prix indiqués sont les prix catalogue des fabricants. Les chiffres d'Artificial Analysis proviennent de l'instantané de l'indice de septembre 2026 ; Fable 5.1 a été lancé le 1er septembre et n'avait pas encore fait l'objet d'une évaluation indépendante au moment de la rédaction de cet article.
Pourquoi cette comparaison à trois est celle qui compte vraiment
Pendant deux ans, le débat « ouvert contre fermé » a suivi un schéma bien établi : les modèles fermés étaient meilleurs, les modèles ouverts étaient moins chers, et chacun choisissait sa position en fonction de ce compromis. Tout le monde savait où il en était.
Cette forme s'est cassée cet été.
Nathan Lambert, qui suit cette question de plus près que presque n'importe qui d'autre, estime que l'écart actuel de performances entre les modèles « frontier » en catégorie « open-weight » et ceux de la catégorie « closed » s'élève à trois à cinq mois — contre les six à neuf mois que l’on avançait il y a un an. Au moment où il a rédigé cet article, Kimi K3 occupait la #2 de l’indice Vals AI et figurait parmi les premiers de l’indice d’Artificial Analysis, devancé uniquement par Claude Fable et GPT-5.6 Sol Max. Le relevé de l’indice de septembre que j’utilise plus loin dans cet article le place en quatrième position, derrière Grok 4.6. Quoi qu’il en soit : ce n’est pas “ un bon résultat pour un modèle ouvert ”. C’est une place sur le podium.
Par ailleurs, les données d'utilisation ont révélé une tendance vraiment surprenante. Les modèles d'origine chinoise ont capté environ 61% de l'ensemble des jetons acheminés via OpenRouter d’ici mai 2026. La part des États-Unis dans ce trafic s’est effondrée, passant d’environ 70% à environ 30% en douze mois. Llama de Meta — le modèle à l’origine de la vague des modèles « open-weight » — est passé sous la barre des 1% de volume acheminé. La part de Google est passée d’environ 371 TP3T à 131 TP3T. L’étude menée par OpenRouter en collaboration avec a16z sur 100 000 milliards de jetons a révélé que les modèles « open-weight » représentaient environ un tiers du volume total de jetons sur la plateforme.
On peut débattre de ce que représente le trafic d’OpenRouter. Il surreprésente les développeurs, les amateurs et les charges de travail où le coût est un facteur déterminant, tandis qu’il sous-estime les contrats d’entreprise qui n’utilisent jamais de routeur. Soit. Mais il s’agit du plus grand ensemble de données public dont nous disposons sur ce que les gens choisissent réellement lorsqu’ils ont la liberté de choisir, et la tendance est sans ambiguïté.
Ainsi, en septembre 2026, la question ne sera plus “ les modèles ouverts sont-ils déjà suffisamment performants ? ”. Elle sera bien plus précise :
Parmi trois modèles qui répondent tous aux critères requis, lequel recommandez-vous à votre agent ? Et quel est le coût réel d'une erreur de votre part ?
C'est une question qui porte sur les indices de référence, les prix, les licences et les infrastructures, à peu près dans cet ordre selon l'importance que les gens leur accordent, mais exactement dans l'ordre inverse de leur importance réelle.
Qu'est-ce que la Kimi K3, au juste ?
Moonshot AI a annoncé le lancement de Kimi K3 le 16 juillet 2026 et a publié l’ensemble des poids le 27 juillet. Il s’agit, en nombre de paramètres, du plus grand modèle à poids ouverts jamais publié : 2,8 billions de paramètres au total, soit environ 75% de plus que DeepSeek V4 Pro.
Ce chiffre est à la fois moins impressionnant qu'il n'y paraît et plus impressionnant qu'il n'y paraît, dans cet ordre-là.
L'architecture, en termes simples
Kimi K3 est un modèle de type « mélange d'experts » qui active 104 milliards de paramètres par jeton, en sélectionnant 16 experts parmi un ensemble de 896. Ainsi, bien que le total s'élève à 2,8 T, chaque passage en avant ne touche que moins de 41 TP3T des poids. C'est là que réside l'intérêt économique : un immense capital de connaissances stockées, pour un coût d'inférence modéré.
C'est au niveau de la pile de gestion de l'attention que réside l'intérêt technique. K3 utilise 93 couches constituées de 69 couches KDA (Kimi Delta Attention) et de 24 couches Gated MLA — une architecture hybride combinant attention linéaire et attention complète, avec un rapport d’entrelacement d’environ 3:1. Le KDA est une variante de l’attention linéaire qui s’exécute en temps linéaire par rapport à la longueur de la séquence, plutôt qu’en temps quadratique, ce qui rend le contexte de 1 million de caractères économiquement viable, et non pas simplement théorique. Moonshot fait état d’une capacité pouvant atteindre 75% : réduction de la mémoire cache KV et jusqu'à Débit de décodage multiplié par 6 avec un contexte de 1 Mo en conséquence.
Par-dessus, on trouve Attention aux résidus (AttnRes), que Moonshot décrit comme un substitut direct aux connexions résiduelles standard, et un LatentMoE stable cadre de routage. Cette combinaison permettrait d'atteindre environ un Amélioration de 2,5 fois de l'efficacité globale de mise à l'échelle contre Kimi K2.
La vision vient de MoonViT-V2, un encodeur comportant 401 millions de paramètres, et qui est intégré de manière native plutôt que rajouté après coup — K3 traite le texte, les images et la vidéo au sein d’un seul modèle.
Un autre détail important pour tous ceux qui envisagent l'auto-hébergement : K3 a été entraîné avec Entraînement natif tenant compte de la quantification MXFP4, avec des experts dans MXFP4 et des activations dans MXFP8. Il ne s'agit pas d'une quantification a posteriori. Le point de contrôle publié correspond au modèle quantifié, ce qui explique pourquoi 2,8 billions de paramètres aboutissent à environ 1,5 To d'espace disque plutôt que les quelque 5,6 To qu'exigerait un point de contrôle BF16 de cette taille.
L'histoire de référence
Les chiffres publiés par Moonshot sont excellents dans tous les domaines et, fait inhabituel, plusieurs d'entre eux ont été confirmés par une évaluation indépendante :
- Terminal-Bench 2.1 : 88,3 — le meilleur score publié pour cette version du test de performance
- FrontierSWE : 81,2
- DeepSWE : 67,5
- BrowseComp : 91,2 — État de l’art de la recherche sur le Web agentique
- GPQA Diamond : 93,5
- MMMU-Pro : 81,6 / 83,4 (vision)
- Marathon SWE : 91,0
- OfficeQA Pro : 81,3
- AutomationBench : 30,8
- LMArena Frontend Code Arena : 1 679 Elo — première place, devant Claude Fable 5 (1 631) et GPT-5.6 Sol (1 618), remportant six des sept domaines front-end
Ce dernier point mérite qu'on s'y attarde. Un modèle à poids ouvert, téléchargeable gratuitement, a remporté la première place lors d’un concours de programmation de front-end axé sur les préférences humaines, devançant les modèles fermés phares des deux laboratoires les mieux financés au monde. Quelle que soit votre opinion sur les benchmarks de ce type en tant que méthodologie, c’est un titre qui aurait été impensable en 2025.
En ce qui concerne les indices globaux, il se situe légèrement en dessous : 59,7 sur l'indice d'intelligence artificielle analytique, troisième au classement général, derrière Claude Opus 5 (63,0) et Claude Fable 5 (62,1). Les résultats de Moonshot — GDPval-AA v2 à 1 687 et AA-Mallette à 1 527 — ce qui les place respectivement en troisième et deuxième position dans ces évaluations du travail intellectuel. Selon l'indice Vals v2, il se classe à la 57.8%, face au 67,21 TP3T de Claude Opus 5, les 66,01 TP3T de Claude Fable 5 et les 63,71 TP3T de GPT-5.6 Sol — l'écart le plus important entre ’ ouvert ’ et « fermé » que j'ai trouvé dans tous les indices, et qu'il convient de garder à l'esprit face aux chiffres relatifs au codage.
Les démos et comment les interpréter
Moonshot a publié deux démonstrations d'autonomie à long terme qui ont suscité beaucoup d'intérêt : une Fonctionnement autonome de 48 heures permettant de mener à bien l'ensemble du processus de conception d'une puce (une conception de 4 mm fonctionnant à 100 MHz, simulant un débit de plus de 8 700 jetons par seconde), et une reproduction de l'astrophysique La relation I-Love-Q dans environ deux heures, contre une à deux semaines dont aurait généralement besoin un chercheur expérimenté.
Ces démonstrations sont certes impressionnantes, mais je ne m’appuierais pas sur elles pour prendre une décision d’achat. Les démonstrations organisées, mises en place et sélectionnées par les fournisseurs vous montrent ce dont un modèle est capable dans les meilleures conditions, sous la supervision d’experts, et non ce qu’il fait dans votre référentiel un mardi quelconque. Considérez-les comme une preuve de principe pour des capacités à long terme, et non comme un cahier des charges.
Afficher l'image Deux architectures publiées et une « boîte noire ». Les modèles ouverts vous expliquent exactement comment ils fonctionnent ; le modèle fermé vous indique le score obtenu.
Qu'est-ce que le GLM-5.3, au juste ?
La version GLM-5.3 est celle dont l'histoire de publication est la plus singulière parmi les trois, et c'est celle qui mérite d'être racontée en détail, car c'est la première fois qu'un grand laboratoire a manifestement hésité à publier des coefficients de pondération pour des raisons autres que commerciales.
Z.ai a annoncé la sortie de GLM-5.3 le 14 août 2026 avec le slogan “ Conçu pour respecter les normes. Prêt pour la cyberdéfense. ”. Ce modèle est un Mélange d'experts à 753 milliards de paramètres, avec environ 40 milliards de tokens actifs selon les estimations de la communauté issues de la configuration GLM-5.2. Il dispose d'une fenêtre de contexte de 1 million de tokens et d'une sortie maximale de 128 000, et — contrairement à GLM-5.3-Flash, qui est un modèle totalement différent — il est texte seul.
“ Nous n'avons fait que développer l'activité après la formation ”
L'aspect technique le plus intéressant concernant le GLM-5.3 est qu'il n'y a pas de nouveau modèle de base. Il réutilise la même base pré-entraînée que le GLM-5.2. Tous les progrès ont été obtenus grâce à un post-entraînement considérablement prolongé, que Z.ai a résumé ainsi : “ Pour la version GLM-5.3, nous nous sommes contentés d'optimiser la mise à l'échelle après l'entraînement. ”
Les écarts ne sont pas négligeables :
| Référence | GLM-5.2 | GLM-5.3 |
|---|---|---|
| Terminal-Bench 3.0 | 4.6 | 28.3 |
| DeepSWE v1.1 | 46.2 | 66.9 |
| CyberGym | 77.2% | 84.5% |
Une amélioration multipliée par six sur Terminal-Bench et un bond de vingt points sur DeepSWE, à partir des mêmes poids de base, constituent un résultat véritablement significatif. Cela montre que la frontière dispose encore d’une marge de progression importante en phase de post-entraînement, qui représente de loin la partie la moins coûteuse du coût total de l’entraînement. C’est précisément pour cette raison que les laboratoires chinois, qui fonctionnent, comme le dit Lambert, avec “ des capitaux inférieurs de plusieurs ordres de grandeur ” à ceux des laboratoires américains, parviennent à suivre le rythme.
Les deux semaines pendant lesquelles Z.ai n'a pas effectué de livraisons
Lors de son lancement, Z.ai avait indiqué que les paramètres seraient mis à disposition “ par étapes, après des évaluations de sécurité rigoureuses ”, avec un délai cible d’environ deux semaines. Son dépôt Hugging Face mentionnait la date du 28 août. Cette date est arrivée, s’est écoulée en l’espace de quelques heures, puis les paramètres ont été publiés, accompagnés d’une note technique expliquant ce retard.
La raison tenait aux capacités cybernétiques. Au cours de l'évaluation, Z.ai a indiqué que le GLM-5.3 avait identifié 2 436 vulnérabilités réparties sur 269 projets open source, dont 1 097 ont été classées comme critiques ou présentant un niveau de gravité élevé. Plus précisément, le modèle a démontré que raisonnement sur les chaînes d'exploitation à plusieurs étapes — en enchaînant de manière autonome les différentes étapes d’exploitation — ce que Z.ai a qualifié de comportement “ non entièrement prévu ” et qui “ s’est amplifié à mesure que l’entraînement prenait de l’ampleur ”.”
Je tiens à faire preuve de prudence ici, car on pourrait facilement interpréter cela comme du marketing ou de l’alarmisme, alors qu’il ne s’agit probablement ni de l’un ni de l’autre. Un modèle efficace pour détecter les vulnérabilités est efficace pour détecter les vulnérabilités ; les utilisations défensives et offensives relèvent de la même capacité, orientée dans des directions différentes. Les résultats des tests comparatifs de Z.ai reflètent honnêtement cette réalité : CyberGym 84.5% (la découverte de vulnérabilités, et ses conséquences) face à ExploitBench 54.4% (exploitation, où Claude Fable 5 totalise 78,01 TP3T). Le laboratoire a délibérément optimisé la moitié défensive, et cela se voit.
Ce qui est vraiment remarquable, c'est qu'un laboratoire ait décidé de retarder de deux semaines la sortie d'un produit phare et ait rendu public son raisonnement. Que ce raisonnement vous semble convaincant ou non, ce précédent est inédit.
Où le GLM-5.3 atterrit-il réellement ?
Le tableau comparatif publié par Z.ai ne prétend pas faire l'unanimité, ce qui est rafraîchissant :
| Référence | GLM-5.3 | Meilleur comparateur |
|---|---|---|
| AutomationBench | 48.2% | Conducteurs GLM-5.3 |
| CyberGym | 84.5% | Conducteurs GLM-5.3 |
| GDPval-AA v2 | 1,769 | Conducteurs GLM-5.3 |
| Terminal-Bench 3.0 | 28.3% | GPT-5.6 Résultat : 34,61 TP3T |
| DeepSWE v1.1 | 66.9% | GPT-5.6 Résultat : 72,71 TP3T |
| ExploitBench | 54.4% | Claude Fable 5 : 78,01 TP3T |
| Code Bench (50 000 jetons) | 31.4% | — |
Par ailleurs, selon Artificial Analysis, ce chiffre s'élèverait à 59,5 sur l'indice d'intelligence — statistiquement impossible à distinguer du 59,7 obtenu par Kimi K3, à partir d’un modèle comportant environ un quart des paramètres.
Une mise en garde issue de cette même évaluation dont personne au service marketing ne parle : GLM-5.3 a généré 170 millions de jetons générés par la suite Artificial Analysis, contre une médiane de 72 millions pour les solutions comparables. C'est trop détaillé. effort_de_raisonnement La valeur par défaut est max Et comme on ne peut pas désactiver la réflexion, vous payez pour un long processus de réflexion, que la tâche le mérite ou non. Malgré tout, le coût total de la réalisation de l’évaluation complète s’est élevé à $0,68 par tâche, contre $0,84 pour la Kimi K3 et $2,34 pour la Claude Opus 5 — la complexité ne compense donc pas l'avantage en termes de prix. Elle ne fait que le réduire.
Qu'est-ce que « Claude Fable 5.1 » exactement ?
Anthropic a publié Claude Fable 5.1 le 1er septembre 2026, aux côtés du Claude Mythos 5.1 — le même modèle doté d’une configuration de sécurité différente, disponible uniquement dans le cadre de programmes d’accès sécurisé destinés aux travaux dans les domaines de la cybersécurité et des sciences de la vie.
Ce positionnement est précis et, à mon avis, juste : il s'agit de “ un modèle conçu pour des tâches qui ne s'achèvent pas en une seule instruction. ” Anthropic ne prétend pas avoir fait un bond en avant en matière d'intelligence générale. L'entreprise affirme simplement que les sessions d'agentique prolongées, s'étalant sur plusieurs heures, donnent de meilleurs résultats.
Les chiffres
| Référence | Fable 5 | Fable 5.1 | Mythos 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | 42.0% | 55.8% | 60.9% |
| Terminal-Bench-Science 0.1 | 24.7% | 52.6% | — |
| AutomationBench | 17.1% | 31.4% | — |
| CursorBench 3.2.0 | 70.5% | 73.4% | — |
| OSWorld 2.0 (extrait) | 72.9% | 77.9% | — |
| Le dernier examen de l'humanité (avec des outils) | 63.8% | 65.0% | — |
| GDPval-AA v2 | — | 1,853 | — |
Pour plus d'informations sur ce même souverain : GPT-5.6 Sol obtient un score de 52,31 TP3T sur Terminal-Bench 4.0, si bien que le 55,81 TP3T de Fable 5.1 prend la tête et que le 60,91 TP3T de Mythos 5.1 creuse l'écart.
Le bond enregistré par Terminal-Bench-Science — passant de 24,71 TP3T à 52,61 TP3T, soit un doublement net — est celui auquel j’accorderais le plus d’importance si votre travail implique le calcul scientifique ou les pipelines de données. Et dans le test de performance le plus exigeant de Browserbase en matière d’utilisation de l’ordinateur, Fable 5.1 a terminé 82% de tâches contre les 74% de Claude Opus 5.
Anthropic indique également environ un Réduction de 60% des faux positifs en matière de cybersécurité — le modèle refusant une tâche de sécurité légitime au motif qu’elle correspondait à un modèle associé à un élément dangereux. Si vous avez déjà vu un assistant de programmation refuser de vous aider à écrire un limiteur de débit, vous comprendrez pourquoi cela a de l’importance.
C'est le changement de tarification qui fait l'actualité
Les taux de référence sont restés inchangés : $10 par million de jetons d'entrée, $50 par million de jetons de sortie. Ce qui a changé, c'est le multiplicateur de lecture du cache, et ce changement est considérable.
| Fable 5 | Fable 5.1 | |
|---|---|---|
| Saisie | $10.00 | $10.00 |
| Résultat | $50.00 | $50.00 |
| Écriture dans le cache (5 min) | $12.50 | $12.50 |
| Écriture dans le cache (1 heure) | $20.00 | $20.00 |
| Lecture du cache | $1.00 | $0.25 |
Il s'agit d'une réduction de 75%, obtenue en ramenant le multiplicateur de lecture du cache de la valeur standard de 0,1× de l'entrée de base à 0,025×. Anthropic avance un chiffre approximatif de 251 TP3T moins cher pour les charges de travail classiques et jusqu’à 451 TP3T moins cher pour les tâches hautement agentiques — et ce deuxième chiffre est bien réel, car les boucles d’agent consistent en très grande majorité en des lectures de cache. Une session d’agent de 60 itérations relit le même contexte accumulé des dizaines de fois. L’API Batch réduit de moitié les entrées et les sorties, ce qui donne $5/$25.
Il s'agit d'une baisse de prix intelligente et ciblée. Elle rend nettement plus abordable ce pour quoi la Fable 5.1 excelle — les longues sessions — sans pour autant dévaloriser le modèle dans son ensemble.
Trois modifications majeures, une régression
Avant de mettre à niveau une intégration en production, lisez attentivement ces informations.
1. L'utilisation forcée des outils n'existe plus. Demandes utilisant tool_choice : " any " ou choix_d'outil : " outil " renvoie maintenant un Erreur 400. La réflexion est toujours active et ne peut pas être contournée ; forcer l'appel d'un outil permettrait de la sauter. Vous devez utiliser tool_choice : " auto ".
2. Les blocages cognitifs sont unidirectionnels. Fable 5.1 peut lire les ’ thinking blocks » générés par les anciens modèles Claude, mais ces derniers ne peuvent pas lire ceux de Fable 5.1. Seul Mythos 5.1 en est capable. Si votre infrastructure change de modèle en cours de conversation pour réaliser des économies, ce repli vers une solution de secours impose désormais une nouvelle planification.
3. L'historique des modifications rend les « blocs de réflexion » caduques. Pour les comptes créés après le 31 août 2026, la modification des tours précédents, des invites du système ou de la palette d’outils invalide tous les blocs de réflexion suivants — qu’il s’agisse d’erreurs ou d’abandons silencieux. Il s’agit d’une mesure explicite de lutte contre la distillation, qui met fin à un schéma courant dans lequel les frameworks d’agents réécrivent le contexte entre deux tours.
Et voici une régression qu'il est bon de connaître : L'appel parallèle des outils serait plus variable dans la version 5.1 : il arrive parfois qu'un seul appel soit effectué par tour, alors que la version 5 en regroupait plusieurs. Sur une boucle d'agent longue, cela se traduit par une perte de temps réel.
Il y a également un détail concernant le tokeniseur qui peut prêter à confusion lors des comparaisons de coûts : Fable 5.1 utilise le même tokeniseur que Claude Opus 4.7, qui produit environ 30% : plus de jetons que le tokeniseur des anciens modèles Claude pour le même texte. Si vous comparez les coûts par rapport à une référence de 2025, tenez-en compte avant de tirer des conclusions.
Le problème de référence : trois modèles, trois règles différentes
Voici le point sur lequel la plupart des articles comparatifs se trompent, et il vaut mieux le dire sans détours.
Il n'est pas possible d'aligner ces trois modèles sur Terminal-Bench. Regarde :
- Kimi K3 : 88.3 sur Terminal-Bench 2.1
- GLM-5.3 : 28.3 sur Terminal-Bench 3.0
- Fable 5.1 : 55.8 sur Terminal-Bench 4.0
Il s'agit de trois benchmarks différents qui portent le même nom. Chaque version est devenue nettement plus difficile que la précédente — c'est d'ailleurs tout l'intérêt de sortir une nouvelle version. Si l'on interprétait ces trois chiffres comme un classement, on en conclurait que Kimi K3 est trois fois plus performant que GLM-5.3 pour le travail terminal, ce qui est absurde.
Le même problème se pose avec AutomationBench, où les numéros de version ne sont pas indiqués de manière cohérente, ainsi qu’avec la famille SWE-bench, où les variantes « Verified », « Pro » et « Marathon » mesurent des éléments réellement différents. Les laboratoires ne font pas cela dans le but de tromper qui que ce soit : ils utilisent les critères d’évaluation en vigueur au moment de leur formation, et ces critères changent désormais tous les quelques mois. Mais pour un lecteur non averti, l’effet est le même que s’il s’agissait d’une tromperie ; il convient donc de le signaler haut et fort.
Ce que vous pouvez légitimement comparer, au sein d'une même version :
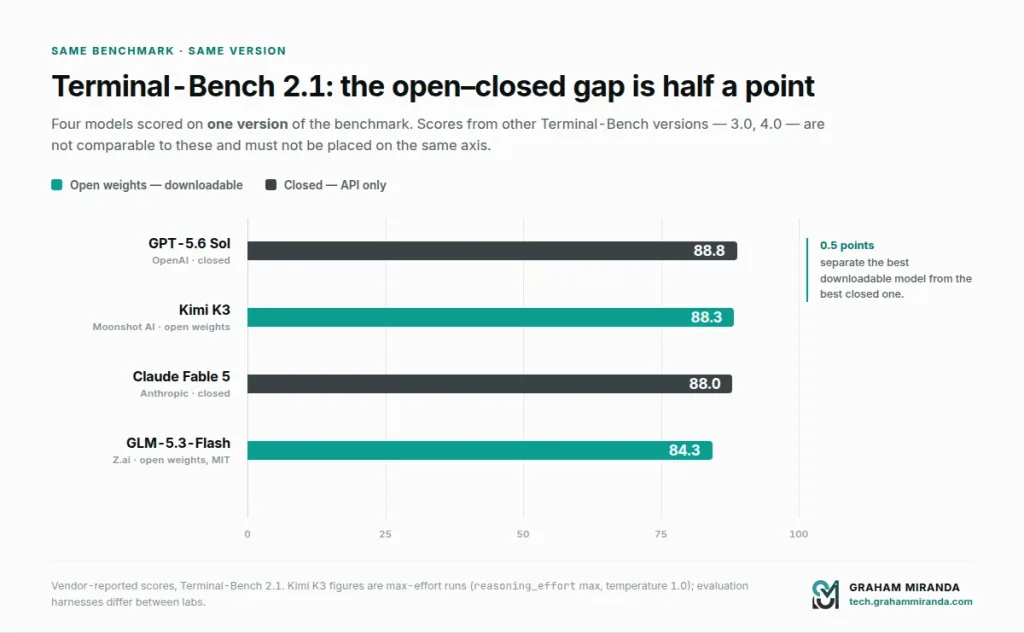
Sur Terminal-Bench 2.1: Kimi K3 (88,3), GPT-5.6 Sol (88,8), Claude Fable 5 (88,0) et GLM-5.3-Flash (84,3). Quatre modèles, une seule échelle de référence. C’est cette comparaison qui importe réellement, et je lui ai consacré un tableau à part entière dans la section suivante.
Sur Terminal-Bench 4.0: Fable 5.1 (55,8) contre GPT-5.6 Sol (52,3). Fable l'emporte.
Par ailleurs, méfiez-vous de quiconque vous présente un seul graphique à barres reprenant les trois principaux modèles évoqués dans cet article sur un axe « Terminal-Bench ». C'est tout simplement impossible à réaliser de manière honnête.
Où se recoupent-ils réellement ? Les chiffres comparables entre eux
Si l'on élimine les cas où la version du benchmark ne correspond pas, il reste trois comparaisons.
1. Indice d'analyse de l'intelligence artificielle (septembre 2026)
Gestion indépendante, méthodologie identique pour tous les modèles, aucune implication des fournisseurs dans la sélection.
| Classement | Modèle | Score | Poids libres |
|---|---|---|---|
| 1 | Claude, opus 5 | 63.0 | Non |
| 2 | Claude Fable 5 | 62.1 | Non |
| 3 | Grok 4.6 | 60.9 | Non |
| 4 | Kimi K3 | 59.7 | Oui |
| 5 | GLM-5.3 | 59.5 | Oui |
| 6 | GPT-5.6 Sol | 58.9 | Non |
| 7 | Aperçu de Qwen 3.8 Max | 58.1 | Poids à confirmer |
| 8 | GLM-5.3-Flash | 57.5 | Oui (MIT) |
| 31 | MiniMax M3 | 45.4 | Oui |
Au moment de la rédaction de cet article, Fable 5.1 n'avait pas encore fait l'objet d'une évaluation indépendante — il venait de sortir la veille. Compte tenu des écarts de performances constatés entre Fable 5.1 et Fable 5 lors des tests de performance, on peut s'attendre à ce qu'il atteigne un score égal ou supérieur à 62,1 lorsqu'il sera évalué.
Remarque concernant la précision : les différents instantanés de cet indice présentent des variations — un relevé de septembre, par exemple, donne Kimi K3 et GLM-5.3 tous deux à 60, et GPT-5.6 Sol à 61. Le classement en tête reste stable, mais les écarts entre les sous-points varient. Ne fondez pas votre argumentation sur un demi-point.
Lisez attentivement ce tableau. Le meilleur modèle « open-weight » affiche un écart de 3,3 points par rapport au meilleur modèle « closed » sur l'indice neutre le plus large disponible. Il y a un an, cet écart était à deux chiffres.
2. Terminal-Bench 2.1 — la seule version où les trois se rejoignent
C'est le tableau le plus utile de tout l'article, et j'ai failli le manquer. Kimi K3, Claude Fable 5 et GPT-5.6 Sol ont tous été évalués sur la même version de Terminal-Bench :
| Modèle | Terminal-Bench 2.1 | Poids libres |
|---|---|---|
| GPT-5.6 Sol | 88.8 | Non |
| Kimi K3 | 88.3 | Oui |
| Claude Fable 5 | 88.0 | Non |
| GLM-5.3-Flash | 84.3 | Oui (MIT) |
Un demi-point sépare un modèle téléchargeable du meilleur modèle fermé sur le même benchmark, avec la même version, dans le cadre de travaux agentiques natifs sur terminal.
C'est ce chiffre qu'il faut retenir. Ni l'agrégat de l'indice, ni le graphique du fournisseur… mais celui-ci. En ce qui concerne la nature spécifique de la codification agentique, l'écart se cache dans le bruit.
Une mise en garde, soulignée par la source et qui mérite d'être répétée : Tous les chiffres publiés concernant la Kimi K3 correspondent à des tours effectués à plein régime, à effort_de_raisonnement maximum et température 1,0. Les différents laboratoires utilisent des dispositifs d'évaluation et des paramètres d'effort variés ; par conséquent, même les comparaisons entre versions identiques comportent davantage d'incertitudes que ne le laisse supposer un tableau simplifié.
3. Coût d'exploitation de cette même suite d'évaluation
Si le tableau ci-dessus présente la meilleure comparaison en termes de fonctionnalités, voici quant à elle la meilleure comparaison en termes de rapport qualité-prix — car c'est le seul indicateur qui regroupe les fonctionnalités, la verbosité, la charge de raisonnement et le prix en un seul chiffre :
| Modèle | Coût par tâche de l'indice d'intelligence |
|---|---|
| GLM-5.3 | $0.68 |
| Kimi K3 | $0.84 |
| Claude, opus 5 | $2.34 |
Mêmes tâches, même notation, factures réelles. GLM-5.3 offre un score de 94% selon l’indice d’Opus 5 pour un coût de 29%.
4. GDPval-AA v2 (travail intellectuel)
| Modèle | Score |
|---|---|
| Claude Fable 5.1 | 1,853 |
| Claude Fable 5 Max | 1,815 |
| GLM-5.3 | 1,769 |
| GPT-5.6 Sol Max | 1,747.8 |
| Kimi K3 | 1,687 |
Il convient toutefois de nuancer ce point : ces données sont issues de graphiques publiés par les éditeurs plutôt que d’une seule étude indépendante, et les suffixes “ Max ” indiquent différents niveaux d’effort. Mais le classement est globalement cohérent d’une source à l’autre, et il révèle une réalité : en matière de travail intellectuel général, par opposition au codage, les modèles fermés conservent une avance plus nette que ne le suggèrent les tests de performance en codage.
C'est la tendance qui se dégage des trois comparaisons. Les modèles ouverts ont pratiquement rattrapé leur retard en matière de codage et de tâches impliquant une capacité d'action. Ils ont toutefois encore un peu de retard à rattraper en ce qui concerne les tâches intellectuelles générales. Si votre charge de travail correspond au premier cas, les arguments en faveur du paiement de prix pratiqués pour les modèles fermés sont peu convaincants. Si elle correspond au second cas, ce choix reste toutefois défendable.
Afficher l'image Un peu plus de trois points séparent le meilleur modèle « fermé » du meilleur modèle téléchargeable. Il y a douze mois, cet écart était à deux chiffres.
Le calcul des coûts, avec des chiffres concrets
Les indicateurs de référence sont abstraits. Les factures, elles, ne le sont pas.
Le scénario
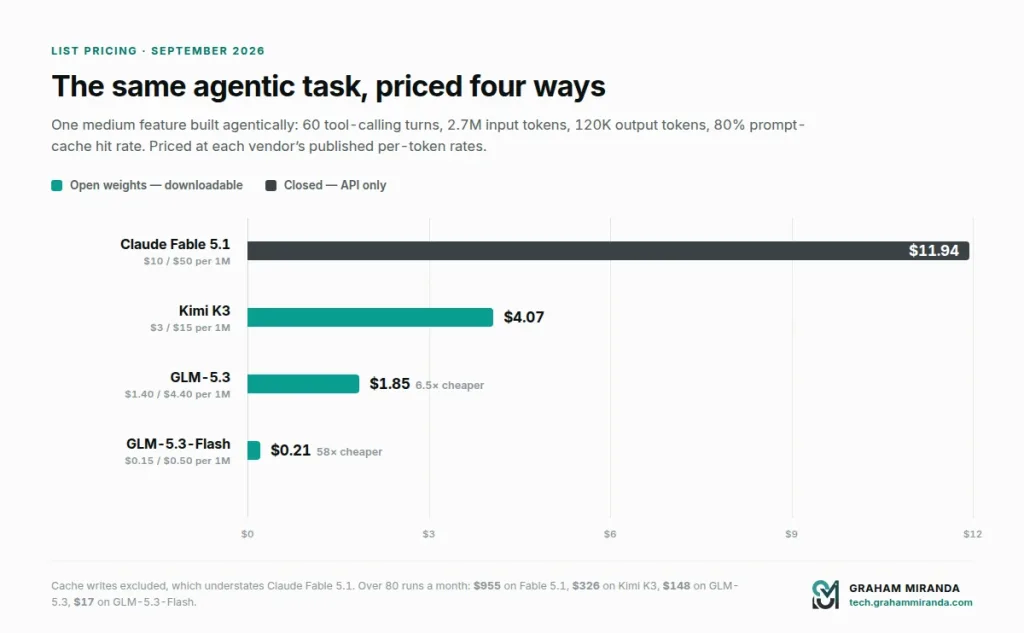
Une caractéristique de niveau moyen, réalisée de manière active : en gros 60 cycles d'appel d'outils, soit en moyenne 45 000 jetons d'entrée par tour à mesure que le contexte s'étoffe, et 2 000 jetons de production par tour.
- Total des données saisies : 2,7 millions de jetons
- Production totale : 120 000 jetons
- Taux supposé de réussite des accès au cache des invites : 80% (2,16 millions en cache, 540 000 récents)
Claude Fable 5.1
| Composant | Jetons | Taux | Coût |
|---|---|---|---|
| Nouvelles informations | 540 000 | $10,00/M | $5.40 |
| Données mises en cache | 2,16 millions | $0,25/M | $0.54 |
| Résultat | 120 000 | $50,00/M | $6.00 |
| Total | ≈ $11,94 |
Kimi K3
| Composant | Jetons | Taux | Coût |
|---|---|---|---|
| Nouvelles informations | 540 000 | $3,00/M | $1.62 |
| Données mises en cache | 2,16 millions | $0,30/M | $0.65 |
| Résultat | 120 000 | $15,00/M | $1.80 |
| Total | ≈ $4,07 |
GLM-5.3
| Composant | Jetons | Taux | Coût |
|---|---|---|---|
| Nouvelles informations | 540 000 | $1,40/M | $0.76 |
| Données mises en cache | 2,16 millions | $0,26/M | $0.56 |
| Résultat | 120 000 | $4,40/M | $0.53 |
| Total | ≈ $1,85 |
À titre de référence : GLM-5.3-Flash
| Composant | Jetons | Taux | Coût |
|---|---|---|---|
| Nouvelles informations | 540 000 | $0,15/M | $0.08 |
| Données mises en cache | 2,16 millions | $0.03/M | $0.06 |
| Résultat | 120 000 | $0,50/M | $0.06 |
| Total | ≈ $0,21 |
Les ratios
- Le GLM-5.3 est 6,5 fois moins cher que le Fable 5.1 pour un travail identique
- Kimi K3 coûte 2,9 fois moins cher que Fable 5.1
- Le GLM-5.3 est 2,2 fois moins cher que le Kimi K3
- GLM-5.3-Flash coûte 58 fois moins cher que Fable 5.1, avec un score de 57,5 à l'indice d'intelligence, contre 62,1 pour Fable 5
Conversion en mois de travail
Quatre tâches de ce type par jour, vingt jours ouvrés — soit 80 exécutions :
| Modèle | Coût mensuel des jetons |
|---|---|
| Claude Fable 5.1 | ≈ $955 |
| Kimi K3 | ≈ $326 |
| GLM-5.3 | ≈ $148 |
| GLM-5.3-Flash | ≈ $17 |
Trois mises en garde sincères concernant ces chiffres
Les écritures dans le cache sont exclues. Fable 5.1 facture 1 TP 4 T 12,50/M pour 5 minutes d'écritures dans le cache, et une session longue effectue des écritures répétées dans le cache. La prise en compte des écritures fait augmenter, et non diminuer, le chiffre réel de Fable. Le taux de réussite de 801 TP 3 T est également optimiste pour les sessions courtes.
Les jetons de raisonnement sont facturés comme des jetons de sortie. Ces trois modèles fonctionnent en mode « always-on ». Le GLM-5.3, en particulier, est connu pour être très prolixe — 170 millions de tokens de sortie contre une médiane de 72 millions pour l’ensemble de la suite AA — ; son volume de sortie réel est donc supérieur à ce que laisserait supposer un simple comptage naïf du nombre de tours. Le chiffre de $0,68 par tâche tient déjà compte de cela, c’est pourquoi je lui accorde davantage de crédit qu’à mon propre modèle présenté ci-dessus.
Le tokeniseur de Fable 5.1 génère environ 30% de tokens supplémentaires que les anciens modèles de Claude pour le même texte. Si vous effectuez une comparaison avec une facture historique de Claude, veillez à ajuster les valeurs en conséquence.
Même après ces trois corrections, l'ordre reste inchangé et l'ordre de grandeur ne varie pratiquement pas. Le travail en « frontière fermée » coûte environ six fois plus cher que le meilleur modèle « poids ouvert », par tâche réalisée.
Afficher l'image La même tâche agentique de 60 tours au prix catalogue de chaque fournisseur. L'axe vertical représente l'argument complet pour les poids ouverts.
Licences : ce que le terme “ ouvert ” vous apporte réellement en 2026
C'est la partie que j'aimerais le plus que les gens lisent, car le vocabulaire a beaucoup dérivé et cela va coûter très cher à quelqu'un.
Ni Kimi K3 ni GLM-5.3 ne sont open source. Ces deux entités publient des fichiers de poids téléchargeables sous des licences sur mesure, assorties de conditions liées au chiffre d'affaires. Il s'agit là d'une différence significative par rapport aux licences MIT ou Apache 2.0, et cette différence concerne précisément le type d'entreprise qui tirerait le plus grand avantage de l'auto-hébergement.
La licence Kimi K3
Vous verrez souvent l'expression “ Modified MIT ” utilisée sur Internet pour désigner la version K3. C'est une erreur : cela correspondait à la version K2. La version K3 est distribuée sous une licence personnalisée comportant deux étapes distinctes :
La passerelle « Model-as-a-Service ». Si vous accordez à des tiers l'accès à l'inférence ou au réglage fin d'un modèle — lorsque ces tiers contrôlent les entrées, les paramètres ou les données d'apprentissage — et “ le chiffre d'affaires cumulé du titulaire de la licence et de ses sociétés liées dépasse 20 millions de dollars américains ” sur une période de 12 mois consécutifs, vous devez conclure un accord commercial distinct avec Moonshot. Remarque agrégat le chiffre d'affaires de l'ensemble des filiales, et non le chiffre d'affaires attribuable à K3. Une société de conseil dont le chiffre d'affaires s'élève à 25 millions d'euros et qui revend des solutions d'inférence dépasse le seuil, même si son activité dans le domaine de l'IA ne représente qu'une erreur d'arrondi.
La porte de l'attribution. Produits dont le poids dépasse 100 millions d'utilisateurs actifs par mois ou $20 millions de chiffre d'affaires mensuel doit afficher “ Kimi K3 ” de manière bien visible dans l'interface du produit.
L'exonération la plus importante : L'utilisation purement interne n'est soumise à aucune restriction. L'utilisation de K3 pour soutenir vos propres développeurs, chercheurs, votre équipe juridique ou la productivité générale de vos employés ne déclenche aucune des deux conditions. Pour la grande majorité des entreprises — y compris pratiquement toutes les miennes —, c'est cette clause qui s'applique, et la réponse est que vous n'avez rien à craindre.
La nouveauté par rapport à la version K2 réside dans le seuil de MaaS « $20M ». La version K2 n’exigeait une attribution qu’au-delà de ses propres seuils. La version K3 ajoute un seuil de chiffre d’affaires nettement plus bas, visant spécifiquement les revendeurs d’inférence commerciale. Moonshot ne cherche pas à vous empêcher d'utiliser le modèle ; il cherche à empêcher les fournisseurs de cloud de développer gratuitement une activité à partir de celui-ci.
Licence glm-5.3
Le produit phare de Z.ai a pris une direction différente, et il s'agit d'une rupture plus marquée avec les pratiques antérieures que ne l'ont généralement reconnu les médias.
GLM-5.2 est distribué sous licence MIT. GLM-5.3-Flash est distribué sous licence MIT. Ce n'est pas le cas de GLM-5.3.
La licence personnalisée permet aux particuliers et aux entreprises classiques d'exécuter, de déployer et d'ajuster le modèle sans aucune restriction supplémentaire. La licence « Single Gate » s'adresse aux hyperscalers : une entité dont “ le chiffre d'affaires cumulé du titulaire de la licence et de ses sociétés liées dépasse 10 milliards de dollars américains (ou l'équivalent dans d'autres devises) au total sur une période de 12 mois consécutifs ” doit passer avec succès l'évaluation de sécurité de Z.AI avant d'utiliser le modèle ou ses dérivés à des fins commerciales.
Il s'agit d'un seuil fixé à $10 milliards. Cela exclut pratiquement tout le monde. Mais deux détails figurant en petits caractères méritent notre attention :
Tout d'abord, la licence exclut explicitement les développeurs d'applications qui intègrent le modèle dans leurs fonctionnalités, ainsi que les revendeurs qui se contentent de rediriger les requêtes vers d'autres hébergeurs. La cible est restreinte et clairement définie : les entreprises qui souhaitent hôte Mise en œuvre commerciale à grande échelle du GLM-5.3.
Deuxièmement — et c'est là que ça devient vraiment gênant — La licence ne précise aucun critère, aucun délai ni aucune procédure de recours concernant cet examen de sécurité. Il précise simplement que son “ Le champ d'application et la méthode […] seront déterminés de manière raisonnable par Z.AI. ” Si vous êtes une grande entreprise, cela revient à dépendre sans limite du bon vouloir d'un fournisseur étranger, et votre équipe des achats vous le fera savoir.
Il convient également de noter que, malgré le gel des capacités informatiques de deux semaines qui a précédé la publication, La licence ne comporte aucune restriction d'utilisation acceptable, aucune exclusion relative au cyberespace ni aucune revendication de propriété sur les résultats. Les préoccupations en matière de sécurité ont influencé la décision de publication calendrier, et non la sortie conditions.
Alors, qu'est-ce qui relève encore du MIT, au juste ?
GLM-5.3-Flash. 320 milliards de paramètres, 18 milliards de paramètres actifs, multimodal de manière native, sous licence MIT, indice d’intelligence de 57,5, et $0,15/$0,50 par million de tokens — actuellement à moitié prix dans le cadre d’une offre promotionnelle valable jusqu’au 9 septembre 2026. Si vous recherchez une licence véritablement permissive et sans restriction, plutôt que de simples poids téléchargeables, c’est là que se situe actuellement la limite, et elle est remarquablement élevée.
Le résumé pratique
| Kimi K3 | GLM-5.3 | GLM-5.3-Flash | Fable 5.1 | |
|---|---|---|---|---|
| Poids à télécharger | Oui | Oui | Oui | Non |
| Open source de type OSI | Non | Non | Oui (MIT) | Non |
| Déclencheur de restriction | Chiffre d'affaires $20M (MaaS) | Chiffre d'affaires $10B (MaaS) | Aucun | N/A |
| Mention obligatoire | Plus de 100 millions d'utilisateurs actifs mensuels / $20M-mois | Avis de droits d'auteur uniquement | Avis de droits d'auteur uniquement | N/A |
| Réservé à un usage interne | Non | Non | Non | N/A |
| Ajustements autorisés | Oui | Oui | Oui | Non |
| Politique d'utilisation acceptable | Standard | Aucune mention dans le texte de la licence | Aucun | La politique d'utilisation acceptable (AUP) d'Anthropic s'applique |
Pour une entreprise allemande typique de la catégorie « Mittelstand », une agence ou un cabinet de conseil qui exploite des modèles en interne ou les intègre dans un produit : Ces trois options disponibles peuvent être utilisées sans avoir à négocier quoi que ce soit. Ces restrictions visent à protéger AWS, pas vous. Mais “ lisez la licence ” n’est plus seulement un conseil pointilleux, c’est désormais un conseil avisé : si votre chiffre d’affaires dépasse environ 20 millions d’euros et que vous revendez des services d’inférence sous quelque forme que ce soit, faites-la examiner par un avocat avant de la mettre en œuvre.
Les véritables arguments en faveur des modèles ouverts
Je souhaite développer cet argument de manière rigoureuse, plutôt que de m'en tenir à un simple slogan, car “ les modèles ouverts, c'est génial ” n'est pas un argument, et les véritables raisons sont bien plus intéressantes que les simples louanges.
1. L'effondrement des prix n'est pas une subvention, c'est un phénomène structurel
L'objection instinctive à l'égard des modèles chinois bon marché est que leur prix est fixé à un niveau déficitaire et qu'il finira par remonter. C'est certainement le cas dans une certaine mesure. Mais l'argument structurel reste valable en soi : Lorsque les poids sont publics, l'inférence se transforme en un marché de produits de base. Vingt hébergeurs se font concurrence pour proposer le même modèle, et aucun d’entre eux ne peut facturer un supplément lié à ses capacités, car aucun ne dispose d’un avantage concurrentiel en la matière. C'est pourquoi GLM-5.3 affiche des scores de $1,40/$4,40 et Fable 5.1 des scores de $10/$50, soit un écart de trois points.
La tarification selon le modèle fermé tient compte de l'amortissement des coûts de R&D, de la marge et du fait qu'il n'y a qu'un seul vendeur. La tarification selon le modèle ouvert inclut l'électricité, l'amortissement du matériel et une marge réduite. Il s'agit de deux activités différentes, et l'écart ne se comblera pas simplement parce que les modèles ouverts deviendront plus chers.
La preuve qu’il s’agit d’un phénomène réel et non pas temporaire : DeepSeek a capturé environ 17% d'utilisation de jetons sur Vercel d'ici mai 2026, tout en conservant environ 1% de part de revenus. Ce n'est pas une anomalie de prix. C'est à cela que ressemble la banalisation sur un graphique.
2. Les droits de sortie modifient votre position de négociation, même si vous ne les exercez jamais
La plupart des équipes qui liront ces lignes ne choisiront pas l’hébergement en interne. La section consacrée au matériel ci-dessous explique pourquoi : Kimi K3 nécessite un rack. Mais cette option présente tout de même un intérêt.
Si Anthropic augmente ses tarifs, rend obsolète le modèle sur lequel vous vous êtes appuyé, modifie sa politique d’utilisation acceptable d’une manière qui rend votre produit inutilisable, ou connaît un mauvais trimestre, votre seule solution avec un modèle fermé est de lancer un projet de migration. Avec un modèle à pondération ouverte, votre seule solution consiste à télécharger un fichier que vous auriez pu télécharger à tout moment. Vous ne le ferez peut-être jamais. Le fait que vous pourrait C'est ce qui fait que la relation avec le fournisseur relève du domaine commercial plutôt que d'une relation de dépendance.
Ce n'est pas une hypothèse théorique. La version 5.1 de Fable, déployée le 1er septembre, comporte trois changements majeurs, dont l'un rend les « thinking blocks » obsolètes lorsque vous modifiez l'historique des conversations pour les comptes créés après le 31 août. Si ce modèle est essentiel à votre architecture, vous devrez procéder à une refonte en fonction du calendrier d'Anthropic, et non du vôtre.
3. La localisation des données cesse d'être un projet
Pour toute entreprise soumise au RGPD, c'est cet argument qui permet réellement de conclure des contrats.
Avec une API fermée, chaque requête quitte votre infrastructure. Vous devez disposer d’un accord avec le sous-traitant, d’une analyse d’impact relative au transfert si celui-ci est situé en dehors de l’EEE, d’une cartographie des flux de données, ainsi que d’une réponse à fournir à votre délégué à la protection des données (DPO) concernant le sort des données au repos. Tout cela est faisable. Mais cela représente également plusieurs semaines de travail par fournisseur, et ce processus doit être répété chaque fois que le fournisseur apporte une modification.
Avec des ressources à capacité illimitée sur une infrastructure que vous contrôlez — votre propre matériel, ou un hébergeur de GPU allemand ou européen —, la question du transfert transfrontalier ne se pose pas, puisqu'il n'y a pas de transfert. Le modèle s'exécute là où vos données se trouvent déjà. L'examen juridique passe alors d'une évaluation du transfert à la lecture d'une licence.
Pour les clients allemands et européens, c'est souvent le facteur déterminant, et il convient d'être précis quant à cette réserve : L'utilisation de GLM-5.3 via l'API de Z.ai ne vous permet pas d'obtenir ce résultat. Vous l'obtenez soit en gérant vous-même les poids, soit par l'intermédiaire d'un prestataire qui les héberge sur votre territoire. La licence rend cette pratique légale ; elle ne la rend pas automatique.
4. L'inspectabilité est une réalité, même si elle est sous-exploitée
Les poids ouverts vous permettent d’examiner l’architecture, d’effectuer vos propres évaluations sur le modèle lui-même plutôt que sur un point final susceptible d’être mis à jour sans préavis, de le quantifier pour l’adapter à votre matériel, de le régler avec précision en fonction de votre domaine d’application et — surtout — épingler une version de manière définitive.
Ce dernier point est souvent sous-estimé. Les API fermées sont mises à jour derrière des identifiants de modèle stables. Le comportement évolue. Des prompts qui fonctionnaient cessent de fonctionner, et il est impossible de comparer les différences, car on ne peut pas les voir. Un point de contrôle local reste identique au niveau des octets, même un an plus tard.
5. La pression concurrentielle profite à tout le monde, y compris aux utilisateurs de modèles fermés
Regardez ce qui s'est passé cet été. Kimi K3 a atteint en juillet des scores de $3/$15, proches des limites. GLM-5.3 a atteint en août des scores de $1,40/$4,40, à moins d'un demi-point de ce résultat. Et le 1er septembre, Anthropic a réduit les lectures de cache de 75%.
Je ne prétends pas qu’il y ait un lien de causalité direct : Anthropic ne communique pas les raisons qui justifient ses tarifs, et la réduction des lectures en cache est une optimisation naturelle. Mais un marché où existent des substituts crédibles et bon marché s’avère différent d’un marché qui en est dépourvu, et ces substituts ont gagné en crédibilité cette année. Si vous utilisez exclusivement des modèles fermés, l’écosystème « open-weight » continue discrètement à réduire vos factures.
6. C'est après l'entraînement que l'on constate les progrès, et cela ne coûte pas cher
Le résultat phare du GLM-5.3 — une amélioration multipliée par six du Terminal-Bench à partir des mêmes poids de base — est le chiffre le plus important d'un point de vue stratégique dans tout cet article, et il ne concerne pas le GLM.
Selon lui, la partie la plus coûteuse de la construction d’un modèle de pointe (le pré-entraînement) est de plus en plus un élément banalisé et dont le coût est maîtrisé, tandis que la partie qui fait la différence (le post-entraînement, les environnements d’apprentissage par renforcement, la conception de tâches à long terme) est relativement abordable. C’est pourquoi quatre laboratoires chinois, dont la valorisation cumulée s’élève à environ $159 milliards, parviennent à rivaliser avec des laboratoires américains dont la valorisation est plusieurs fois supérieure. Selon l’analyse de Lambert, les laboratoires chinois fonctionnent avec “ des capitaux inférieurs de plusieurs ordres de grandeur ”.”
Pour tous ceux qui se trouvent en aval, la conséquence est claire : Le nombre de fournisseurs de modèles fiables augmente, il ne diminue pas. Concevez votre architecture en conséquence.
7. Les effets cumulés sur l'écosystème
Qwen est décédée un milliard de téléchargements cumulés sur Hugging Face, dépassant ainsi Llama, et héberge désormais plus de 200 000 modèles étiquetés et plus de 113 000 dérivés — soit environ 40% de tous les nouveaux dérivés LLM sur la plateforme sont basés sur Qwen. Il s'agit d'un écosystème d'outils, de quantification, de réglage fin et de déploiement qui n'existe que parce que les poids sont publics.
Vous profitez de cet écosystème, que vous y contribuiez ou non. Conversions GGUF, noyaux vLLM, adaptateurs LoRA, recettes de quantification, frameworks d’évaluation… Tout cela existe parce que des milliers de personnes ont pu accéder aux poids réels.
8. C'est là où les développeurs sont déjà allés
Les mannequins d'origine chinoise chez environ 61% de jetons OpenRouter. La part de marché des modèles américains a reculé, passant d’environ 70% à environ 30% en un an. Quatre des cinq modèles les plus utilisés sur le routeur sont d’origine chinoise. À eux seuls, les modèles MiMo de Xiaomi représentent environ 21% des jetons acheminés et environ 22% de l’ensemble du trafic de codage.
Le comportement des développeurs est un indicateur avancé. Il a été un indicateur avancé pour Docker, pour Postgres, pour Linux. Parier contre cette tendance n'a pas donné de bons résultats par le passé.
…Et les arguments honnêtes contre
Si je ne rédigeais que le paragraphe ci-dessus, cela ressemblerait à une publicité.
Les modèles de poids ouverts ne sont pas open source, et la dérive du vocabulaire constitue un véritable problème. Deux des trois modèles présentés ici sont proposés sous des licences sur mesure, subordonnées à des conditions de chiffre d’affaires, sans agrément de l’OSI. La clause relative à l’examen de sécurité de GLM-5.3 ne prévoit ni critères publiés ni procédure de recours. Si votre cadre de conformité exige des licences approuvées par l’OSI, la réponse honnête est que vos options se limitent à GLM-5.3-Flash, aux produits phares de DeepSeek sous licence MIT, et à une liste de plus en plus restreinte d’autres solutions.
Les tests comparatifs des fournisseurs restent des tests comparatifs des fournisseurs. Tous les chiffres phares publiés par Moonshot et Z.ai sont fournis et sélectionnés par les laboratoires eux-mêmes. Lorsque des agrégateurs neutres ont procédé à des mesures, ces chiffres se sont globalement confirmés — ce qui est véritablement tout à l’honneur des deux laboratoires — mais l’expression ’ se sont globalement confirmés “ revêt ici toute son importance.
L'auto-hébergement reste un rêve pour la plupart des équipes. Le Kimi K3 offre une capacité de 1,5 To et Moonshot recommande au moins 64 accélérateurs. Le GLM-5.3 nécessite au minimum 8 × H200 en FP8. La sortie à droite est bien réelle ; le coût de l'opération correspond à celui d'un centre de données.
Le soutien, c'est ce que vous en faites. Lorsque Fable 5.1 tombe en panne, il existe une entreprise qui propose un contrat de niveau de service (SLA). Lorsque votre déploiement GLM-5.3 auto-hébergé génère des données erronées à 300 000 contextes un vendredi soir, il y a un ticket GitHub et votre propre compétence.
La géopolitique est un véritable facteur à prendre en compte dans les achats. Les trois options « open-weight » évoquées ici proviennent toutes de laboratoires chinois. Pour certains clients — le secteur public, les secteurs liés à la défense, certaines industries réglementées —, cela constitue un obstacle majeur, quelles que soient les conditions de licence ou la répartition des pondérations. Ce n'est pas à moi de vous dire si cette préoccupation est fondée. Mon rôle est de vous signaler qu'elle sera soulevée lors de la réunion.
Les modèles fermés restent en tête dans le domaine du travail intellectuel général. GDPval-AA v2 affiche un score de 1 853 pour Fable 5.1, contre 1 769 pour GLM-5.3 et 1 687 pour Kimi K3. En matière de codage, l'écart a disparu. En revanche, cela n'est pas le cas pour les tâches professionnelles générales nécessitant des connaissances spécialisées.
Afficher l'image Poids téléchargeables, trois jeux de cordes différents. Seul GLM-5.3-Flash est encore sous licence MIT.
Ollama en 2026 : le changement tarifaire qui compte vraiment
Ollama est discrètement devenu l'élément d'infrastructure le plus important dans ce débat, et sur 31 août 2026 le mode de facturation a évolué d'une manière qu'il vaut la peine de bien comprendre.
Qu'est-ce qui a changé ?
Ollama est passé, pour ses formules Pro, Max et Team, d'une facturation au temps d'utilisation du GPU à une tarification par jeton conforme aux normes du secteur, avec un contingent de crédits d'utilisation inclus dans chaque forfait. La raison invoquée par l’entreprise est d’une concision rafraîchissante : des modèles comme Kimi K3 rendaient les indicateurs de temps d’utilisation du GPU impossibles à prévoir. Lorsqu’un modèle mobilise 104 milliards de paramètres et qu’un autre n’en mobilise que 3 milliards, “ une heure de GPU ” ne signifie plus rien pour celui qui paie.
Les nouveaux projets
| Plan | Prix | Forfait mensuel inclus | Concurrence |
|---|---|---|---|
| Gratuit | $0 | Petit crédit mensuel, modèles d'entrée de gamme | 1 demande |
| Pro | $20/mois (ou $200/an) | $60 d'utilisation | 3 demandes |
| Max | 1 TP4T100/mois | $300 d'utilisation | 10 demandes |
| Équipe | 1 TP 4 T 500/mois | $1 000 partagés, nombre d'utilisateurs illimité | 10 demandes |
| Entreprise | Personnalisé | Personnalisé | Personnalisé |
Relisez la ligne « Pro ». $20 achète $60 de jetons. Cela correspond à un multiplicateur de 3 sur le volume d'utilisation inclus, et lorsque le quota est épuisé, vous continuez à bénéficier exactement du même tarif par jeton que celui annoncé — sans pénalité ni frais de service.
Ce qui a été supprimé
Voici ce que les développeurs ont réellement remarqué : Pas de réinitialisation toutes les 5 heures ni de plafond hebdomadaire. Quiconque s'est déjà retrouvé confronté à une fenêtre d'utilisation glissante en plein milieu d'une refonte comprendra pourquoi cela importait davantage que le prix. Le quota mensuel est réinitialisé à la date de renouvellement de votre abonnement et, surtout, ne se renverse pas — Adaptez donc votre budget à un mois type, et non à votre mois le plus chargé.
Les termes essentiels pour le travail au sein de l'UE
Trois engagements mentionnés dans cette annonce vous concernent directement si vous traitez des données de clients :
- Aucune conservation des données. Les requêtes et les réponses ne sont jamais enregistrées et ne servent jamais à l'entraînement du modèle.
- Hébergement aux États-Unis et en Europe, ainsi qu'à Singapour pour une gamme limitée de modèles Qwen.
- Visibilité sur le coût par demande dans votre compte : vous pouvez voir exactement combien a coûté chaque appel.
Pour un cabinet de conseil allemand, cela représente un niveau de conformité nettement supérieur à celui offert par la plupart des fournisseurs de passerelles, même si la mention “ hébergé en Europe ” relève davantage d'une indication d'acheminement que d'une garantie contractuelle quant à la localisation des données. Si la localisation des données est une exigence impérative et non une simple préférence, demandez confirmation par écrit à Ollama avant de la considérer comme acquise.
Les taux réels par jeton
C'est là que ça devient intéressant. Ollama publie ses tarifs par modèle et suit de près les prix pratiqués par les marques elles-mêmes :
| Modèle sur Ollama | Entrée / 1M | En cache / 1M | Sortie / 1M |
|---|---|---|---|
kimi-k3 | $3.00 | $0.30 | $15.00 |
glm-5.3 | $1.40 | $0.26 | $4.40 |
mistral-large-3 | $0.50 | $0.50 | $1.50 |
gemma4 | $0.14 | $0.05 | $0.40 |
nemotron-3-super | $0.015 | $0.015 | $0.60 |
Appliquez à cela les calculs mensuels effectués précédemment. Quatre-vingts exécutions « agentic » par mois sur GLM-5.3 coûtent environ $148 en jetons. A Le forfait Max à $100 par mois couvre une consommation de $300 — ainsi, la même charge de travail qui coûterait environ $955 par mois sur Fable 5.1 s'intègre parfaitement dans un abonnement Ollama $100, tout en laissant une marge de manœuvre suffisante.
C'est tout l'argument économique en faveur du modèle ouvert résumé en une seule ligne sur une facture.
Afficher l'image Quatre-vingts exécutions « agentic » par mois sur GLM-5.3 tiennent dans un forfait Ollama Max $100, avec un peu de marge. Le même travail sur Fable 5.1 correspond à une facture de $955.
Quels autres produits Ollama a-t-elle commercialisés en 2026 ?
Ce changement de tarification ne s'est pas produit de manière isolée. Ces derniers mois ont été bien remplis :
- 25 août — Assistance technique pour Claude Desktop. Ollama intervient désormais en tant que fournisseur tiers de passerelles pour Claude Desktop, ce qui vous permet d'utiliser des modèles ouverts via le client d'Anthropic.
- 26 août — v0.33.0. L'intégration de la passerelle Claude Desktop a été mise en place, la récupération des champs préremplis a été rétablie dans le cache, et Ollama a désactivé le message du système de compte à rebours des jetons de Claude Code, qui invalidait le cache KV à chaque tour. Cette dernière modification constitue une correction discrète mais importante en termes de performances.
- 26 août — v0.33.1. Prise en charge de MLX pour Qwen 3.8 : Flash Next, sortie structurée et correction des délais d'expiration du GPU lors du chargement de modèles à partir d'un support de stockage plus lent.
- 28 août — v0.33.2. Le mode sombre a été rétabli, le problème lié à Handoff sous macOS a été corrigé et les requêtes proxy de Claude Desktop sont désormais maintenues actives pendant les mises à jour du catalogue de modèles.
- 20 août — v0.32.15. Nouvelle procédure d'intégration pour les ordinateurs de bureau et mise en cache des métadonnées entre les requêtes qui réduire de près de moitié le temps nécessaire pour obtenir le premier jeton.
- 11 août — NVIDIA Nemotron 3.5 Lightning, un modèle 30B optimisé pour les flux de travail agentiques avec appel d'outils sur du matériel personnel.
- 10 août — Muse Glimmer de Meta, un modèle multimodal 30B dans le cadre de Apache 2.0, optimisé par le moteur MLX d'Ollama. Il convient de noter, compte tenu de l'effondrement de l'utilisation de Llama dans les réseaux de routage, que Meta continue de proposer des modèles véritablement permissifs.
- 9 juillet — Tour de table $88M, selon Ollama 8,9 millions de développeurs.
- 29 juin — Gemma 4 sur MLX atteint 90% plus rapidement grâce à la prédiction multi-token, qui profite de manière disproportionnée aux agents de codage fonctionnant sur Apple Silicon.
- 5 juin — La version 0.30 a ajouté la compatibilité avec GGUF grâce à lama.cpp, ce qui élargit la prise en charge matérielle bien au-delà d’Apple Silicon.
En résumé, Ollama n'est plus “ la solution simple pour exécuter un petit modèle sur votre ordinateur portable ”, mais est devenu une passerelle polyvalente qui permet également d'exécuter des modèles en local. Le catalogue cloud comprend désormais kimi-k3:cloud, glm-5.3 : cloud, glm-5.3-flash, deepseek-v4-pro, deepseek-v4-flash, minimax-m3, qwen3.5 disponible en sept tailles, gpt-oss aux points 20b et 120b, gemma4, la gamme Nemotron 3 et mistral-large-3.
Tout mettre en place : copier-coller les fichiers de configuration
Ollama + Claude Code (le chemin le plus rapide)
Ollama fournit un lanceur à commande unique qui se charge pour vous de la configuration de l'environnement :
bash
Lancement d'Ollama ClaudeSi vous préférez le faire manuellement — ce que vous devriez faire si vous utilisez un script —, installez d'abord Claude Code :
bash
# macOS / Linux
curl -fsSL https://claude.ai/install.sh | bash

# Windows (PowerShell)
irm https://claude.ai/install.ps1 | iex
Puis dirige-le vers Ollama :
bash
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
Et exécutez-le avec le modèle de votre choix :
bash
# Un modèle local
claude --model qwen3.5

# Un modèle en cloud — notez le suffixe :cloud
claude --model kimi-k3:cloud
Ou en ligne, sans rien exporter au niveau global :
bash
ANTHROPIC_AUTH_TOKEN=ollama \
ANTHROPIC_API_KEY="" \
ANTHROPIC_BASE_URL=http://localhost:11434 \
claude --model glm-5.3:cloud
Deux choses qui vont te jouer des tours.
Tout d'abord, ne pas exporter ANTHROPIC_BASE_URL de manière permanente dans votre profil de shell. Il s'agit d'une variable globale qui redirigera automatiquement tous les outils utilisant l'interface Anthropic installés sur votre ordinateur vers Ollama, y compris celui que vous souhaitiez faire communiquer avec Anthropic. Vous pouvez définir sa portée au niveau d'un projet ou d'une invocation.
Deuxièmement, Réglez la longueur de votre contexte sur 64 ko ou plus pour tout ce qui fonctionne sur un véritable dépôt. La valeur par défaut d’Ollama est plus petite, et un agent de codage qui s’exécute discrètement en arrière-plan finira simplement par oublier des éléments plutôt que de générer des erreurs.
Pour les exécutions en CI, avec Docker ou via des scripts, --oui ignore les invites interactives :
bash
ollama launch claude --model glm-5.3:cloud --yes -- -p "Comment fonctionne ce dépôt ?"GLM-5.3, directement depuis Z.ai
Si vous préférez un routage en propre plutôt que de passer par Ollama, Z.ai met à disposition trois points de terminaison de protocole :
| Protocole | URL de base |
|---|---|
| Messages anthropiques | https://api.z.ai/api/anthropic |
| Compléments de conversation OpenAI | https://api.z.ai/api/coding/paas/v4 |
| Réponses d'OpenAI | https://api.z.ai/api/v1 |
Un bloc de fournisseur OpenCode pour GLM-5.3 :
json
{
  "$schema" : "https://opencode.ai/config.json",
  "provider": {
    "zai": {
 "npm": "@ai-sdk/openai-compatible",
 "name": "Z.AI",
      "options": {
 "baseURL": "https://api.z.ai/api/coding/paas/v4",
 "apiKey": "{env:ZAI_API_KEY}"
      },
 "models": {
 "glm-5.3": {
 "name": "GLM-5.3",
          "limit": { "context": 1000000, "output": 128000 },
 "options": { "reasoning_effort": "high", "temperature": 1 }
        }
 }
    }
  },
  "model": "zai/glm-5.3"
}
Remarque importante concernant la mise à jour : GLM-5.3 nécessite que le raisonnement soit activé. Si votre configuration actuelle définit thinking.type : " disabled ", cela ne fonctionnera plus. Remplacez-le par " activé " et définir effort_de_raisonnement : " faible " si vous souhaitez retrouver l'ancien profil de latence.
effort_de_raisonnement C'est votre principal critère de choix entre qualité et prix : faible pour les appels où la latence est un facteur critique, élevé pour un travail de grande envergure, max (par défaut) pour les problèmes qui se sont avérés véritablement insolubles élevé. Compte tenu de la verbosité constatée, je lancerais élevé comme cadre de la vie quotidienne plutôt que de partir max et je me demandais où étaient passés les jetons de sortie.
La configuration de routage que je recommanderais vraiment
Il ne s'agit en aucun cas d'un choix “ à l'exclusion de l'autre ”. La solution la plus adaptée pour la plupart des équipes est une table de routage à trois niveaux, et tout système de gestion d'agents digne de ce nom prend en charge les modèles par agent.
json
{
  "$schema" : "https://opencode.ai/config.json",
  "model" : "zai/glm-5.3",
  "small_model" : "ollama/gemma4",
  "agent": {
    "plan": {
 "description": "Architecture, analyse des causes profondes, tout ce qui coûte cher en cas d’erreur",
 "model": "anthropic/claude-fable-5-1"
    },
    "build" : {
 "description" : "L'essentiel du travail de mise en œuvre",
 "model" : "zai/glm-5.3",
 "options" : { "reasoning_effort" : "high" }
    },
    "research" : {
 "description" : "Lecture de textes longs, recherche sur le Web, synthèse à partir de sources multiples",
 "model" : "ollama/kimi-k3:cloud"
    },
    "grunt" : {
 "description" : "Renommage, chaînes de documentation, création de tests, corrections de lint",
 "model" : "ollama/glm-5.3-flash"
    }
  }
}
Le raisonnement qui sous-tend chaque ligne :
- Planning passe à la version 5.1 de Fable. C'est lors de la phase de planification qu'une mauvaise décision vous coûte le plus de jetons en aval, et la cohérence à long terme est précisément la raison d'être de la version 5.1. C'est également à ce stade que vous dépensez le moins de jetons ; la majoration de prix ne s'applique donc qu'à la plus petite partie de votre facture.
- Le bâtiment est équipé du GLM-5.3. Le meilleur rapport performances/prix du marché, et c'est là que se concentre l'essentiel de vos dépenses en jetons.
- Le département de recherche se dote de la Kimi K3. BrowseComp 91.2, associé à un contexte 1M authentique, en fait la meilleure option disponible pour lire de nombreux contenus et en faire la synthèse.
- Le département de mécanique adopte GLM-5.3-Flash. Avec $0.15/$0.50, c'est pratiquement gratuit, et renommer un symbole dans 40 fichiers ne nécessite pas de raisonnement complexe.
petit_modèletrouve quelque chose de tout petit pour la gestion interne du harnais : génération de titres, résumé, appels aux utilitaires internes.
Vous ne choisissez pas un gagnant. Vous concevez un boîtier de vitesses. Et rédigez les identifiants des modèles de manière à ce que le remplacement de l'un d'entre eux ne nécessite qu'une seule ligne de modification, car sur ce marché, vous devrez effectuer cette modification à nouveau avant la fin du trimestre.
Ce que vous pouvez réellement faire tourner en local (la réalité matérielle)
Je vais tordre le cou à une idée reçue avant qu’elle ne coûte de l’argent à quelqu’un.
Il est impossible d'exécuter Kimi K3 ou GLM-5.3 sur une station de travail. Ni avec une 5090, ni même avec deux.
Kimi K3
- environ 1,5 To des poids dans le format natif MXFP4 — et n'oubliez pas que est le point de contrôle quantifié, et non un point de départ pour une compression supplémentaire
- Moonshot recommande au moins 64 accélérateurs pour un service de haut niveau
- Pour un auto-hébergement réellement viable, il faut commencer par des clusters à plusieurs nœuds ; les déploiements de référence utilisent des racks GB300 NVL72.
- Il y a aucune entrée officielle dans la bibliothèque Ollama pour la Kimi K3 locale, et aucune conversion GGUF grand public qui mérite d'être mentionnée
- On rapporte qu'il fonctionne sur des clusters de cartes RTX 5090 grand public, mais “ un cluster de 5090 ” n'est pas un ordinateur portable et le débit n'est pas comparable
GLM-5.3
- Environ 1,5 To dans BF16, environ 750 Go à FP8
- Nœud unique minimal viable : 8 × H200 (1 128 Go de mémoire GPU) à FP8, ce qui laisse environ 375 Go pour le cache KV
- BF16 nécessite deux nœuds 8×H200 ou un seul nœud 8×B300 (2 304 Go)
- Un seul nœud 8×H200 dans BF16 est trop petit pour contenir à la fois les poids et le cache
Afficher l'image Les modèles Frontier Open nécessitent un rack. C'est au niveau de la capacité de 24 Go que la fonctionnalité “ fonctionne sur ma machine ” prend tout son sens — et elle est désormais très performante.
Alors, que signifie réellement “ IA locale ” en septembre 2026 ?
Cela correspond à une nouvelle gamme de modèles, et cette gamme est vraiment très réussie :
| Modèle | VRAM | À quoi ça sert ? |
|---|---|---|
| Qwen3.8-27B | 24 Go au quatrième trimestre | Meilleure polyvalence sur matériel grand public — 61,71 TP3T SWE-bench |
| gpt-oss:20b | 16 Go | Meilleur petit modèle, effort de raisonnement ajustable |
| Gemma 4 E4B | environ 6 Go | L'outil Vision Plus fonctionnant sur un ordinateur portable moderne |
| Mistral 7B | 8 Go | Option polyvalente la plus rapide, 40 à 60 tok/sec |
| DeepSeek-R1 7B | 5 Go | Raisonnement par chaîne de pensées sur le GPU d'un ordinateur portable |
| Llama 4 Scout | environ 55 Go au quatrième trimestre | Contexte 10M, multimodal — le domaine des stations de travail |
Un Qwen3.8-27B totalisant 61,71 TP3T au test SWE-bench, fonctionnant exclusivement sur un GPU grand public de 24 Go sans aucune connexion réseau, est un exploit remarquable qui aurait semblé relever de la science-fiction il y a dix-huit mois. Il ne s’agit pas de GLM-5.3 et il ne prétend pas l’être.
Le cadre honnête : Les cours ouverts à la frontière vous permettent d'acheter souveraineté et prix, et non exécution locale. Les poids ouverts compris entre 7B et 30B vous offrent une exécution locale authentique, à un coût de capacité réel mais acceptable, et c’est dans cette gamme que l’exigence “ ça fonctionne sur ma machine, sans voir le réseau ” devient réalisable.
L'architecture qui convient à la plupart de mes clients repose précisément sur cette distinction : un petit modèle local pour tout ce qui concerne des données véritablement sensibles, et un modèle « frontier » hébergé à poids ouvert pour tout le reste — les poids étant disponibles à titre de sécurité plutôt que dans le cadre d'un plan de déploiement.
Où chaque modèle présente réellement des failles
Sans exagération. Voici les faiblesses, en toute honnêteté.
Les points faibles de la Kimi K3
C'est cher pour un modèle ouvert. $3/$15 offre un débit d'entrée 2,1 fois supérieur et un débit de sortie 3,4 fois supérieur à ceux du GLM-5.3, pour un score d'indice d'intelligence pratiquement identique. Si vous préférez le K3 au GLM-5.3, assurez-vous de bien comprendre ce que vous obtenez en plus pour ce surcoût — il s’agit généralement de la pile de traitement de l’image ou des performances de navigation.
C'est la licence qui a le seuil d'accès le plus bas. Un seuil MaaS basé sur le chiffre d'affaires total de $20M concerne bien plus d'organisations que celui de $10B prévu par la norme GLM-5.3. Si la revente de services d'inférence fait partie de votre modèle économique, la norme K3 est la plus restrictive des deux.
L'auto-hébergement est hors de portée pour presque tout le monde. 1,5 To et plus de 64 accélérateurs représentent un engagement considérable en matière d'infrastructure. Le droit de sortie revêt ici un caractère plus théorique que dans n'importe quel autre modèle de cette comparaison.
De vastes parcours professionnels dans le domaine du savoir. Avec un score de 1 687 au GDPval-AA v2, il se classe derrière le GLM-5.3, ainsi que derrière Claude Fables et GPT-5.6 Sol Max. C'est un spécialiste du codage et de l'agentique qui se trouve être gigantesque.
Faiblesses du GLM-5.3
Texte uniquement. Sans image d'entrée, pas de vidéo. Si votre flux de travail inclut le débogage par captures d'écran, la conversion de conception en code ou la reconnaissance d'images de documents, le GLM-5.3 n'est tout simplement pas en mesure de le faire et vous devrez plutôt utiliser le GLM-5.3-Flash, le Kimi K3 ou le Fable 5.1. C'est l'erreur de configuration la plus courante que les utilisateurs risquent de commettre, car les identifiants de modèle semblent similaires alors qu'ils ne le sont pas.
C'est trop détaillé, et ces détails sont facturés. 170 millions de jetons émis, contre une médiane de 72 millions pour l'ensemble de la suite AA. effort_de_raisonnement La valeur par défaut est max, et on ne peut pas « éteindre » la réflexion. Prévoyez davantage de jetons de production que ne le laisse supposer le nombre de vos tours.
La licence n'est plus la licence MIT, et la clause relative à l'examen de sécurité n'est plus soumise à aucune restriction. Pour la plupart des lecteurs, le seuil de $10B rend cette question purement théorique. Pour quiconque s'en approche, la clause stipulant que “ le champ d'application et la méthode seront déterminés de manière raisonnable par Z.AI ” ne fera certainement pas le bonheur de votre équipe juridique.
Avec un score de 28,3 au test Terminal-Bench 3.0, il est en retrait par rapport au GPT-5.6 Sol, qui affiche un score de 34,6. Sur le benchmark spécifique le plus proche du codage agentique natif du terminal, il se classe derrière ses concurrents directs sur cette même échelle.
C'est une nouveauté dans la catégorie des poids libres. Sortie le 28 août. La communauté n'a eu que quelques jours, et non des mois, pour s'y familiariser. Les bugs de déploiement à long terme ne se sont pas encore manifestés.
Points faibles de Claude Fable 5.1
Le prix. Environ 6,5 fois le GLM-5.3 par tâche agentique accomplie, même après le seuil de 75% pour les lectures en cache. Pour la plupart des travaux, cet écart n'est plus justifiable au regard des capacités.
Trois modifications ayant un impact sur la compatibilité ascendante. L'utilisation forcée d'un outil renvoie le code d'erreur 400. Les « thinking blocks » ne sont pas compatibles avec les versions antérieures. La modification de l'historique des conversations invalide les « thinking blocks » sur les comptes créés après le 31 août 2026. N'importe lequel de ces éléments peut perturber le bon fonctionnement de l'intégration lors d'une mise à jour.
L'appel parallèle des outils a régressé. Selon certaines informations, il n'y aurait qu'un seul appel par tour, alors que Fable 5 en regroupait plusieurs. Sur une longue boucle d'agent, cela revient à payer deux fois le temps réel.
Optionnalité de sortie nulle. Pas de pondération, pas d'auto-hébergement, pas de verrouillage de version au-delà de ce qu'offre Anthropic, pas d'inspection. Quand ça change, il faut s'adapter.
Le tokeniseur amplifie les comparaisons. ~30% de jetons de plus que les anciens modèles Claude pour un même texte, ce qui rend les comparaisons historiques de coûts trompeuses en faveur d'Anthropic si l'on n'y prend pas garde.
Le cadre décisionnel : six scénarios
Afficher l'image Six scénarios, six réponses. Trouvez la ligne qui correspond le mieux à votre semaine.
1. “ Je veux un seul modèle. Je le configure, je n’y pense plus, et la facture reste raisonnable. ”
GLM-5.3. À moins d'un demi-point de Kimi K3 et à environ trois points du meilleur modèle fermé sur l'indice neutre, à $1,40/$4,40. Lancez le calcul sur Ollama avec un abonnement Pro ou Max, puis définissez effort_de_raisonnement : élevé, et reprenez votre travail. La seule raison qui pourrait vous faire renoncer à cette solution serait le besoin d'une entrée sous forme d'image.
2. “ Mon travail est d'ordre visuel : interface utilisateur, passage de la conception au code, débogage à partir de captures d'écran, documentation. ”
Kimi K3 ou GLM-5.3-Flash, et non GLM-5.3. Le MoonViT-V2 de K3 gère nativement le texte, les images et la vidéo, et obtient un score de 81,6/83,4 au test MMMU-Pro. Le GLM-5.3-Flash est l’option économique, offrant une multimodalité native et une licence MIT. Le GLM-5.3 est réservé au texte et refusera tout simplement les entrées d’un autre type.
3. “ De longues sessions autonomes où se tromper coûte cher. ”
Claude Fable 5.1. C'est précisément pour cela qu'il a été conçu, et les tests de performance le confirment : Terminal-Bench-Science a doublé son score, atteignant 821 TP3T sur les tâches informatiques les plus exigeantes de Browserbase, contre 741 TP3T pour l'Opus 5, et affiche les gains les plus importants jamais publiés en matière de travail agentique s'étalant sur plusieurs heures. La réduction de 751 TP3T au niveau de la lecture du cache rend précisément cette charge de travail jusqu’à 451 TP3T moins coûteuse qu’auparavant. Il faut payer le supplément là où une erreur coûte plus cher que les jetons.
4. “ La localisation des données au sein de l'UE est une exigence impérative. ”
GLM-5.3-Flash si vous avez besoin du MIT, GLM-5.3 si vous avez besoin de performances. Optez pour l’auto-hébergement sur votre propre matériel ou chez un fournisseur de GPU basé dans l’UE, et la question du transfert transfrontalier ne se posera plus. Prévoyez un budget de 8×H200 pour le GLM-5.3 en FP8 ; Flash est bien plus abordable, avec 320B/18B. Si l’auto-hébergement dépasse votre budget, l’hébergement européen d’Ollama, sans aucune conservation des données, constitue un compromis pragmatique — mais veillez à obtenir l’engagement de résidence par écrit plutôt que de le déduire d’une page marketing.
5. “ Une petite équipe, un budget serré, et on code toute la journée. ”
GLM-5.3-Flash par défaut, GLM-5.3 pour les problèmes difficiles, Ollama Pro en configuration $20. Flash coûte $0,15/$0,50 — actuellement la moitié de ce prix jusqu'au 9 septembre — et affiche un score de 57,5 à l'indice d'intelligence. Vingt dollars permettent d'acheter soixante dollars de jetons, sans plafond hebdomadaire. Pour une équipe de deux à quatre personnes, c'est une offre pratiquement imbattable. Le forfait GLM Coding Plan à $18/mois (Lite) constitue une alternative si vous préférez un quota fixe à un pool de crédits.
6. “ Je dois justifier cela auprès d'une équipe chargée des achats ou d'une équipe juridique. ”
GLM-5.3-Flash. C'est le seul modèle de ce comparatif soumis à une licence standard approuvée par l'OSI (MIT) ; il est multimodal de manière native, obtient un score de 57,5 sur l'indice de neutralité, et ses poids sont disponibles sur Hugging Face sans condition de revenus, sans obligation d'attribution et sans clause de contrôle de sécurité. Lorsqu’il s’agit de déterminer “ ce que l’on peut défendre lors d’un examen contractuel ”, les licences permissives l’emportent à chaque fois de trois points sur la référence.
Ce que je vais suivre au cours du prochain trimestre
Fable 5.1 se classera-t-il au-dessus de 62,1 dans l'indice Artificial Analysis ?. Il a été lancé la veille de la publication de cet article et n’a pas encore fait l’objet d’une évaluation indépendante. Ses écarts par rapport à Fable 5 dans les tests de performance laissent penser qu’il devrait l’être, mais “ devrait ” ne signifie pas “ l’a été ”, et l’écart par rapport aux 59,7 de Kimi K3 est le chiffre autour duquel s’articule tout le débat entre les systèmes ouverts et fermés.
La dérive des licences va-t-elle se poursuivre ?. En huit semaines, nous sommes passés du GLM-5.2 sous licence MIT au GLM-5.3 sous une licence sur mesure assortie d’un examen de sécurité discrétionnaire, et du MIT modifié de Kimi K2 aux conditions liées au chiffre d’affaires de K3. Si le GLM-6 et le K4 se durcissent encore davantage, le terme ’ open weights ’ deviendra un argument marketing plutôt qu’une catégorie à part entière. Le fait que le GLM-5.3-Flash reste sous licence MIT constitue un contre-signal qu’il convient de suivre de près.
Reste à voir si d'autres laboratoires adopteront le modèle de lancement progressif de Z.ai. Un délai de deux semaines, accompagné d'une justification publiée en matière de sécurité, est devenu la nouvelle norme. Si ce délai est respecté, c'est une bonne chose. S'il devient un prétexte pour retarder sans cesse l'expédition des poids, cela ouvre la voie à leur non-livraison pure et simple.
Vérification indépendante des affirmations relatives aux capacités cybernétiques. 2 436 vulnérabilités réparties sur 269 projets, c'est un chiffre extraordinaire, et il s'agit exclusivement de signalements spontanés. Il faudrait qu'un observateur neutre vérifie ces données, car si elles sont exactes, cela redéfinit complètement le débat sur la sécurité des systèmes « open-weights » ; si elles ne le sont pas, il s'agit alors d'une campagne marketing efficace.
Les cours par jeton d'Ollama dans six mois. Le rapport $20 pour $60 d'utilisation constitue une stratégie de lancement agressive de la part d'une entreprise qui a levé $88M en juillet. La question de savoir si ces multiplicateurs résisteront à la réalité économique des unités constitue la principale variable de la thèse des “ modèles ouverts à bas coût ” pour les petites équipes.
Les modèles locaux se situent-ils autour du niveau 30B ?. Le résultat « Qwen3.8-27B à 61,71 TP3T sur SWE-bench avec 24 Go de mémoire » est le résultat le moins commenté de l'année. C'est la « frontier » qui fait la une des journaux ; or, c'est justement le niveau de 24 Go qui change la donne pour une entreprise lambda, sans qu'elle ait besoin d'une clé API.
Foire aux questions
Kimi K3 est-il vraiment open source ? Non. Les poids de Kimi K3 peuvent être téléchargés gratuitement sur Hugging Face, mais ils sont soumis à une ’ licence Kimi K3 “ personnalisée, et non à une licence open source approuvée par l’OSI. Les opérateurs de ” Model-as-a-Service “ dont le chiffre d’affaires cumulé dépasse $20 millions au cours de n’importe quelle période de 12 mois consécutifs doivent négocier un accord commercial distinct avec Moonshot, et les produits comptant plus de 100 millions d’utilisateurs actifs par mois ou générant un chiffre d’affaires mensuel supérieur à $20 millions doivent afficher la mention ” Kimi K3 » dans leur interface. L’utilisation strictement interne n’est soumise à aucune restriction.
Le GLM-5.3 est-il meilleur que le Kimi K3 ? Ils sont pratiquement à égalité sur l’indice agrégé neutre : 59,5 contre 59,7 selon Artificial Analysis. Le GLM-5.3 est 2,2 fois moins cher par tâche agentique et obtient un meilleur score en matière de travail intellectuel (GDPval-AA v2 : 1 769 contre 1 687). Kimi K3 est multimodal de par sa conception, domine la navigation agentique (BrowseComp 91,2) et a remporté la première place dans l’épreuve de codage front-end organisée par Arena.AI. Optez pour le GLM-5.3 pour le rapport coût-performance et le codage basé sur le texte ; choisissez Kimi K3 pour la vision, la navigation et la recherche à long terme.
De combien les modèles ouverts sont-ils moins chers que le Claude Fable 5.1 ? Sur une tâche agentique modélisée de 60 tours, GLM-5.3 coûte environ $1,85 contre $11,94 pour Fable 5.1 — soit environ 6,5 fois moins cher. Kimi K3 coûte environ $4,07, soit environ 2,9 fois moins cher. GLM-5.3-Flash coûte environ $0,21, soit environ 58 fois moins cher. Plus de 80 exécutions par mois, soit $148 contre $955.
Puis-je exécuter Kimi K3 ou GLM-5.3 en local ? Pas sur du matériel grand public. Kimi K3 pèse environ 1,5 To, même dans son format natif MXFP4, et Moonshot recommande au moins 64 accélérateurs. GLM-5.3 nécessite au minimum 8×H200 (1 128 Go) en FP8. Pour une véritable exécution locale, tournez-vous vers Qwen3.8-27B (24 Go en Q4), gpt-oss:20b (16 Go) ou Gemma 4 E4B (~6 Go).
Quelles sont les nouveautés de Claude Fable 5.1 ? Publié le 1er septembre 2026. Les lectures en cache ont diminué de 751 TP3T, passant de 1 TP4T1,00 à 1 TP4T0,25 par million de jetons, ce qui rend les charges de travail typiques environ 251 TP3T moins coûteuses et les charges de travail « agentic » jusqu’à 451 TP3T moins coûteuses ; les coûts d’entrée et de sortie sont restés à $10/$50. Le score Terminal-Bench 4.0 est passé de 42,01 TP3T à 55,81 TP3T, Terminal-Bench-Science de 24,71 TP3T à 52,61 TP3T, et AutomationBench de 17,11 TP3T à 31,41 TP3T. Trois modifications majeures affectent l’utilisation forcée des outils, la portabilité des blocs de réflexion et l’édition de l’historique.
Quelles sont les nouvelles tarifs d'Ollama ? À compter du 31 août 2026, les formules Pro, Max et Team adopteront une tarification au token avec des crédits inclus : Pro : 1 TP4T20/mois pour une utilisation de 1 TP4T60 ; Max : 1 TP4T100 pour 1 TP4T300 ; Team : 1 TP4T500 pour 1 TP4T1 000 partagé entre un nombre illimité d'utilisateurs. Les plafonds de 5 heures et hebdomadaires ont été entièrement supprimés, il n'y a pas de frais de service, les crédits ne sont pas reportés, et tous les forfaits ne prévoient aucune conservation des données, avec un hébergement aux États-Unis et en Europe.
Lequel de ces modèles est réellement sous licence MIT ? Seul GLM-5.3-Flash — un modèle multimodal natif 320B/18B distinct, publié le 26 août 2026, a obtenu un score de 57,5 sur l’indice Artificial Analysis à $0,15/$0,50 par million de jetons. GLM-5.3 et Kimi K3 utilisent tous deux des licences sur mesure liées au chiffre d'affaires ; Claude Fable 5.1 est entièrement propriétaire.
Pourquoi ne puis-je pas comparer ces modèles sur Terminal-Bench ? En effet, chacune d'entre elles a été évaluée sur une version différente. Le score de 88,3 de Kimi K3 a été obtenu avec Terminal-Bench 2.1, celui de 28,3 de GLM-5.3 avec la version 3.0, et celui de 55,8 de Fable 5.1 avec la version 4.0. Chaque version est nettement plus difficile que la précédente, les chiffres ne sont donc pas comparables. Ne comparez qu’au sein d’une même version. Sur Terminal-Bench 2.1, par exemple, Kimi K3 obtient un score de 88,3 contre 88,0 pour Claude Fable 5, 88,8 pour GPT-5.6 Sol et 84,3 pour GLM-5.3-Flash — cette comparaison est valable, et c’est celle qui mérite d’être citée.
Dois-je passer par Ollama ou m'adresser directement au fournisseur ? Optez pour Ollama si vous recherchez une relation de facturation unique, une interface API unique, un changement de modèle simplifié et un hébergement en UE ou aux États-Unis sans aucune conservation des données — ses tarifs par jeton suivent de près ceux des services propriétaires. Optez pour Direct si vous avez besoin de fonctionnalités propres aux services propriétaires, comme celles de Z.ai. effort_de_raisonnement des contrôles en haute fidélité, des accords de niveau de service (SLA) des fournisseurs ou des formules d'abonnement telles que le « GLM Coding Plan ». De nombreuses équipes utilisent les deux et effectuent l'acheminement en fonction de la charge de travail.
GLM-5.3 prend-il en charge les images ? Non. GLM-5.3 est un modèle exclusivement textuel. GLM-5.3-Flash — un modèle totalement différent malgré un nom similaire — est multimodal de par nature et prend en charge les entrées de texte, d’images, de vidéos et de fichiers. L’envoi d’images à un identifiant de modèle incorrect est l’erreur la plus courante commise par les débutants avec la famille GLM.
En résumé
Il y a douze mois, la question qui se posait concernant la catégorie « poids libre » était de savoir si ces modèles étaient utilisables. Il y a six mois, il s'agissait de savoir s'ils étaient compétitifs. En septembre 2026, la question est véritablement la suivante : Pourquoi continuez-vous à payer un supplément pour un modèle fermé ?
Il existe une véritable réponse à cette question, et elle est plus restreinte qu’auparavant. Claude Fable 5.1 excelle dans les tâches agentiques soutenues les plus difficiles, dans le traitement des connaissances générales, ainsi que dans la catégorie du débogage où un modèle doit garder en mémoire un problème complexe pendant des heures sans s’égarer. La configuration « cache-read cut » 75% d'Anthropic cible précisément cette charge de travail. Si le coût d'un échec dépasse le coût des jetons, ce surcoût est rationnel.
Pour tout le reste, les chiffres ont changé. GLM-5.3 affiche un score de 941 TP3T selon l’indice de Claude Opus 5, pour un coût de 291 TP3T. Kimi K3 obtient un score de 88,3 sur Terminal-Bench 2.1, contre 88,0 pour Claude Fable 5 sur la même version, et s’est classé premier sur la Frontend Code Arena de LMArena, devançant ainsi les deux modèles phares propriétaires. Ollama vous vendra $60 de jetons pour $20 tout en supprimant les plafonds d’utilisation. Cette combinaison n’existait pas au printemps.
Mais ne vous laissez pas emporter par votre enthousiasme au point d'en oublier les clauses en petits caractères, car il y en a deux et elles sont toutes deux importantes.
Le premier point concerne les licences. “Les termes ” poids ouverts “ et ” open source “ ont discrètement cessé d’avoir la même signification. Kimi K3 et GLM-5.3 sont tous deux distribués sous des licences sur mesure, soumises à des conditions de revenus. Les barrières sont suffisamment hautes pour que la plupart des lecteurs ne soient pas concernés — mais ” la plupart des lecteurs ne sont pas concernés “ n’est pas synonyme de ” sans restriction ’, et la clause non définie de GLM-5.3 relative à l’évaluation de la sécurité représente un véritable risque en matière d’approvisionnement pour les grandes entreprises. GLM-5.3-Flash sous licence MIT est la dernière option pleinement permissive proche de la frontière, et c’est précisément pour cette raison qu’elle mérite davantage d’attention qu’elle n’en reçoit.
La deuxième raison est que l'auto-hébergement relève surtout de l'idéal. 1,5 To de données d'entraînement et 64 accélérateurs ne constituent pas une stratégie de sortie pour une entreprise de taille moyenne. Ce que vous apportent les données d'entraînement ouvertes à ce niveau, c'est un marché de l'inférence compétitif, la transparence des prix, le verrouillage des versions, le choix de la juridiction et une position de négociation. Tout cela a une grande valeur. Ce n'est pas la même chose que de faire tourner le système dans votre cave.
La configuration que je mettrais réellement en place : GLM-5.3 par défaut, Fable 5.1 pour la planification et les problèmes vraiment complexes, Kimi K3 pour la vision et la recherche à long terme, GLM-5.3-Flash pour le travail de base, et un modèle local 27B pour tout ce qui ne doit en aucun cas sortir du bâtiment. Répartissez en fonction de la charge de travail, et non de la fidélité. Rédigez votre configuration de manière à ce que la modification des identifiants de modèle ne nécessite qu'une seule ligne de code.
Car la seule chose dont je suis sûr, c'est que cet article devra être mis à jour avant Noël.
Utilisez-vous l'une de ces trois solutions en production ? Je voudrais notamment savoir si le niveau de verbosité de GLM-5.3 pose un réel problème de coût à grande échelle, et si quelqu'un a déjà soumis la licence Kimi K3 à un conseiller juridique et obtenu une interprétation claire de la définition du MaaS. N’hésitez pas à me contacter : les corrections et les contre-arguments sont les bienvenus, et cet article sera mis à jour si la situation évolue.
Dernière mise à jour : 2 septembre 2026.