 Deutsch
 English
 Español
 Italiano
 Français

Vor sechs Wochen hätte ich diesen Artikel anders geschrieben.
Im Juli stellte Moonshot AI ein Modell der Spitzenklasse mit 2,8 Billionen Parametern auf Hugging Face bereit und ermöglichte es jedem, es herunterzuladen. Am 28. August veröffentlichte Z.ai schließlich die GLM-5.3-Gewichte, die es zwei Wochen lang zurückgehalten hatte – nachdem festgestellt worden war, dass das eigene Modell Exploits auf eine Weise miteinander verketten konnte, um die niemand gebeten hatte. Und am 1. September brachte Anthropic „Claude Fable 5.1“ auf den Markt und senkte die Kosten für agentische Aufgaben um bis zu 451 TP3T, ohne den Listenpreis anzutasten.
Drei Modelle. Drei völlig unterschiedliche Antworten auf die Frage, was ein KI-Labor der Öffentlichkeit schuldig ist. Und zum ersten Mal seit Beginn dieser ganzen Angelegenheit sind die Optionen mit offener Gewichtung nicht die Kompromisslösung.
Das ist die eigentliche Geschichte von Ende 2026, und sie ist etwa achttausend Wörter wert, denn in den Details stecken das ganze Geld und alle Fehler.
Ich habe die Architekturunterlagen, die Modellkarten und die Lizenztexte herausgesucht – sorgfältig, Zeile für Zeile, denn zwei der drei entsprechen nicht den Bezeichnungen, die man im allgemeinen Sprachgebrauch dafür verwendet –, dazu die Hersteller-Benchmarks, die Bewertungen neutraler Aggregatoren, die tatsächlichen Preise pro Token und Ollamas brandneues Preisblatt. Anschließend habe ich die Kostenberechnungen für einen normalen Arbeitsmonat durchgeführt, anstatt von einem Szenario am Tag der Markteinführung auszugehen.
Das ist dabei herausgekommen.
TL;DR – Das 60-Sekunden-Urteil
GLM-5.3 bietet derzeit das beste Preis-Leistungs-Verhältnis im Bereich der KI – und das mit großem Abstand. Laut Artificial Analysis liegt es nur einen halben Punkt hinter Kimi K3 und etwa dreieinhalb Punkte hinter Claude Opus 5, mit $1,40 beim Einlesen und $4,40 beim Auslesen pro Million Tokens. Bei derselben agentenbasierten Aufgabe kostet es etwa ein Sechstel dessen, was Fable 5.1 kostet. Die Gewichte stehen zum Download bereit. Wenn Sie ein Modell suchen, auf das Sie Ihren Agenten ausrichten können, und Sie kein Unternehmen mit einem Umsatz von $10 Milliarden betreiben, dann ist dies genau das Richtige für Sie.
Kimi K3 ist das Leistungsstärkste, was man legal herunterladen kann. 2,8 Billionen Parameter, 104 Milliarden aktive Parameter, ein echter 1-Mio.-Kontext, native Bildverarbeitung, der beste bisher veröffentlichte Wert für agentisches Browsen (BrowseComp 91,2) und – die Zahl, die der Debatte um den “Rückstand offener Modelle” ein Ende setzen sollte – 88,3 auf Terminal-Bench 2.1, gegenüber 88,0 bei Claude Fable 5 und 88,8 bei GPT-5.6 Sol auf derselben Version. Außerdem kostet es $3/$15 – mehr als doppelt so viel wie GLM-5.3 – und für seine 1,5 TB an Gewichten ist ein Rack erforderlich, keine Workstation. Es ist das Modell, das man einsetzt, wenn die Aufgabe schwierig und langwierig ist, und das Modell, auf das man verweist, wenn jemand behauptet, offene Gewichte seien eine Generation im Rückstand.
Der Claude Fable 5.1 ist nach wie vor das Modell der Wahl, wenn Fehler teuer zu stehen kommen. Es ist führend bei langanhaltender, stundenlanger agentischer Arbeit und bei der chaotischen Fehlerbehebung, die in einer Rangliste nie sauber zum Ausdruck kommt. Anthropic hat am 1. September die Cache-Lesezugriffe um 75% reduziert, wodurch lange Agenten-Sitzungen deutlich kostengünstiger geworden sind als zuvor. Es ist zudem sechsmal so teuer wie GLM-5.3 pro Aufgabe (Closed) und unterliegt nun Anti-Destillations-Einschränkungen, die einige bestehende Integrationen unbrauchbar machen.
Der ehrliche Einzeiler: Die Open-Weight-Modelle haben die Leistungslücke auf etwa drei bis fünf Monate verringert und den Preisunterschied gänzlich beseitigt. Was Sie im September 2026 tatsächlich von Anthropic kaufen, ist Zuverlässigkeit bei den schwierigsten 10%-Aufgaben – und das Recht, sich über all das keine Gedanken machen zu müssen.
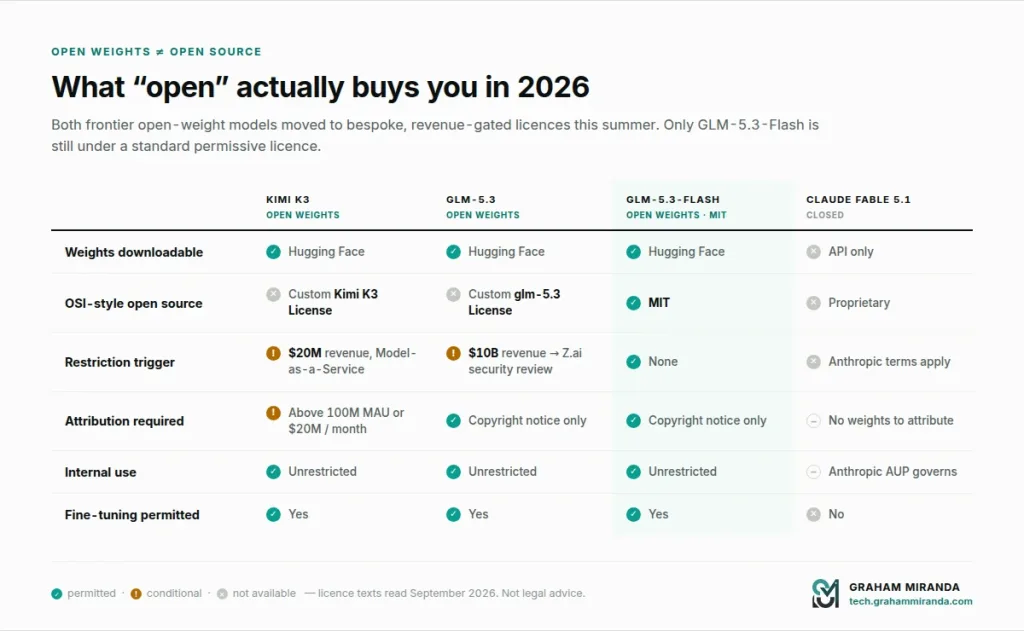
Und die Wendung, die niemand laut aussprechen will: Weder Kimi K3 noch GLM-5.3 werden noch unter einer Open-Source-Lizenz vertrieben. Beide sind diesen Sommer auf maßgeschneiderte, umsatzabhängige Bedingungen umgestiegen. Offene Gewichtsangaben, ja. Open Source, nein. Lesen Sie den Abschnitt über Lizenzen, bevor es Ihre Rechtsabteilung tut.
Übersichtstabelle
| Kimi K3 | GLM-5.3 | Claude Fable 5.1 | |
|---|---|---|---|
| Hersteller | Moonshot AI | Z.ai (Zhipu AI) | Anthropic |
| Veröffentlicht | 16. Juli 2026 (API) · 27. Juli (Gewichte) | 14. August 2026 (API) · 28. August (Gewichte) | 1. September 2026 |
| Verfügbare Gewichte | Ja | Ja | Nein |
| Lizenz | Kimi K3-Lizenz (maßgeschneidert, umsatzabhängig) | glm-5.3-Lizenz (maßgeschneidert, umsatzabhängig) | Urheberrechtlich geschützt |
| Gesamtparameter | 2,8 T | 753B | Nicht bekannt |
| Aktiv pro Token | 104B (16 von 896 Experten) | ~40 Mrd. (geschätzt) | Nicht bekannt |
| Architektur | KDA + Attention-Residuen, Stable LatentMoE, 69 KDA- und 24 Gated-MLA-Schichten | MoE, gleiche Basis wie GLM-5.2, profitiert ausschließlich vom Post-Training | Nicht bekannt |
| Kontextfenster | 1,048,576 | 1,000,000 | 1,000,000 |
| Maximale Leistung | 131.072 Standard (bis zu 1.048.576) | 128,000 | 128,000 |
| Multimodale Eingabe | Text, Bild, Video (MoonViT-V2) | Nur Text | Text, Bild |
| Nachdenken | Immer eingeschaltet | Immer eingeschaltet, logische_Überlegung niedrig/hoch/max | Ständig aktiv, anpassungsfähig, auf einzelne Nachrichten zugeschnitten (Beta) |
| Einkaufspreis / 1 Mio. | $3.00 | $1.40 | $10.00 |
| Zwischengespeicherte Eingaben / 1 Mio. | $0.30 | $0.26 | $0.25 |
| Verkaufspreis / 1 Mio. | $15.00 | $4.40 | $50.00 |
| AA-Intelligenzindex | 59.7 | 59.5 | Noch keine Bewertung (Fable 5: 62,1) |
| Kosten pro AA-Bewertungsaufgabe | $0.84 | $0.68 | — (Opus 5: $2.34) |
| Platzbedarf bei eigenem Hosting | ~1,5 TB (natives MXFP4) | ~1,5 TB BF16 / ~750 GB FP8 | K.A. |
| Über Ollama | kimi-k3:cloud | glm-5.3:Cloud | Über Claude Code / Claude Desktop als Client |
Alle Preisangaben entsprechen den Listenpreisen des Herstellers. Die Zahlen von Artificial Analysis stammen aus der Indexaufstellung vom September 2026; Fable 5.1 wurde am 1. September veröffentlicht und war zum Zeitpunkt der Erstellung dieses Artikels noch nicht unabhängig bewertet worden.
Warum dieser Dreiervergleich entscheidend ist
Zwei Jahre lang verlief die Debatte um „offen versus geschlossen“ in geordneten Bahnen: Geschlossene Modelle waren besser, offene Modelle günstiger, und man entschied sich je nach Abwägung für die eine oder andere Option. Jeder wusste, wo er stand.
Diese Form ist diesen Sommer zerbrochen.
Nathan Lambert, der dies genauer verfolgt als fast jeder andere, beziffert die derzeitige Leistungslücke zwischen den „Frontier Open-Weight“- und den „Frontier Closed“-Modellen auf drei bis fünf Monate — ein Rückgang gegenüber den sechs bis neun Monaten, von denen vor einem Jahr noch die Rede war. Zum Zeitpunkt seiner Veröffentlichung lag Kimi K3 im Vals-AI-Index auf Platz #2 und damit nahe der Spitze des Artificial-Analysis-Index, nur übertroffen von Claude Fable und GPT-5.6 Sol Max. Die Indexübersicht vom September, auf die ich später in diesem Artikel zurückkomme, listet das Modell auf Platz vier hinter Grok 4.6 auf. So oder so: Das ist nicht nur “gut für ein offenes Modell”. Das ist ein Platz auf dem Podium.
Inzwischen haben die Nutzungsdaten eine wirklich überraschende Entwicklung genommen. Modelle chinesischer Herkunft haben etwa 61% aller über OpenRouter weitergeleiteten Tokens bis Mai 2026. Der US-Anteil an diesem Datenverkehr brach innerhalb von zwölf Monaten von etwa 70% auf etwa 30% ein. Metas „Llama“ – das Modell, das die Open-Weight-Welle ausgelöst hatte – fiel unter 1% des weitergeleiteten Volumens. Der Anteil von Google sank von rund 371 TP3T auf 131 TP3T. Eine eigene Studie von OpenRouter in Zusammenarbeit mit a16z, die 100 Billionen Token umfasste, ergab, dass Open-Weight-Modelle etwa ein Drittel des gesamten Token-Volumens auf der Plattform ausmachten.
Man kann darüber streiten, was der OpenRouter-Datenverkehr genau widerspiegelt. Er gewichtet Entwickler, Hobbyanwender und kostenbewusste Anwendungsfälle überproportional stark, während Unternehmensverträge, bei denen niemals ein Router zum Einsatz kommt, unterrepräsentiert sind. Gut. Aber es ist der größte öffentlich zugängliche Datensatz, den wir darüber haben, wofür sich Menschen tatsächlich entscheiden, wenn sie die freie Wahl haben – und die Tendenz ist eindeutig.
Die Frage im September 2026 lautet also nicht mehr: “Sind offene Modelle schon gut genug?”, sondern sie ist viel prägnanter:
Angenommen, es gibt drei Modelle, die alle die Anforderungen erfüllen – auf welches sollten Sie Ihren Makler hinweisen – und was kostet es Sie eigentlich, wenn Sie sich irren?
Das ist eine Frage nach Benchmarks, Preisen, Lizenzen und Infrastruktur – in etwa in der Reihenfolge, in der die Leute darüber nachdenken, und genau in umgekehrter Reihenfolge, wie wichtig diese Aspekte tatsächlich sind.
Was Kimi K3 eigentlich ist
Moonshot AI kündigte am 16. Juli 2026 „Kimi K3“ an und veröffentlichte am 27. Juli die vollständigen Gewichtsangaben. Gemessen an der Anzahl der Parameter ist es das größte Modell mit offenem Gewichtsumfang, das jemals veröffentlicht wurde – insgesamt 2,8 Billionen Parameter, etwa 75% mehr als DeepSeek V4 Pro.
Diese Zahl ist weniger beeindruckend, als es klingt, und zugleich beeindruckender, als es klingt – in genau dieser Reihenfolge.
Die Architektur, in einfachen Worten
Kimi K3 ist ein „Mixture-of-Experts“-Modell, das 104 Milliarden Parameter pro Token, wobei 16 Experten aus einem Pool von 896 ausgewählt wurden. Die Gesamtzahl beträgt zwar 2,8 T, doch bei jedem einzelnen Vorwärtsdurchlauf werden weniger als 41 TP3T der Gewichte berücksichtigt. Darin liegt der wirtschaftliche Vorteil: ein enormes gespeichertes Wissen bei moderaten Inferenzkosten.
Das Interessante an der Technik liegt im „Attention-Stack“. K3 nutzt 93 Schichten, bestehend aus 69 KDA-Schichten (Kimi Delta Attention) und 24 Gated-MLA-Schichten — ein hybrides Design aus linearer und vollständiger Aufmerksamkeit mit einem Interleave-Verhältnis von etwa 3:1. KDA ist eine Variante der linearen Aufmerksamkeit, die im Verhältnis zur Sequenzlänge in linearer statt in quadratischer Zeit läuft, wodurch der 1-Mio.-Kontext wirtschaftlich realisierbar wird und nicht nur als Werbegag dient. Moonshot gibt bis zu einem 75% KV-Cache-Reduzierung und bis zu 6-facher Dekodierungsdurchsatz bei 1 M Kontext infolgedessen.
Darüber kommt noch Aufmerksamkeitsresiduen (AttnRes), das Moonshot als direkten Ersatz für Standard-Residualverbindungen beschreibt, und ein Stabiles LatentMoE Framework für das Routing. Die Kombination soll angeblich etwa ein 2,5-fache Steigerung der Gesamtskalierungseffizienz gegen Kimi K2.
Vision entsteht aus MoonViT-V2, ein Encoder mit 401M Parametern, der nicht nachträglich hinzugefügt, sondern von Grund auf integriert ist – K3 verarbeitet Text, Bilder und Videos in einem einzigen Modell.
Noch ein wichtiger Hinweis für alle, die über ein eigenes Hosting nachdenken: K3 wurde trainiert mit Natives, quantisierungsbewusstes Training mit MXFP4, mit Experten in MXFP4 und Aktivierungen in MXFP8. Es handelt sich hierbei nicht um eine nachträgliche Quantisierung. Der veröffentlichte Checkpoint ist das quantisierte Modell, weshalb 2,8 Billionen Parameter bei ungefähr 1,5 TB auf der Festplatte anstatt der ~5,6 TB, die ein BF16-Checkpoint dieser Größe benötigen würde.
Die Geschichte des Benchmarks
Die von Moonshot veröffentlichten Zahlen sind durchweg überzeugend, und ungewöhnlicherweise haben sich einige davon bei einer unabhängigen Bewertung bewährt:
- Terminal-Bench 2.1: 88,3 — die höchste veröffentlichte Punktzahl bei dieser Version des Benchmarks
- FrontierSWE: 81,2
- DeepSWE: 67,5
- BrowseComp: 91,2 — Aktueller Stand der Forschung im Bereich der agentenbasierten Webforschung
- GPQA Diamond: 93,5
- MMMU-Pro: 81,6 / 83,4 (Vision)
- SWE-Marathon: 91,0
- OfficeQA Pro: 81,3
- AutomationBench: 30,8
- LMArena Frontend Code Arena: 1.679 Elo – erster Platz, vor Claude Fable 5 (1.631) und GPT-5.6 Sol (1.618), wobei es in sechs von sieben Frontend-Bereichen die Nase vorn hatte
Das Letzte verdient eine kurze Pause. Ein Open-Weight-Modell, das man kostenlos herunterladen kann, belegte den ersten Platz bei einem Frontend-Programmierwettbewerb zur Erfassung menschlicher Präferenzen – noch vor den Flaggschiff-Modellen der beiden finanzstärksten Labore der Welt. Was auch immer man von Arena-Benchmarks als Methodik halten mag: Das ist eine Schlagzeile, die im Jahr 2025 noch undenkbar gewesen wäre.
Bei den Gesamtindizes liegt es etwas darunter: 59,7 auf dem Index für künstliche Analyseintelligenz, insgesamt Dritter hinter Claude Opus 5 (63,0) und Claude Fable 5 (62,1). Die eigenen Bestleistungen von Moonshot — GDPval-AA v2 bei 1.687 und AA-Aktentasche bei 1.527 — belegte damit in diesen Bewertungen der Wissensarbeit den dritten bzw. zweiten Platz. Im Vals-Index v2 liegt es auf 57.8%, im Vergleich zu Claude Opus 5 mit 67,21 TP3T, den 66,01 TP3T von ’Claude Fable 5’ und den 63,71 TP3T von „GPT-5.6 Sol“ – dies ist der größte Unterschied zwischen „offen“ und „geschlossen“ in jedem Index, den ich gefunden habe, und sollte im Hinblick auf die Codierungszahlen im Hinterkopf behalten werden.
Die Demos und wie man sie liest
Moonshot veröffentlichte zwei Demonstrationen zur Autonomie mit langfristigem Horizont, die große Aufmerksamkeit erregten: eine 48-stündiger autonomer Lauf zur Durchführung einer vollständigen Chip-Design-Pipeline (ein 4-mm-Design mit einem Schließzeitpunkt bei 100 MHz, simuliert mit über 8.700 Token pro Sekunde) sowie eine Nachbildung der Astrophysik Die I-Love-Q-Beziehung in etwa zwei Stunden, im Gegensatz zu den ein bis zwei Wochen, die ein leitender Forscher in der Regel benötigen würde.
Diese sind wirklich beeindruckend, aber ich würde meine Kaufentscheidung nicht darauf stützen. Von Anbietern durchgeführte, von ihnen vorbereitete und ausgewählte Demonstrationen zeigen Ihnen, wozu ein Modell an einem guten Tag unter fachkundiger Aufsicht fähig ist – nicht aber, wie es sich an einem Dienstag in Ihrem Repository verhält. Betrachten Sie sie als Beweis für das langfristige Potenzial, nicht als Spezifikation.
Bild anzeigen Zwei veröffentlichte Architekturen und eine Black Box. Bei den offenen Modellen erfährt man genau, wie sie funktionieren; bei dem geschlossenen Modell erfährt man, welche Ergebnisse es liefert.
Was GLM-5.3 eigentlich ist
GLM-5.3 hat von den dreien die seltsamste Entstehungsgeschichte, und es lohnt sich, diese ausführlich zu erzählen, denn es ist das erste Mal, dass ein großes Forschungsinstitut aus anderen als kommerziellen Gründen sichtlich gezögert hat, Gewichte zu veröffentlichen.
Z.ai hat GLM-5.3 am 14. August 2026 mit dem Slogan “Built to Code. Ready for Cyber Defense.” Das Modell ist ein „Mixture of Experts“-Modell mit 753 Milliarden Parametern, mit etwa 40 Milliarden aktiven Token pro Token, laut Schätzungen der Community, die auf der GLM-5.2-Konfiguration basieren. Es verfügt über ein Kontextfenster von 1 Million Token und eine maximale Ausgabekapazität von 128.000 und ist – im Gegensatz zu GLM-5.3-Flash, bei dem es sich um ein völlig anderes Modell handelt – nur Text.
“Nach dem Training haben wir uns ausschließlich auf die Skalierung konzentriert.”
Das technisch Interessanteste an GLM-5.3 ist, dass es kein neues Basismodell gibt. Es nutzt dieselbe vortrainierte Grundlage wie GLM-5.2. Alle Verbesserungen sind auf ein drastisch erweitertes Nachtraining zurückzuführen, das Z.ai wie folgt zusammenfasste: “Bei GLM-5.3 haben wir uns ausschließlich auf die Skalierung nach dem Training konzentriert.”
Die Abweichungen sind nicht gering:
| Benchmark | GLM-5.2 | GLM-5.3 |
|---|---|---|
| Terminal-Bench 3.0 | 4.6 | 28.3 |
| DeepSWE v1.1 | 46.2 | 66.9 |
| CyberGym | 77.2% | 84.5% |
Eine sechsfache Verbesserung bei Terminal-Bench und ein Sprung um 20 Punkte bei DeepSWE – ausgehend von denselben Basisgewichten – ist ein wirklich bedeutendes Ergebnis. Es zeigt, dass die Grenze im Post-Training noch viel Spielraum bietet, was bei weitem die kostengünstigere Hälfte der Trainingskosten ausmacht. Genau aus diesem Grund können chinesische Labore, die – wie Lambert es ausdrückt – mit “um Größenordnungen weniger Kapital” arbeiten als amerikanische, Schritt halten.
Die zwei Wochen, in denen Z.ai keine Lieferungen tätigte
Z.ai erklärte bei der Einführung, dass die Gewichte “schrittweise nach strengen Sicherheitsprüfungen” veröffentlicht würden, wobei ein Zeitrahmen von etwa zwei Wochen angestrebt werde. Im Hugging-Face-Repository war der 28. August angegeben. Dieser Tag kam, verging innerhalb weniger Stunden, und dann erschienen die Gewichte zusammen mit einem technischen Bericht, in dem die Verzögerung erläutert wurde.
Der Grund dafür waren die Cyberfähigkeiten. Im Rahmen der Bewertung berichtete Z.ai, dass GLM-5.3 Folgendes identifiziert habe: 2.436 Sicherheitslücken in 269 Open-Source-Projekten, wovon 1.097 wurden als kritisch oder mit hohem Schweregrad eingestuft. Genauer gesagt hat das Modell gezeigt, Analyse mehrstufiger Exploit-Ketten — die autonome Verknüpfung von Ausnutzungsschritten — was Z.ai als ein Verhalten bezeichnete, das “nicht vollständig beabsichtigt” war und sich “mit zunehmendem Umfang des Trainings weiter verstärkte”.”
Ich möchte hier vorsichtig sein, denn dies lässt sich leicht entweder als Marketing oder als Panikmache interpretieren, ist aber wahrscheinlich weder das eine noch das andere. Ein Modell, das gut darin ist, Schwachstellen zu finden, ist eben gut darin; der defensive und der offensive Einsatz sind ein und dieselbe Fähigkeit, die in unterschiedliche Richtungen ausgerichtet ist. Die Benchmark-Verteilung von Z.ai spiegelt dies ehrlich wider: CyberGym 84.5% (Entdeckung von Sicherheitslücken, wohin das führt) gegenüber ExploitBench 54.4% (Ausnutzung, wobei Claude Fable 5 78,01 TP3T erzielt). Das Labor hat bewusst die defensive Hälfte optimiert, und das macht sich bemerkbar.
Wirklich bemerkenswert ist, dass ein Labor die Veröffentlichung eines Flaggschiff-Produkts zwei Wochen lang zurückhielt und seine Gründe dafür veröffentlichte. Unabhängig davon, ob man diese Gründe überzeugend findet oder nicht – dieser Präzedenzfall ist neu.
Wo GLM-5.3 tatsächlich landet
Die von Z.ai veröffentlichte Vergleichstabelle erhebt keinen Anspruch auf einen vollständigen Sieg, was erfrischend ist:
| Benchmark | GLM-5.3 | Bester Vergleicher |
|---|---|---|
| AutomationBench | 48.2% | GLM-5.3-Leitungen |
| CyberGym | 84.5% | GLM-5.3-Leitungen |
| GDPval-AA v2 | 1,769 | GLM-5.3-Leitungen |
| Terminal-Bench 3.0 | 28.3% | GPT-5.6 Lösung: 34,6% |
| DeepSWE v1.1 | 66.9% | GPT-5.6 Lösung: 72,7% |
| ExploitBench | 54.4% | Claude Fable 5: 78,01 TP3T |
| Code Bench (50.000 Token) | 31.4% | — |
Unabhängig davon beziffert Artificial Analysis die Zahl auf 59,5 auf dem Intelligenzindex — statistisch nicht von Kimi K3s Wert von 59,7 zu unterscheiden, und das bei einem Modell mit etwa einem Viertel der Parameter.
Ein Vorbehalt aus derselben Auswertung, den niemand aus dem Marketing erwähnt: GLM-5.3 erzeugte 170 Millionen erzeugte Token in der gesamten „Artificial Analysis“-Suite gegenüber einem Medianwert von 72 Millionen in dieser Kategorie. Es ist sehr ausführlich. logische_Überlegung Standardmäßig ist max Und da man das Denken nicht einfach ausschalten kann, zahlt man für eine Menge Überlegungen, unabhängig davon, ob die Aufgabe dies rechtfertigt oder nicht. Dennoch beliefen sich die Gesamtkosten für die Durchführung der vollständigen Bewertung auf $0,68 pro Aufgabe, gegenüber $0,84 für Kimi K3 und $2,34 für Claude Opus 5 – der höhere Aufwand gleicht also den Preisvorteil nicht aus. Er schmälert ihn lediglich.
Was „Claude Fable 5.1“ eigentlich ist
Anthropic hat Claude Fable 5.1 am 1. September 2026, neben dem Claude Mythos 5.1 – dem gleichen Modell mit einer anderen Sicherheitskonfiguration, das ausschließlich im Rahmen von Trusted-Access-Programmen für den Einsatz in den Bereichen Cybersicherheit und Biowissenschaften erhältlich ist.
Die Positionierung ist konkret und, wie ich meine, zutreffend: Das ist “Ein Modell, das für Aufgaben entwickelt wurde, die sich nicht mit einer einzigen Eingabe lösen lassen.” Anthropic behauptet nicht, dass ein Sprung in der allgemeinen Intelligenz gelungen sei. Das Unternehmen behauptet vielmehr, dass anhaltende, mehrere Stunden dauernde agentenbasierte Sitzungen besser verlaufen.
Die Zahlen
| Benchmark | Fabel 5 | Fable 5.1 | Mythos 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | 42.0% | 55.8% | 60.9% |
| Terminal-Bench-Science 0.1 | 24.7% | 52.6% | — |
| AutomationBench | 17.1% | 31.4% | — |
| CursorBench 3.2.0 | 70.5% | 73.4% | — |
| OSWorld 2.0 (Auszug) | 72.9% | 77.9% | — |
| Die letzte Prüfung der Menschheit (mit Hilfsmitteln) | 63.8% | 65.0% | — |
| GDPval-AA v2 | — | 1,853 | — |
Weitere Informationen zu diesem Herrscher: GPT-5.6 Sol erreicht bei Terminal-Bench 4.0 einen Wert von 52,31 TP3T, sodass Fable 5.1 mit 55,81 TP3T die Führung übernimmt und Mythos 5.1 mit 60,91 TP3T diesen Vorsprung weiter ausbaut.
Der Sprung bei „Terminal-Bench-Science“ – von 24,71 TP3T auf 52,61 TP3T, also eine klare Verdopplung – würde ich am stärksten gewichten, wenn Ihre Arbeit mit wissenschaftlichen Berechnungen oder Datenpipelines zu tun hat. Und im anspruchsvollsten Rechenleistungs-Benchmark von Browserbase schloss Fable 5.1 ab 82% Aufgaben gegenüber 74% von Claude Opus 5.
Anthropic gibt zudem an, dass etwa ein 60% – Reduzierung von Fehlalarmen im Bereich Cybersicherheit — das Modell lehnt legitime Sicherheitsaufgaben ab, weil es ein Muster erkennt, das mit etwas Gefährlichem übereinstimmt. Wenn Ihnen schon einmal ein Programmierassistent die Hilfe beim Erstellen eines Ratenbegrenzers verweigert hat, werden Sie verstehen, warum das von Bedeutung ist.
Die Preisänderung ist die eigentliche Neuigkeit
Die Leitzinsen blieben unverändert: $10 pro Million Eingabetoken, $50 pro Million Ausgabetoken. Was sich geändert hat, ist der Cache-Lese-Multiplikator, und zwar erheblich.
| Fabel 5 | Fable 5.1 | |
|---|---|---|
| Eingabe | $10.00 | $10.00 |
| Ausgabe | $50.00 | $50.00 |
| Cache-Schreibvorgang (5 Min.) | $12.50 | $12.50 |
| Cache-Schreibvorgang (1 Stunde) | $20.00 | $20.00 |
| Cache-Lesezugriff | $1.00 | $0.25 |
Das entspricht einer Reduzierung um 75%, die dadurch erreicht wurde, dass der Multiplikator für Cache-Lesezugriffe vom Standardwert von 0,1× des Basis-Eingangswerts auf 0,025× gesenkt wurde. Anthropic gibt ungefähr an, dass 25% günstiger bei typischen Arbeitslasten und bis zu 45% günstiger bei sehr agentenintensiven Aufgaben — und diese zweite Zahl ist realistisch, da es sich bei Agenten-Schleifen überwiegend um Cache-Lesezugriffe handelt. Bei einer Agentensitzung mit 60 Durchläufen wird derselbe akkumulierte Kontext dutzende Male erneut gelesen. Die Batch-API halbiert darüber hinaus die Ein- und Ausgabe, was zu einem Wert von $5/$25 führt.
Das ist eine kluge, gezielte Preissenkung. Sie macht genau das, worin das Fable 5.1 am besten ist – lange Sitzungen –, deutlich günstiger, ohne das Modell insgesamt an Wert zu verlieren.
Drei Änderungen mit Kompatibilitätsproblemen, ein Regressionsfehler
Bevor Sie eine Produktionsintegration aktualisieren, lesen Sie diese Informationen bitte sorgfältig durch.
1. Der erzwungene Einsatz von Werkzeugen gehört der Vergangenheit an. Anfragen unter Verwendung von tool_choice: "beliebig" oder tool_choice: "tool" Gib nun ein Fehler 400. Das Denken läuft immer und lässt sich nicht umgehen; würde man einen Tool-Aufruf erzwingen, würde dies das Denken überspringen. Sie müssen tool_choice: "auto".
2. Denkblockaden verlaufen in eine Richtung. Fable 5.1 kann ’Thinking Blocks“ lesen, die von früheren Claude-Modellen erstellt wurden, aber frühere Modelle können die von Fable 5.1 nicht lesen. Nur Mythos 5.1 ist dazu in der Lage. Wenn Ihre Architektur mitten in einem Gespräch das Modell wechselt, um Kosten zu sparen, erzwingt dieser Fallback nun eine Neuplanung.
3. Der Bearbeitungsverlauf macht Denkblockaden zunichte. Bei Konten, die nach dem 31. August 2026 erstellt wurden, führt die Bearbeitung früherer Spielzüge, der Systemaufforderung oder der Werkzeugleiste dazu, dass alle nachfolgenden Denkblöcke ungültig werden – unabhängig davon, ob es sich um Fehler oder stille Ausfälle handelt. Dies ist eine explizite Maßnahme gegen die „Destillation“ und durchbricht ein gängiges Muster, bei dem Agenten-Frameworks den Kontext zwischen den Spielzügen umschreiben.
Und eine Regression, die man kennen sollte: Der parallele Aufruf von Tools verläuft in Version 5.1 Berichten zufolge unregelmäßiger; manchmal erfolgt nur ein einziger Aufruf pro Durchlauf, während in Version 5 mehrere Aufrufe gebündelt wurden. Bei einer langen Agenten-Schleife kostet das reale Zeit.
Es gibt außerdem eine Besonderheit beim Tokenizer, die bei Kostenvergleichen oft übersehen wird: Fable 5.1 verwendet denselben Tokenizer wie Claude Opus 4.7, der ungefähr 30% weitere Token als der Tokenizer in älteren Claude-Modellen für denselben Text. Wenn Sie die Kosten mit einem Referenzwert aus dem Jahr 2025 vergleichen, sollten Sie dies berücksichtigen, bevor Sie Schlussfolgerungen ziehen.
Das Benchmark-Problem: Drei Modelle, drei verschiedene Maßstäbe
Hier liegt der Punkt, den die meisten Vergleichsartikel falsch darstellen, und es lohnt sich, dies ganz offen anzusprechen.
Diese drei Modelle lassen sich nicht auf Terminal-Bench nebeneinander aufstellen. Schau mal:
- Kimi K3: 88.3 auf Terminal-Bench 2.1
- GLM-5.3: 28.3 auf Terminal-Bench 3.0
- Fable 5.1: 55.8 auf Terminal-Bench 4.0
Das sind drei verschiedene Benchmarks, die denselben Namen tragen. Jede Version war deutlich schwieriger als die vorherige – genau darum geht es ja bei der Veröffentlichung einer neuen Version. Würde man diese drei Zahlen als Rangliste interpretieren, würde man zu dem Schluss kommen, dass Kimi K3 bei der Terminal-Arbeit dreimal besser ist als GLM-5.3, was Unsinn ist.
Das gleiche Problem besteht bei AutomationBench, wo Versionsnummern uneinheitlich angegeben werden, sowie bei der SWE-Bench-Familie, bei der die Varianten „Verified“, „Pro“ und „Marathon“ tatsächlich unterschiedliche Dinge messen. Die Labore tun dies nicht, um jemanden zu täuschen – sie führen die Bewertung durch, die zum Zeitpunkt ihrer Ausbildung aktuell war, und Bewertungen ändern sich mittlerweile alle paar Monate. Doch für einen flüchtigen Leser wirkt dies wie eine Täuschung, weshalb es sich lohnt, laut darauf hinzuweisen.
Was man innerhalb einer Version sinnvoll vergleichen kann:
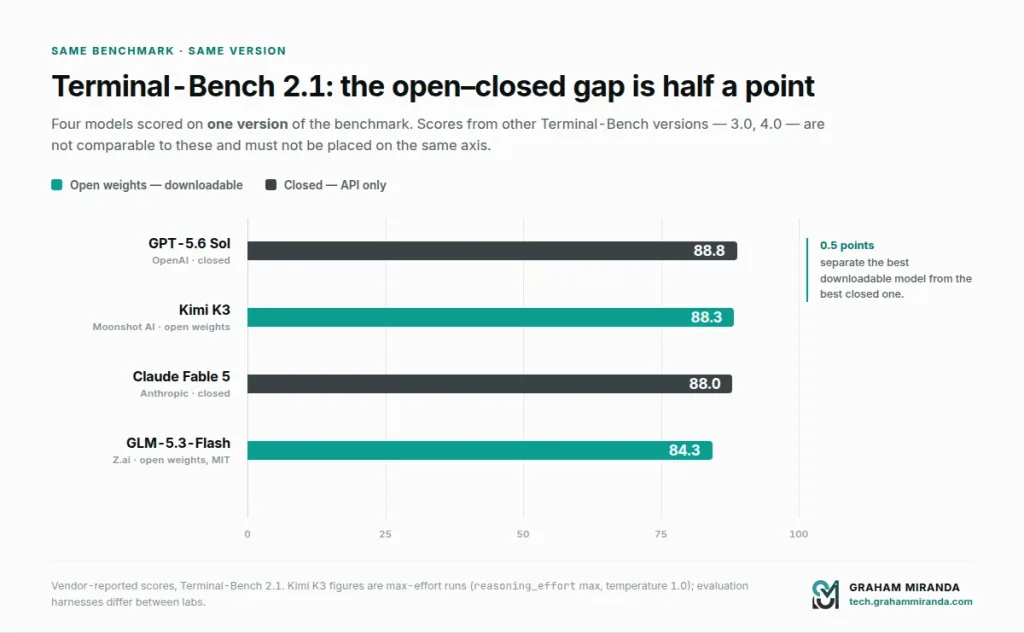
Auf Terminal-Bench 2.1: Kimi K3 (88,3), GPT-5.6 Sol (88,8), Claude Fable 5 (88,0) und GLM-5.3-Flash (84,3). Vier Modelle, ein Maßstab. Das ist der Vergleich, auf den es wirklich ankommt, und ich habe ihm im nächsten Abschnitt eine eigene Tabelle gewidmet.
Auf Terminal-Bench 4.0: Fable 5.1 (55,8) gegen GPT-5.6 Sol (52,3). Fable gewinnt.
Seien Sie darüber hinaus skeptisch gegenüber jedem, der Ihnen ein einziges Balkendiagramm vorlegt, in dem alle drei in diesem Artikel vorgestellten Modelle auf einer „Terminal-Bench“-Achse dargestellt sind. Das lässt sich nicht auf ehrliche Weise darstellen.
Wo sie sich tatsächlich überschneiden: Die vergleichbaren Zahlen
Wenn man die Unstimmigkeiten bei den Benchmark-Versionen herausrechnet, bleiben drei Vergleiche übrig.
1. Index für künstliche Analyseintelligenz (September 2026)
Unabhängig durchgeführt, einheitliche Methodik für alle Modelle, keine Beteiligung des Anbieters bei der Auswahl.
| Rang | Modell | Ergebnis | Freihanteln |
|---|---|---|---|
| 1 | Claude Opus 5 | 63.0 | Nein |
| 2 | Claude Fable 5 | 62.1 | Nein |
| 3 | Grok 4.6 | 60.9 | Nein |
| 4 | Kimi K3 | 59.7 | Ja |
| 5 | GLM-5.3 | 59.5 | Ja |
| 6 | GPT-5.6 Sol | 58.9 | Nein |
| 7 | Qwen 3.8 Max – Vorschau | 58.1 | Gewichte stehen noch nicht fest |
| 8 | GLM-5.3-Flash | 57.5 | Ja (MIT) |
| 31 | MiniMax M3 | 45.4 | Ja |
Zum Zeitpunkt der Erstellung dieses Artikels lag noch keine unabhängige Bewertung für ’Fable 5.1“ vor – das Spiel war erst am Vortag erschienen. Angesichts der Leistungsunterschiede von „Fable 5.1“ gegenüber „Fable 5“ ist davon auszugehen, dass es bei einer Bewertung von 62,1 oder höher liegen wird, sobald diese vorliegt.
Ein Hinweis zur Genauigkeit: Verschiedene Momentaufnahmen dieses Indexes weisen unterschiedliche Ergebnisse auf – bei einer Erhebung im September liegen Kimi K3 und GLM-5.3 beide bei 60 und GPT-5.6 Sol bei 61. Die Reihenfolge an der Spitze ist stabil, die Abstände zwischen den einzelnen Unterpunkten hingegen nicht. Stützen Sie Ihre Argumentation nicht auf einen halben Punkt.
Lesen Sie diese Tabelle aufmerksam durch. Das beste Open-Weight-Modell liegt beim breitesten verfügbaren neutralen Index 3,3 Punkte hinter dem besten Closed-Weight-Modell zurück. Vor einem Jahr lag diese Differenz noch im zweistelligen Bereich.
2. Terminal-Bench 2.1 – die einzige Version, in der sich alle drei treffen
Das ist die mit Abstand nützlichste Tabelle in diesem Artikel, und ich hätte sie beinahe übersehen. Kimi K3, Claude Fable 5 und GPT-5.6 Sol wurden alle anhand folgender Kriterien bewertet: die gleiche Version von Terminal-Bench:
| Modell | Terminal-Bench 2.1 | Freihanteln |
|---|---|---|
| GPT-5.6 Sol | 88.8 | Nein |
| Kimi K3 | 88.3 | Ja |
| Claude Fable 5 | 88.0 | Nein |
| GLM-5.3-Flash | 84.3 | Ja (MIT) |
Ein halber Punkt trennt ein Modell, das Sie herunterladen können, vom besten geschlossenen Modell im selben Benchmark, in derselben Version und bei terminal-nativer agentischer Verarbeitung.
Das ist die Zahl, die man sich merken muss. Nicht der Indexwert, nicht das Anbieter-Diagramm – sondern diese hier. Was die spezifische Aufgabenform betrifft, die agentische Kodierung tatsächlich darstellt, liegt die Lücke innerhalb des Rauschens.
Eine Einschränkung, die von der Quelle genannt wurde und die es wert ist, wiederholt zu werden: Alle veröffentlichten Werte des Kimi K3 stammen aus Fahrten mit maximaler Leistung, bei logische_Überlegung Maximalwert und Temperatur 1,0. Verschiedene Labore verwenden unterschiedliche Bewertungsrahmen und unterschiedliche Belastungsstufen, sodass selbst Vergleiche innerhalb derselben Version mit größerer Unsicherheit behaftet sind, als eine übersichtliche Tabelle vermuten lässt.
3. Kosten für den Betrieb derselben Testsuite
Wenn die obige Tabelle den besten Vergleich der Funktionen darstellt, ist dies der beste Vergleich hinsichtlich des Preis-Leistungs-Verhältnisses – denn es ist die einzige Kennzahl, die Funktionen, Ausführlichkeit, Rechenaufwand und Preis in einer einzigen Zahl zusammenfasst:
| Modell | Kosten pro Aufgabe des Intelligence-Index |
|---|---|
| GLM-5.3 | $0.68 |
| Kimi K3 | $0.84 |
| Claude Opus 5 | $2.34 |
Gleiche Aufgaben, gleiche Bewertung, echte Rechnungen. GLM-5.3 erreicht 94% des Opus-5-Indexwerts bei 29% der Kosten.
4. GDPval-AA v2 (Wissensarbeit)
| Modell | Ergebnis |
|---|---|
| Claude Fable 5.1 | 1,853 |
| Claude Fable 5 Max | 1,815 |
| GLM-5.3 | 1,769 |
| GPT-5.6 Sol Max | 1,747.8 |
| Kimi K3 | 1,687 |
Hier ist eine Einschränkung angebracht: Die Daten basieren auf von Anbietern veröffentlichten Diagrammen und nicht auf einer einzigen unabhängigen Untersuchung, und die Endungen “Max” weisen auf unterschiedliche Aufwandsstufen hin. Die Reihenfolge stimmt jedoch über die verschiedenen Quellen hinweg weitgehend überein, und sie sagt etwas Aussagekräftiges aus: Bei allgemeiner Wissensarbeit – im Gegensatz zum Programmieren – haben die geschlossenen Modelle immer noch einen deutlicheren Vorsprung, als die Programmier-Benchmarks vermuten lassen.
Dieses Muster zeigt sich bei allen drei Vergleichen. Die offenen Modelle haben bei Codierungs- und agentenbasierten Aufgaben im Wesentlichen aufgeholt. Bei allgemeinen Wissensaufgaben liegen sie jedoch noch einen Schritt zurück. Wenn Ihr Arbeitsaufwand dem erstgenannten Fall entspricht, gibt es kaum Gründe, die für die Zahlung von Preisen für geschlossene Modelle sprechen. Wenn er dem letztgenannten Fall entspricht, ist dies dennoch vertretbar.
Bild anzeigen Etwas mehr als drei Punkte trennen das beste geschlossene Modell vom besten herunterladbaren Modell. Vor zwölf Monaten lag dieser Abstand noch im zweistelligen Bereich.
Die Kostenrechnung – mit echten Zahlen
Benchmarks sind abstrakt. Rechnungen hingegen nicht.
Das Szenario
Ein mittleres Merkmal, agentisch umgesetzt: grob gesagt 60 Werkzeugwechselvorgänge, im Durchschnitt 45.000 Eingabetoken pro Runde je mehr Kontext sich ansammelt, und 2.000 Ausgabetoken pro Runde.
- Gesamteingabe: 2,7 Millionen Token
- Gesamtleistung: 120.000 Token
- Angenommene Trefferquote des Prompt-Caches: 80% (2,16 Mio. im Cache, 540.000 aktuell)
Claude Fable 5.1
| Komponente | Token | Bewertung | Kosten |
|---|---|---|---|
| Neue Informationen | 540.000 | $10,00/M | $5.40 |
| Zwischengespeicherte Eingabe | 2,16 Mio. | $0,25/M | $0.54 |
| Ausgabe | 120.000 | $50,00/M | $6.00 |
| Gesamt | ≈ $11,94 |
Kimi K3
| Komponente | Token | Bewertung | Kosten |
|---|---|---|---|
| Neue Informationen | 540.000 | $3,00/M | $1.62 |
| Zwischengespeicherte Eingabe | 2,16 Mio. | $0,30/M | $0.65 |
| Ausgabe | 120.000 | $15,00/M | $1.80 |
| Gesamt | ≈ $4,07 |
GLM-5.3
| Komponente | Token | Bewertung | Kosten |
|---|---|---|---|
| Neue Informationen | 540.000 | $1,40/M | $0.76 |
| Zwischengespeicherte Eingabe | 2,16 Mio. | $0,26/M | $0.56 |
| Ausgabe | 120.000 | $4,40/M | $0.53 |
| Gesamt | ≈ $1,85 |
Und zur Information: GLM-5.3-Flash
| Komponente | Token | Bewertung | Kosten |
|---|---|---|---|
| Neue Informationen | 540.000 | $0,15/M | $0.08 |
| Zwischengespeicherte Eingabe | 2,16 Mio. | $0.03/M | $0.06 |
| Ausgabe | 120.000 | $0,50/M | $0.06 |
| Gesamt | ≈ $0,21 |
Die Kennzahlen
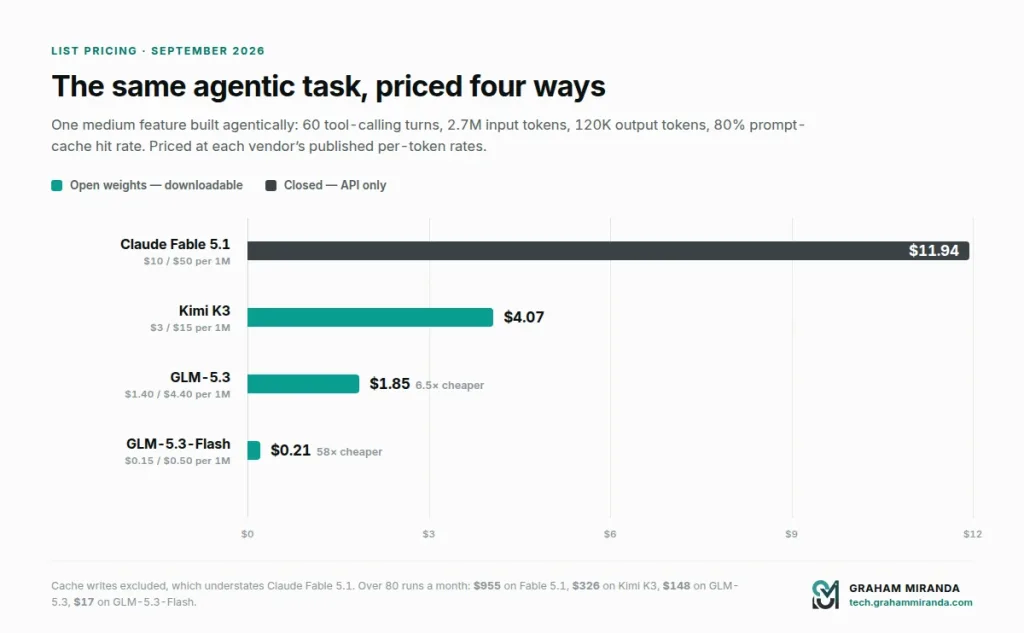
- GLM-5.3 ist 6,5-mal günstiger als Fable 5.1 für gleiche Arbeit
- Kimi K3 ist 2,9-mal günstiger als Fable 5.1
- Der GLM-5.3 ist 2,2-mal günstiger als der Kimi K3
- GLM-5.3-Flash ist 58-mal günstiger als Fable 5.1, mit einem Intelligenzindex von 57,5 gegenüber 62,1 bei ’Fable 5“
Umrechnung auf einen Arbeitsmonat
Vier solcher Aufgaben pro Tag, zwanzig Arbeitstage – 80 agentische Durchläufe:
| Modell | Monatliche Token-Kosten |
|---|---|
| Claude Fable 5.1 | ≈ $955 |
| Kimi K3 | ≈ $326 |
| GLM-5.3 | ≈ $148 |
| GLM-5.3-Flash | ≈ $17 |
Drei ehrliche Vorbehalte zu diesen Zahlen
Cache-Schreibvorgänge werden ausgeschlossen. Fable 5.1 belastet $12,50/M für 5-minütige Cache-Schreibvorgänge, und bei einer langen Sitzung werden wiederholt Schreibvorgänge in den Cache durchgeführt. Durch die Einbeziehung der Schreibvorgänge steigt der tatsächliche Wert von Fable, er sinkt nicht. Auch die Trefferquote von 80% ist für kurze Sitzungen optimistisch angesetzt.
Reasoning-Token werden als Output-Token abgerechnet. Alle drei Modelle arbeiten im „Always-on“-Modus. Insbesondere GLM-5.3 gilt als sehr ausführlich – 170 Millionen Ausgabe-Tokens gegenüber einem Medianwert von 72 Millionen in der AA-Suite –, sodass sein tatsächliches Ausgabevolumen über dem liegt, was eine naive Zählung der Turn-Anzahl vermuten lässt. Der Wert von $0,68 pro Aufgabe berücksichtigt dies bereits, weshalb ich ihm mehr vertraue als meinem eigenen, oben genannten Modell.
Der Tokenizer von Fable 5.1 erzeugt etwa 30% mehr Token als ältere Claude-Modelle für denselben Text. Wenn Sie einen Vergleich mit einer historischen Claude-Rechnung anstellen, nehmen Sie bitte eine entsprechende Anpassung vor.
Selbst nach allen drei Korrekturen ändert sich die Reihenfolge nicht und die Größenordnung kaum. Die Arbeit im „Closed-Frontier“-Modell kostet pro abgeschlossener Aufgabe etwa das Sechsfache dessen, was das beste „Open-Weight“-Modell kostet.
Bild anzeigen Dieselbe agentische Aufgabe mit 60 Zügen zum Listenpreis des jeweiligen Anbieters. Die vertikale Achse stellt das gesamte Argument für offene Gewichte dar.
Lizenzen: Was Ihnen “Open” im Jahr 2026 tatsächlich bietet
Das ist der Abschnitt, den die Leute unbedingt lesen sollten, denn der Wortschatz hat sich stark verändert, und das wird jemanden viel Geld kosten.
Weder Kimi K3 noch GLM-5.3 sind Open Source. Beide veröffentlichen herunterladbare Gewichte unter maßgeschneiderten Lizenzen mit umsatzabhängigen Bedingungen. Das unterscheidet sich erheblich von den Lizenzen des MIT oder Apache 2.0, und dieser Unterschied betrifft genau die Art von Unternehmen, die am meisten vom Selbsthosting profitieren würden.
Die Kimi-K3-Lizenz
Im Internet wird in Bezug auf K3 immer wieder von “Modified MIT” die Rede sein. Das ist falsch – damit war K2 gemeint. K3 wird unter einer eigens dafür erstellten Lizenz mit zwei unterschiedlichen Freigabestufen bereitgestellt:
Das „Model-as-a-Service“-Portal. Wenn Sie Dritten Zugriff auf die Modellinferenz oder das Fine-Tuning gewähren – wobei diese Dritten die Kontrolle über Eingaben, Parameter oder Trainingsdaten haben – und “Der Gesamtumsatz des Lizenznehmers und seiner verbundenen Unternehmen übersteigt 20 Millionen US-Dollar” innerhalb eines beliebigen Zeitraums von 12 aufeinanderfolgenden Monaten müssen Sie eine separate geschäftliche Vereinbarung mit Moonshot aushandeln. Hinweis Gesamtwert Umsatz aller verbundenen Unternehmen, nicht der Umsatz, der K3 zuzurechnen ist. Ein Beratungsunternehmen mit einem Umsatz von 25 Mio. €, das Inferenz-Dienste weiterverkauft, überschreitet die Grenze, selbst wenn das KI-Geschäft nur einen Rundungsfehler ausmacht.
Das Attributions-Gate. Produkte, die 100 Millionen aktive Nutzer pro Monat oder $20 Millionen Umsatz pro Monat “Kimi K3” muss in der Produktoberfläche deutlich sichtbar angezeigt werden.
Die wichtigste Ausnahmeregelung: Die rein interne Nutzung unterliegt keinen Einschränkungen. Der Einsatz von K3 zur Unterstützung Ihrer eigenen Entwickler, Forscher, Ihrer Rechtsabteilung oder zur Steigerung der allgemeinen Mitarbeiterproduktivität löst keine der beiden Beschränkungen aus. Für die überwiegende Mehrheit der Unternehmen – darunter im Wesentlichen auch alle meine eigenen – ist dies die relevante Klausel, und die Antwort lautet: Sie sind auf der sicheren Seite.
Die im Vergleich zu K2 neue Klausel ist die $20M-MaaS-Schwelle. K2 verlangte eine Namensnennung nur oberhalb seiner Schwellenwerte. K3 fügt eine deutlich niedrigere Umsatzschwelle hinzu, die speziell auf kommerzielle Wiederverkäufer von Inferenzmodellen abzielt. Moonshot will Sie nicht daran hindern, das Modell zu nutzen; es will lediglich verhindern, dass Cloud-Anbieter damit kostenlos ein Geschäft aufbauen.
Die glm-5.3-Lizenz
Das Flaggschiff von Z.ai schlug einen anderen Kurs ein, und dies stellt einen größeren Bruch mit der bisherigen Praxis dar, als in den meisten Berichten anerkannt wurde.
GLM-5.2 wurde unter der MIT-Lizenz veröffentlicht. GLM-5.3-Flash wurde unter der MIT-Lizenz veröffentlicht. GLM-5.3 hingegen nicht.
Die maßgeschneiderte Lizenz ermöglicht es Privatpersonen und normalen Unternehmen, das Modell ohne zusätzliche Einschränkungen zu betreiben, einzusetzen und zu optimieren. Das „Single Gate“ richtet sich an Hyperscaler: ein Unternehmen, dessen “Der Gesamtumsatz des Lizenznehmers und seiner verbundenen Unternehmen übersteigt in einem beliebigen Zeitraum von zwölf aufeinanderfolgenden Monaten insgesamt 10 Milliarden US-Dollar (oder den Gegenwert in anderen Währungen)” muss die Sicherheitsprüfung von Z.AI bestehen bevor Sie das Modell oder dessen Derivate für kommerzielle Zwecke nutzen.
Das ist eine Schwelle von $10 Milliarden. Damit sind fast alle ausgeschlossen. Zwei Details im Kleingedruckten verdienen jedoch Beachtung:
Erstens schließt die Lizenz ausdrücklich App-Entwickler aus, die das Modell in Funktionen einbinden, sowie Wiederverkäufer, die Anfragen lediglich an andere Hosts weiterleiten. Die Zielgruppe ist eng gefasst und klar definiert: Unternehmen, die Gastgeber GLM-5.3 im kommerziellen Maßstab.
Zweitens – und das ist der wirklich unangenehme Teil – In der Lizenz sind weder Kriterien noch ein Zeitplan noch ein Widerspruchsverfahren für diese Sicherheitsüberprüfung festgelegt. Darin heißt es lediglich, dass seine “Umfang und Methode … werden von Z.AI in angemessener Weise festgelegt.” Wenn Sie ein Großunternehmen sind, bedeutet dies eine uneingeschränkte Abhängigkeit vom Ermessen eines ausländischen Anbieters, und Ihr Beschaffungsteam wird dies auch so formulieren.
Ebenfalls erwähnenswert: Trotz der zweiwöchigen Aussetzung der Cyberfähigkeiten, die der Freigabe vorausging, Die Lizenz enthält keine Einschränkungen hinsichtlich der zulässigen Nutzung, keine Ausnahmen im Bereich Cybersicherheit und keine Ansprüche auf das Eigentum an den Ergebnissen. Die Sicherheitsbedenken prägten die Veröffentlichung Zeitpunkt, nicht die Veröffentlichung Begriffe.
Was ist also eigentlich noch das MIT?
GLM-5.3-Flash. 320 Milliarden Parameter, 18 Milliarden aktive, von Haus aus multimodal, unter MIT-Lizenz, 57,5 auf dem Intelligenzindex und $0,15/$0,50 pro Million Tokens – derzeit zum halben Preis im Rahmen eines Aktionsrabatts, der bis zum 9. September 2026 gilt. Wenn Sie eine echte, uneingeschränkte und freizügige Lizenzierung benötigen und nicht nur herunterladbare Gewichte, dann liegt hier derzeit die Grenze – und sie ist bemerkenswert hoch.
Die praktische Zusammenfassung
| Kimi K3 | GLM-5.3 | GLM-5.3-Flash | Fable 5.1 | |
|---|---|---|---|---|
| Gewichte zum Herunterladen | Ja | Ja | Ja | Nein |
| Open Source im OSI-Stil | Nein | Nein | Ja (MIT) | Nein |
| Restriktionsauslöser | Umsatz $20M (MaaS) | $10B-Umsatz (MaaS) | Keine | K.A. |
| Quellenangabe erforderlich | Über 100 Millionen monatlich aktive Nutzer (MAU) / $20M-Monat | Nur Urheberrechtshinweis | Nur Urheberrechtshinweis | K.A. |
| Nur für den internen Gebrauch | Nein | Nein | Nein | K.A. |
| Feinabstimmung zulässig | Ja | Ja | Ja | Nein |
| Nutzungsrichtlinien | Standard | Keine im Lizenztext | Keine | Es gelten die Nutzungsbedingungen von Anthropic |
Für ein typisches deutsches Mittelstandsunternehmen, eine Agentur oder ein Beratungsunternehmen, das Modelle intern betreibt oder in ein Produkt integriert: Alle drei offenen Optionen können ohne jegliche Verhandlungen genutzt werden. Die Beschränkungen dienen dazu, AWS zu schützen, nicht Sie. Doch der Ratschlag “Lesen Sie die Lizenz” hat sich von einer pedantischen Empfehlung zu einem echten Ratschlag gewandelt. Wenn Ihr Umsatz über 20 Millionen Euro liegt und Sie Inferenzdienste in irgendeiner Form weiterverkaufen, sollten Sie die Lizenz vor der Bereitstellung von einem Rechtsbeistand prüfen lassen.
Die wahren Argumente für offene Modelle
Ich möchte dieses Argument fundiert darlegen und nicht nur als Slogan verwenden, denn “offene Modelle sind toll” ist kein Argument, und die tatsächlichen Gründe sind interessanter als bloße Lobeshymnen.
1. Der Preisverfall ist keine Subvention, sondern strukturell bedingt.
Der instinktive Einwand gegen billige chinesische Modelle lautet, dass die Preisgestaltung auf Verlustbasis erfolgt und sich nach oben normalisieren wird. Zum Teil trifft dies sicherlich zu. Doch der strukturelle Aspekt bleibt davon unberührt: Wenn die Gewichte öffentlich sind, wird die Inferenz zu einem Rohstoffmarkt. Zwanzig Hosting-Anbieter konkurrieren um dasselbe Geschäftsmodell, und keiner von ihnen kann einen Leistungsaufschlag verlangen, da keiner über einen Wettbewerbsvorteil verfügt. Deshalb läuft GLM-5.3 mit $1,40/$4,40 und Fable 5.1 mit $10/$50, was zu einem Punktunterschied von drei Punkten führt.
Die Preisgestaltung nach dem „Closed-Model“-Prinzip umfasst die Abschreibungen für Forschung und Entwicklung, die Marge sowie die Tatsache, dass es genau einen Anbieter gibt. Die Preisgestaltung nach dem „Open-Weight“-Prinzip umfasst Stromkosten, Hardware-Abschreibungen und eine geringe Marge. Es handelt sich um unterschiedliche Geschäftsmodelle, und die Kluft wird sich nicht dadurch schließen, dass offene Modelle teurer werden.
Der Beweis dafür, dass es sich um eine dauerhafte und nicht nur um eine vorübergehende Entwicklung handelt: DeepSeek hat etwa 17% an Token-Nutzung auf Vercel bis Mai 2026 bei einem Umsatzanteil von etwa 1%. Das ist keine Preisanomalie. So sieht die Kommodifizierung in einem Diagramm aus.
2. Ausstiegsrechte verändern Ihre Verhandlungsposition, auch wenn Sie sie nie in Anspruch nehmen
Die meisten Teams, die dies lesen, werden keine eigene Serverinfrastruktur betreiben. Im Abschnitt „Hardware“ weiter unten wird erklärt, warum – Kimi K3 benötigt ein Rack. Dennoch ist diese Option durchaus sinnvoll.
Wenn Anthropic die Preise erhöht, das von Ihnen verwendete Modell auslaufen lässt, seine Nutzungsrichtlinien so ändert, dass Ihr Produkt nicht mehr funktioniert, oder ein schlechtes Quartal verzeichnet, bleibt Ihnen bei einem geschlossenen Modell nur ein Migrationsprojekt. Bei einem Open-Weight-Modell müssen Sie lediglich eine Datei herunterladen, die Sie ohnehin jederzeit hätten herunterladen können. Vielleicht werden Sie das nie tun. Die Tatsache, dass Sie könnte Das ist es, was die Beziehung zum Lieferanten zu einer geschäftlichen Beziehung macht und nicht zu einer Abhängigkeit.
Das ist keine reine Theorie. Fable 5.1 wurde am 1. September mit drei grundlegenden Änderungen veröffentlicht, von denen eine dazu führt, dass „Thinking Blocks“ ungültig werden, wenn Sie den Gesprächsverlauf für Konten bearbeiten, die nach dem 31. August erstellt wurden. Falls dieses Muster in Ihrer Architektur eine tragende Rolle spielt, müssen Sie die Neugestaltung nach dem Zeitplan von Anthropic vornehmen – und nicht nach Ihrem eigenen.
3. Der Datenaufbewahrungsort ist kein Projekt mehr
Für alle, die im Rahmen der DSGVO tätig sind, ist dies das Argument, mit dem sich Geschäfte tatsächlich abschließen lassen.
Bei einer geschlossenen API verlässt jede Anfrage Ihre Infrastruktur. Sie benötigen eine Vereinbarung mit dem Auftragsverarbeiter, eine Folgenabschätzung zur Datenübermittlung, falls sich der Auftragsverarbeiter außerhalb des EWR befindet, eine Datenflussübersicht sowie eine Antwort für Ihren Datenschutzbeauftragten darüber, was mit den gespeicherten Daten geschieht. All das ist machbar. Es bedeutet jedoch auch wochenlange Arbeit pro Anbieter, die sich jedes Mal wiederholt, wenn der Anbieter etwas ändert.
Bei Open Weights auf einer Infrastruktur, die Sie selbst kontrollieren – Ihrer eigenen Hardware oder einem deutschen oder EU-GPU-Host –, stellt sich die Frage der grenzüberschreitenden Datenübermittlung gar nicht erst, da keine Datenübermittlung stattfindet. Das Modell läuft dort, wo sich Ihre Daten bereits befinden. Die rechtliche Prüfung beschränkt sich somit auf die Prüfung der Lizenzbedingungen und nicht auf eine Bewertung der Datenübermittlung.
Für deutsche und EU-Kunden ist dies häufig der ausschlaggebende Faktor, und es lohnt sich, den Vorbehalt genau zu formulieren: Die Verwendung von GLM-5.3 über die API von Z.ai bietet Ihnen diese Möglichkeit nicht. Sie erhalten sie, indem Sie die Gewichte selbst betreiben oder indem ein Anbieter sie in Ihrem Zuständigkeitsbereich betreibt. Die Lizenz macht dies rechtmäßig; sie sorgt jedoch nicht dafür, dass dies automatisch geschieht.
4. Die Überprüfbarkeit ist real, wenn auch zu wenig genutzt
Offene Gewichte bedeuten, dass Sie die Architektur untersuchen, eigene Auswertungen am tatsächlichen Modell durchführen können – statt an einem Endpunkt, der möglicherweise unbemerkt aktualisiert wurde –, es an Ihre Hardware anpassen und für Ihren Anwendungsbereich feinabstimmen können und – was besonders wichtig ist – Eine Version dauerhaft fixieren.
Letzteres wird unterschätzt. Geschlossene APIs werden hinter stabilen Modell-IDs aktualisiert. Das Verhalten driftet ab. Prompts, die zuvor funktioniert haben, funktionieren plötzlich nicht mehr, und man kann die Änderung nicht vergleichen, weil man sie nicht sehen kann. Ein lokaler Checkpoint ist auch nach einem Jahr noch byteweise identisch.
5. Der Wettbewerbsdruck kommt allen zugute, auch den Nutzern geschlossener Modelle.
Schauen Sie sich an, was diesen Sommer passiert ist. Kimi K3 landete im Juli bei $3/$15 mit Werten, die an die Spitzenwerte grenzen. GLM-5.3 landete im August bei $1,40/$4,40 – nur einen halben Punkt davon entfernt. Und am 1. September reduzierte Anthropic die Cache-Lesevorgänge um 75%.
Ich behaupte nicht, dass hier ein direkter Kausalzusammenhang besteht – Anthropic veröffentlicht seine Preisgestaltung nicht, und die Reduzierung der Cache-Zugriffe ist eine natürliche Optimierung. Aber ein Markt mit glaubwürdigen, günstigen Alternativen weist andere Preisverhältnisse auf als einer ohne solche Alternativen, und diese Alternativen sind in diesem Jahr glaubwürdig geworden. Selbst wenn Sie ausschließlich geschlossene Modelle verwenden, sorgt das Open-Weight-Ökosystem dennoch still und leise dafür, dass Ihre Rechnungen niedriger ausfallen.
6. Nach dem Training macht man die größten Fortschritte, und es ist günstig.
Das wichtigste Ergebnis von GLM-5.3 – eine versechsfachte Verbesserung der Terminal-Bench-Leistung bei gleichen Ausgangsgewichten – ist die strategisch wichtigste Zahl in diesem gesamten Artikel, und dabei geht es gar nicht um GLM.
Demnach ist der kostspielige Teil beim Aufbau eines Frontier-Modells (Vortraining) zunehmend ein gelöstes, standardisiertes Element, während der Teil, der den Unterschied ausmacht (Nachtraining, RL-Umgebungen, Aufgabenentwurf mit langem Zeithorizont), vergleichsweise erschwinglich ist. Deshalb können vier chinesische Forschungslabore mit einer Gesamtbewertung von etwa $159 Milliarden mit amerikanischen Labors mithalten, deren Wert ein Vielfaches davon beträgt. Lamberts Einschätzung zufolge arbeiten die chinesischen Labore mit “um Größenordnungen geringerem Kapital”.”
Für alle, die davon betroffen sind, ist die Konsequenz klar: Die Zahl der seriösen Modellanbieter steigt, statt zu sinken. Planen Sie Ihre Architektur entsprechend.
7. Die Auswirkungen auf das Ökosystem verstärken sich
Qwen ist verstorben insgesamt eine Milliarde Downloads auf Hugging Face, hat Llama überholt und umfasst nun über 200.000 getaggte Modelle und mehr als 113.000 Derivate – das sind ungefähr 40% aller neuen LLM-Derivate auf der Plattform basieren auf Qwen. Dabei handelt es sich um ein Ökosystem für Tooling, Quantisierung, Feinabstimmung und Bereitstellung, das nur deshalb existiert, weil die Gewichte öffentlich zugänglich sind.
Sie profitieren von diesem Ökosystem, unabhängig davon, ob Sie selbst dazu beitragen oder nicht. GGUF-Konvertierungen, vLLM-Kernel, LoRA-Adapter, Quantisierungsrezepte, Evaluierungs-Harnesses – all das gibt es nur, weil Tausende von Menschen Zugriff auf die tatsächlichen Gewichte hatten.
8. Dort sind die Entwickler bereits hingegangen
Modelle chinesischer Herkunft bei ~61% OpenRouter-Token. Der Marktanteil US-amerikanischer Modelle ist innerhalb eines Jahres von ~70% auf ~30% gesunken. Vier der fünf am häufigsten verwendeten Modelle auf dem Router stammen aus China. Allein auf die MiMo-Modelle von Xiaomi entfallen rund 21% der weitergeleiteten Token und etwa 22% des gesamten Codierungsverkehrs.
Das Verhalten der Entwickler ist ein Frühindikator. Es war ein Frühindikator für Docker, für Postgres und für Linux. Wer dagegen gewettet hat, hat in der Vergangenheit schlechte Erfahrungen gemacht.
…und die ehrlichen Argumente dagegen
Hätte ich nur den obigen Abschnitt geschrieben, wäre dies eine Werbung.
„Open Weights“ sind kein Open Source, und die Begriffsverschiebung stellt ein echtes Problem dar. Zwei der drei hier vorgestellten Modelle werden unter maßgeschneiderten, umsatzabhängigen Lizenzen ohne OSI-Zulassung ausgeliefert. Die Klausel zur Sicherheitsüberprüfung von GLM-5.3 enthält weder veröffentlichte Kriterien noch ein Berufungsverfahren. Wenn Ihr Compliance-Rahmenwerk eine von der OSI genehmigte Lizenzierung vorschreibt, lautet die ehrliche Antwort, dass Ihnen lediglich GLM-5.3-Flash, die unter MIT-Lizenz stehenden Flaggschiff-Produkte von DeepSeek sowie eine immer kleiner werdende Liste weiterer Optionen zur Verfügung stehen.
Anbieter-Benchmarks bleiben eben Anbieter-Benchmarks. Jede von Moonshot und Z.ai veröffentlichte Kennzahl stammt aus eigenen Angaben und wurde von den Unternehmen selbst ausgewählt. Dort, wo neutrale Aggregatoren Messungen vorgenommen haben, stimmen die Zahlen im Großen und Ganzen überein – was beiden Labors wirklich hoch anzurechnen ist –, aber ’im Großen und Ganzen“ spielt in diesem Satz eine wichtige Rolle.
Für die meisten Teams ist ein eigener Server nur ein Traum. Kimi K3 hat eine Kapazität von 1,5 TB, und Moonshot empfiehlt mindestens 64 Beschleuniger. GLM-5.3 benötigt mindestens 8×H200 bei FP8. Der Ausweg nach rechts ist real; der Preis dafür ist ein Rechenzentrum.
Unterstützung ist das, was man daraus macht. Wenn Fable 5.1 ausfällt, gibt es ein Unternehmen mit einem SLA. Wenn Ihre selbst gehostete GLM-5.3-Bereitstellung an einem Freitagabend bei 300.000 Kontexten Unsinn ausgibt, gibt es ein GitHub-Issue und Ihre eigene Kompetenz.
Geopolitik ist ein wesentlicher Faktor im Beschaffungswesen. Alle drei hier besprochenen Open-Weight-Optionen stammen aus chinesischen Labors. Für einige Kunden – den öffentlichen Sektor, verteidigungsnahe Bereiche und bestimmte regulierte Branchen – ist dies ein entscheidendes Hindernis, unabhängig von den Lizenzbedingungen oder der Gewichtung. Es ist nicht meine Aufgabe, Ihnen zu sagen, ob diese Bedenken begründet sind. Meine Aufgabe ist es, Ihnen mitzuteilen, dass dieses Thema im Meeting zur Sprache kommen wird.
Bei der allgemeinen Wissensarbeit haben die geschlossenen Modelle nach wie vor die Nase vorn. GDPval-AA v2 erreicht bei Fable 5.1 einen Wert von 1.853, gegenüber 1.769 bei GLM-5.3 und 1.687 bei Kimi K3. Im Bereich der Programmierung ist der Abstand verschwunden. Bei der allgemeinen fachlichen Wissensarbeit ist dies jedoch nicht der Fall.
Bild anzeigen Herunterladbare Gewichte, drei verschiedene Saitensätze. Nur GLM-5.3-Flash unterliegt weiterhin der MIT-Lizenz.
Ollama im Jahr 2026: Die Preisänderung, auf die es wirklich ankommt
Ollama hat sich still und leise zum wichtigsten Infrastrukturbestandteil in dieser Diskussion entwickelt, und auf 31. August 2026 Die Art und Weise, wie die Abrechnung erfolgt, hat sich in einer Weise geändert, die es wert ist, genau verstanden zu werden.
Was hat sich geändert?
Ollama hat seine Pro-, Max- und Team-Tarife von der Abrechnung nach GPU-Zeit auf Branchenübliche Preisgestaltung pro Token, wobei in jedem Tarif ein Kontingent an Nutzungskrediten enthalten ist. Die vom Unternehmen angegebene Begründung ist erfrischend konkret: Modelle wie Kimi K3 machten es unmöglich, die GPU-Zeit zu prognostizieren. Wenn ein Modell 104 Milliarden Parameter aktiviert und ein anderes 3 Milliarden, hat “eine Stunde GPU” für den Zahler keinerlei Bedeutung mehr.
Die neuen Pläne
| Plan | Preis | Im monatlichen Kontingent enthalten | Parallelität |
|---|---|---|---|
| Kostenlos | $0 | Geringe monatliche Raten, Einstiegsmodelle | 1 Anfrage |
| Pro | $20/Monat (oder $200/Jahr) | $60 – Verwendung | 3 Anfragen |
| Max | $100/Monat | $300 – Nutzung | 10 Anfragen |
| Team | $500/Monat | $1.000 gemeinsam genutzt, unbegrenzte Nutzerzahl | 10 Anfragen |
| Unternehmen | Benutzerdefiniert | Benutzerdefiniert | Benutzerdefiniert |
Lies dir die Zeile „Pro“ noch einmal durch. $20 kauft $60 Token. Das entspricht einem 3-fachen Multiplikator auf das inbegriffene Nutzungsvolumen, und wenn der Pool aufgebraucht ist, zahlen Sie weiterhin genau den gleichen veröffentlichten Preis pro Token – ohne Strafstufen und ohne Servicegebühr.
Was wurde entfernt?
Das ist der Teil, der den Entwicklern tatsächlich aufgefallen ist: Keine 5-Stunden-Resets und keine wöchentlichen Obergrenzen. Jeder, der schon einmal mitten in einer Refaktorisierung in ein rollierendes Nutzungsfenster geraten ist, wird verstehen, warum das wichtiger war als der Preis. Der monatliche Pool wird zum Datum Ihres Abonnementbeginns aktualisiert, und vor allem, rollt nicht um — Passen Sie Ihren Plan also an einen normalen Monat an, nicht an den geschäftigsten.
Die Begriffe, die für die Arbeit in der EU von Bedeutung sind
Drei Verpflichtungen aus der Bekanntmachung sind für Sie von unmittelbarer Bedeutung, wenn Sie mit Kundendaten umgehen:
- Keine Datenspeicherung. Eingabeaufforderungen und Antworten werden niemals protokolliert und niemals für das Training verwendet.
- Hosting in den USA und Europa, sowie Singapur für eine begrenzte Auswahl an Qwen-Modellen.
- Transparenz der Kosten pro Anfrage In Ihrem Konto können Sie genau sehen, was jeder Anruf gekostet hat.
Für ein deutsches Beratungsunternehmen ist dies in puncto Compliance eine deutlich bessere Lösung als das, was die meisten Gateway-Anbieter bieten, auch wenn “in Europa gehostet” eher eine Angabe zum Routing als eine vertragliche Garantie für den Datenstandort ist. Wenn der Datenstandort eine zwingende Voraussetzung und keine bloße Präferenz ist, sollten Sie Ollama schriftlich darum bitten, bevor Sie davon ausgehen.
Die tatsächlichen Preise pro Token
Hier wird es interessant. Ollama veröffentlicht Preise pro Modell und orientiert sich dabei eng an den Preisen der Hersteller:
| Modell auf Ollama | Eingabe / 1M | Zwischengespeichert / 1M | Ausgabe / 1M |
|---|---|---|---|
kimi-k3 | $3.00 | $0.30 | $15.00 |
glm-5.3 | $1.40 | $0.26 | $4.40 |
mistral-large-3 | $0.50 | $0.50 | $1.50 |
gemma4 | $0.14 | $0.05 | $0.40 |
nemotron-3-super | $0.015 | $0.015 | $0.60 |
Wenden Sie die zuvor erstellten monatlichen Berechnungen darauf an. Achtzig Agentenläufe pro Monat auf GLM-5.3 kosten etwa $148 an Tokens. A Der Max-Tarif mit $100/Monat deckt eine Nutzung von $300 ab — Das bedeutet, dass dieselbe Arbeitslast, die bei Fable 5.1 etwa $955 pro Monat kosten würde, problemlos in ein Ollama-Abonnement vom Typ $100 passt, wobei noch Spielraum übrig bleibt.
Das ist das gesamte wirtschaftliche Argument des offenen Modells, zusammengefasst in einer einzigen Zeile auf einer Rechnung.
Bild anzeigen Achtzig agentische Läufe pro Monat auf GLM-5.3 passen in einen $100-Ollama-Max-Tarif, wobei noch Guthaben übrig bleibt. Für denselben Arbeitsaufwand auf Fable 5.1 fällt eine Rechnung über $955 an.
Was hat Ollama 2026 noch auf den Markt gebracht?
Die Preisänderung erfolgte nicht isoliert. In den letzten Monaten war viel los:
- 25. August – Claude Desktop-Support. Ollama fungiert nun als Drittanbieter-Gateway für Claude Desktop, sodass Sie offene Modelle über den firmeneigenen Client von Anthropic nutzen können.
- 26. August – v0.33.0. Die Integration des Claude-Desktop-Gateways wurde umgesetzt, die automatische Ausfüllfunktion für die Wiederherstellung wurde im Cache wiederhergestellt, und Ollama hat die Systemmeldung zum Token-Countdown von Claude Code deaktiviert, die den KV-Cache bei jedem Durchlauf ungültig machte. Letzteres ist eine unauffällige, aber bedeutende Leistungsverbesserung.
- 26. August – v0.33.1. MLX-Unterstützung für Qwen 3.8: „Flash Next“, strukturierte Ausgabe und eine Korrektur für GPU-Timeouts beim Laden von Modellen aus langsameren Speichern.
- 28. August – v0.33.2. Der Dunkelmodus wurde wiederhergestellt, das Handoff unter macOS wurde behoben, und die Proxy-Anfragen von Claude Desktop bleiben während der Aktualisierung des Modellkatalogs aktiv.
- 20. August – v0.32.15. Neues Onboarding für Desktop-Anwendungen und Zwischenspeicherung von Metadaten zwischen Anfragen, die die Zeit bis zum ersten Token um etwa die Hälfte verkürzen.
- 11. August – NVIDIA Nemotron 3.5 Lightning, ein 30B-Modell, das für agentische Arbeitsabläufe mit Tool-Aufrufen auf eigener Hardware optimiert ist.
- 10. August – „Muse Glimmer“ von Meta, ein multimodales 30B-Modell unter Apache 2.0, beschleunigt durch die MLX-Engine von Ollama. Angesichts des Einbruchs bei der Nutzung von Routed-Modellen durch Llama ist es bemerkenswert, dass Meta nach wie vor wirklich freizügige Gewichte bereitstellt.
- 9. Juli – Finanzierungsrunde $88M, wobei Ollama berichtet, dass 8,9 Millionen Entwickler.
- 29. Juni – Gemma 4 auf MLX bis zu 90% schneller durch Multi-Token-Vorhersagen, von denen Programmierer auf Apple Silicon überproportional profitieren.
- 5. Juni – v0.30: GGUF-Kompatibilität hinzugefügt über „llama.cpp“, wodurch die Hardwareunterstützung weit über Apple Silicon hinaus erweitert wird.
Der rote Faden dabei ist, dass Ollama nicht mehr “die einfache Möglichkeit ist, ein kleines Modell auf dem Laptop auszuführen”, sondern sich zu einem universellen Gateway entwickelt hat, das zufällig auch Modelle lokal ausführt. Der Cloud-Katalog umfasst nun kimi-k3:cloud, glm-5.3:Cloud, glm-5.3-flash, deepseek-v4-pro, deepseek-v4-flash, minimax-m3, qwen3.5 in sieben Größen, gpt-oss in 20b und 120b, gemma4, die Nemotron-3-Familie und mistral-large-3.
Einrichtung: Konfigurationen kopieren und einfügen
Ollama + Claude-Code (der schnellste Weg)
Ollama liefert einen Launcher mit einem einzigen Befehl, der die Verknüpfung mit der Umgebung für Sie übernimmt:
bash
ollama starten claudeWenn Sie es lieber manuell erledigen möchten – was Sie tun sollten, wenn Sie ein Skript dafür erstellen –, installieren Sie zunächst Claude Code:
bash
# macOS / Linux
curl -fsSL https://claude.ai/install.sh | bash

# Windows (PowerShell)
irm https://claude.ai/install.ps1 | iex
Dann richte es auf Ollama:
bash
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
Und führen Sie den Test mit einem beliebigen Modell durch:
bash
# Ein lokales Modell
claude --model qwen3.5

# Ein Cloud-Modell – beachte das Suffix :cloud
claude --model kimi-k3:cloud
Oder inline, ohne etwas global zu exportieren:
bash
ANTHROPIC_AUTH_TOKEN=ollama \
ANTHROPIC_API_KEY="" \
ANTHROPIC_BASE_URL=http://localhost:11434 \
claude --model glm-5.3:cloud
Zwei Dinge, die dir zu schaffen machen werden.
Erstens, Nicht exportieren ANTHROPIC_BASE_URL dauerhaft in Ihrem Shell-Profil. Es handelt sich um eine globale Variable, die jedes Anthropic-kompatible Tool auf Ihrem Rechner stillschweigend auf Ollama umleitet – einschließlich des Tools, das eigentlich mit Anthropic kommunizieren sollte. Sie können den Geltungsbereich pro Projekt oder pro Aufruf festlegen.
Zweitens, Stellen Sie die Kontextlänge auf 64 k oder höher ein. für alles, was mit einem echten Repository arbeitet. Die Standardeinstellung von Ollama ist kleiner, und ein Programmier-Agent, der still und leise im Hintergrund läuft, wird einfach anfangen, Dinge zu vergessen, anstatt Fehler zu melden.
Für CI-, Docker- oder skriptgesteuerte Ausführungen, --ja überspringt die interaktiven Eingabeaufforderungen:
bash
ollama launch claude --model glm-5.3:cloud --yes -- -p "Wie funktioniert dieses Repository?"GLM-5.3 direkt von Z.ai
Wenn Sie eine direkte Weiterleitung (First-Party-Routing) anstelle einer Weiterleitung über Ollama wünschen, stellt Z.ai drei Protokoll-Endpunkte zur Verfügung:
| Protokoll | Basis-URL |
|---|---|
| Anthropische Botschaften | https://api.z.ai/api/anthropic |
| OpenAI-Chat-Vervollständigungen | https://api.z.ai/api/coding/paas/v4 |
| Antworten von OpenAI | https://api.z.ai/api/v1 |
Ein OpenCode-Anbieterblock für GLM-5.3:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
 "npm": "@ai-sdk/openai-compatible",
 "name": "Z.AI",
      "options": {
 "baseURL": "https://api.z.ai/api/coding/paas/v4",
 "apiKey": "{env:ZAI_API_KEY}"
      },
 "models": {
 "glm-5.3": {
 "name": "GLM-5.3",
          "limit": { "context": 1000000, "output": 128000 },
 "options": { "reasoning_effort": "high", "temperature": 1 }
        }
 }
    }
  },
  "model": "zai/glm-5.3"
}
Wichtiger Hinweis zum Upgrade: Für GLM-5.3 muss die Schlussfolgerungsfunktion aktiviert sein. Wenn in Ihrer aktuellen Konfiguration festgelegt ist, dass thinking.type: "disabled", das wird nun fehlschlagen. Ändere es in "aktiviert" und festlegen reasoning_effort: "niedrig" falls Sie das alte Latenzprofil wiederherstellen möchten.
logische_Überlegung ist Ihr wichtigster Regler für das Verhältnis von Qualität und Kosten: niedrig bei latenzkritischen Aufrufen, hoch für umfangreiche Arbeiten, max (die Standardeinstellung) bei Problemen, die wirklich unlösbar sind hoch. Angesichts der dokumentierten Ausführlichkeit würde ich Folgendes ausführen: hoch als alltägliche Umgebung, anstatt zu gehen max und fragte mich, wo die Ausgabetoken geblieben sind.
Die Routing-Konfiguration, die ich tatsächlich empfehlen würde
Hier geht es nicht darum, sich für eine der beiden Optionen zu entscheiden. Für die meisten Teams ist eine dreistufige Routing-Tabelle die richtige Lösung, und jede seriöse Agent-Harness-Lösung unterstützt Modelle auf Agent-Ebene.
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3",
  "small_model": "ollama/gemma4",
  "agent": {
    "plan": {
 "description": "Architektur, Ursachenanalyse, alles, was bei Fehlern hohe Kosten verursacht",
 "model": "anthropic/claude-fable-5-1"
    },
    "build": {
 "description": "Der Großteil der Implementierungsarbeit",
 "model": "zai/glm-5.3",
 "options": { "reasoning_effort": "high" }
    },
    "research": {
 "description": "Lesen umfangreicher Texte, Webrecherche, Zusammenfassung aus mehreren Quellen",
 "model": "ollama/kimi-k3:cloud"
    },
    "grunt": {
 "description": "Umbenennungen, Docstrings, Test-Scaffolding, Lint-Korrekturen",
 "model": "ollama/glm-5.3-flash"
    }
  }
}
Die Begründung für jede Zeile:
- Die Planung sieht „Fable 5.1“ vor. Bei der Planung kostet dich eine schlechte Entscheidung die meisten Token im weiteren Verlauf, und genau dafür wurde 5.1 entwickelt: für die Kohärenz über einen langen Zeithorizont hinweg. Außerdem gibst du hier die wenigsten Token aus, sodass sich der Preisaufschlag nur auf den kleinsten Teil deiner Gesamtrechnung auswirkt.
- Das Gebäude erhält GLM-5.3. Das beste Preis-Leistungs-Verhältnis auf dem Markt – und der Großteil Ihrer Ausgaben für Token fließt hierhin.
- Die Forschungsabteilung erhält den Kimi K3. BrowseComp 91.2 und ein echter 1-M-Kontext machen es zur besten verfügbaren Option, um viele Informationen zu lesen und zusammenzufassen.
- Der mechanische Bereich erhält GLM-5.3-Flash. Bei $0.15/$0.50 ist es praktisch kostenlos, und die Umbenennung eines Symbols in 40 Dateien erfordert keine Frontier-Argumentation.
kleines_Modellbekommt etwas Winziges für die interne Verwaltung des Harness – Titelgenerierung, Zusammenfassung, interne Aufrufe von Hilfsfunktionen.
Sie wählen keinen Gewinner aus. Sie entwickeln ein Getriebe. Und legen Sie die Modell-IDs so fest, dass das Austauschen eines Modells nur eine Änderung in einer Zeile erfordert, denn in diesem Markt werden Sie diese Änderung noch innerhalb des Quartals erneut vornehmen müssen.
Was man tatsächlich lokal ausführen kann (die Realität in Sachen Hardware)
Lassen Sie mich eine Annahme ausräumen, bevor sie jemanden Geld kostet.
Man kann Kimi K3 oder GLM-5.3 nicht auf einer Workstation ausführen. Nicht mit einer 5090. Auch nicht mit zwei.
Kimi K3
- ~1,5 TB der Gewichte im nativen MXFP4 – und denken Sie daran, dass ist der quantisierte Kontrollpunkt, kein Ausgangspunkt für eine weitere Komprimierung
- Moonshot empfiehlt mindestens 64 Beschleuniger für den Wettkampf-Aufschlag
- Echtes Self-Hosting beginnt bei Clustern mit mehreren Knoten; in den Referenzimplementierungen kommen GB300-NVL72-Racks zum Einsatz
- Es gibt kein offizieller Eintrag in der Ollama-Bibliothek Was den lokalen Kimi K3 betrifft, gibt es keine GGUF-Umrüstung für Endverbraucher, auf die ich Sie hinweisen könnte.
- Es gibt Berichte, wonach es auf Clustern aus handelsüblichen RTX 5090-Grafikkarten läuft, aber “ein Cluster aus 5090ern” ist kein Laptop, und der Durchsatz ist nicht vergleichbar.
GLM-5.3
- ~1,5 TB in BF16, ungefähr 750 GB bei FP8
- Minimal funktionsfähiger Einzelknoten: 8× H200 (1.128 GB GPU-Speicher) bei FP8, wodurch etwa 375 GB für den KV-Cache verbleiben
- BF16 benötigt zwei 8×H200-Knoten oder einen einzelnen 8×B300-Knoten (2.304 GB)
- Ein einzelner 8×H200-Knoten in BF16 ist zu klein für die Gewichte und den Cache.
Bild anzeigen Die “Frontier Open”-Modelle benötigen ein Rack. Die 24-GB-Stufe ist der Bereich, in dem „läuft auf meinem Rechner“ tatsächlich zum Tragen kommt – und das funktioniert mittlerweile sehr gut.
Was bedeutet “lokale KI” also konkret im September 2026?
Das bedeutet eine andere Modellklasse, und diese Klasse ist wirklich gut geworden:
| Modell | VRAM | Wozu es dient |
|---|---|---|
| Qwen3.8-27B | 24 GB im 4. Quartal | Bester Allrounder auf handelsüblicher Hardware – 61,71 TP3T SWE-Bench |
| gpt-oss:20b | 16 GB | Bestes kleines Modell, anpassbarer Denk-Aufwand |
| Gemma 4 E4B | ~6 GB | Vision-Plus-Tool auf einem modernen Laptop |
| Mistral 7B | 8 GB | Schnellste Option für allgemeine Anwendungen, 40–60 Tok/Sek. |
| DeepSeek-R1 7B | 5 GB | Kettenlogik auf einer Laptop-GPU |
| Llama 4 Scout | ~55 GB im 4. Quartal | 10-M-Kontext, multimodal – das Revier der Workstations |
Ein Qwen3.8-27B, der im SWE-Benchmark 61,71 TP3T erreicht und dabei ausschließlich auf einer 24-GB-GPU für Endverbraucher ohne Netzwerkverbindung läuft, ist eine bemerkenswerte Leistung, die vor achtzehn Monaten noch wie Science-Fiction geklungen hätte. Es handelt sich dabei nicht um GLM-5.3, und es gibt auch nicht vor, dies zu sein.
Die ehrliche Darstellung: Offene Gewichte an der Grenze bringen dir Souveränität und Preis, nicht lokale Ausführung. Mit offenen Gewichten im Bereich von 7B bis 30B erhalten Sie echte lokale Ausführung zu realen, aber akzeptablen Leistungskosten, und genau in dieser Klasse ist die Anforderung “läuft auf meinem Rechner, sieht kein Netzwerk” tatsächlich umsetzbar.
Die Architektur, die für die meisten meiner Kunden funktioniert, besteht genau aus dieser Aufteilung: ein kleines lokales Modell für alles, was mit wirklich sensiblen Daten zu tun hat, und ein gehostetes „Open-Weight“-Frontier-Modell für alles andere – wobei die Gewichte eher als Absicherung denn als Einsatzplan dienen.
Wo jedes Modell tatsächlich versagt
Kein Hype. Hier sind die ehrlichen Schwächen.
Schwächen des Kimi K3
Für ein offenes Modell ist es teuer. $3/$15 bietet bei im Wesentlichen gleichem Intelligenzindex-Wert die 2,1-fache Eingaberate und die 3,4-fache Ausgaberate von GLM-5.3. Wenn Sie sich für K3 statt für GLM-5.3 entscheiden, sollten Sie sich darüber im Klaren sein, was Sie für diesen Aufpreis erhalten – in der Regel ist es der Vision-Stack oder die Browser-Leistung.
Die Lizenz hat die niedrigere Schwelle. Ein MaaS-Schwellenwert von $20M Gesamtumsatz erfasst weitaus mehr Organisationen als der Wert von $10B in GLM-5.3. Wenn der Weiterverkauf von Inferenzmodellen in irgendeiner Form Teil Ihres Geschäftsmodells ist, stellt K3 die strengere der beiden Beschränkungen dar.
Ein eigener Server ist für fast jeden unerschwinglich. 1,5 TB und mehr als 64 Beschleuniger stellen eine erhebliche infrastrukturelle Verpflichtung dar. Das Ausstiegsrecht ist hier eher theoretischer Natur als bei jedem anderen Modell in diesem Vergleich.
Umfassende Wissenspfade. Mit einem Wert von 1.687 liegt GDPval-AA v2 hinter GLM-5.3, Claude Fables und GPT-5.6 Sol Max. Es handelt sich um einen Spezialisten für Programmierung und agentische Aufgaben, der zufällig auch enorm groß ist.
Schwächen von GLM-5.3
Nur Text. Keine Bilddaten, kein Video. Wenn Ihr Arbeitsablauf die Fehlerbehebung anhand von Screenshots, Design-to-Code oder Dokumentenerkennung umfasst, ist GLM-5.3 dafür einfach nicht geeignet, und Sie benötigen stattdessen GLM-5.3-Flash, Kimi K3 oder Fable 5.1. Dies ist der häufigste Konfigurationsfehler, den Nutzer meiner Erfahrung nach begehen, da die Modell-IDs zwar ähnlich aussehen, aber nicht miteinander in Zusammenhang stehen.
Es ist ausführlich, und diese Ausführlichkeit wird in Rechnung gestellt. 170 Millionen ausgegebene Token gegenüber einem Medianwert von 72 Millionen in der gesamten AA-Suite. logische_Überlegung Standardmäßig ist max, und das Denken lässt sich nicht einfach abschalten. Planen Sie mehr Output-Token ein, als Ihre Zuganzahl vermuten lässt.
Die Lizenz unterliegt nicht mehr der MIT-Lizenz, und die Klausel zur Sicherheitsüberprüfung ist unbegrenzt. Für die meisten Leser ist dies aufgrund des Schwellenwerts $10B reine Theorie. Für alle, die sich diesem Wert nähern, ist die Klausel “Umfang und Methode werden von Z.AI in angemessener Weise festgelegt” jedoch keine, über die sich Ihre Rechtsabteilung freuen wird.
Terminal-Bench 3.0 liegt mit 28,3 hinter GPT-5.6 Sol mit 34,6 zurück. Bei dem spezifischen Benchmark, der der terminalen nativen agentischen Kodierung am nächsten kommt, liegt er hinter dem geschlossenen Wettbewerb auf derselben Skala zurück.
Es ist neu bei den offenen Gewichtsklassen. Veröffentlicht am 28. August. Die Community hat erst seit Tagen, nicht seit Monaten, Zugang dazu. Fehler, die erst im Laufe der Zeit auftreten, sind noch nicht aufgetaucht.
Schwächen von Claude Fable 5.1
Der Preis. Etwa 6,5× GLM-5.3 pro abgeschlossener agentischer Aufgabe, selbst nach dem 75%-Cache-Lese-Cut. Bei den meisten Aufgaben lässt sich diese Lücke aus Leistungsgründen nicht mehr rechtfertigen.
Drei Änderungen mit Kompatibilitätsproblemen. Die erzwungene Verwendung des Tools führt zu einem 400-Fehler. „Thinking Blocks“ lassen sich nicht rückwirkend auf ältere Modelle übertragen. Das Bearbeiten des Chatverlaufs macht „Thinking Blocks“ auf Konten ungültig, die nach dem 31. August 2026 erstellt wurden. Jeder dieser Punkte kann bei einem Upgrade zu einer Unterbrechung der funktionierenden Integration führen.
Der Aufruf paralleler Tools hat sich verschlechtert. Es gibt Berichte, dass pro Durchlauf nur ein Anruf abgewickelt wurde, während Fable 5 mehrere zusammenfasste. Bei einer langen Agenten-Schleife bedeutet das, dass Sie die tatsächliche Laufzeit doppelt bezahlen.
Keine Ausstiegsmöglichkeiten. Keine Gewichtung, kein Eigenhosting, keine Versionsfestlegung über das Angebot von Anthropic hinaus, keine Einsichtsmöglichkeit. Wenn sich etwas ändert, passt man sich an.
Der Tokenizer übertreibt Vergleiche. ~30% mehr Token als ältere Claude-Modelle für denselben Text, was historische Kostenvergleiche zugunsten von Anthropic irreführend macht, wenn man nicht aufpasst.
Das Entscheidungsmodell: Sechs Szenarien
Bild anzeigen Sechs Szenarien, sechs Antworten. Finde die Zeile, die zu deiner Woche passt.
1. “Ich möchte ein einziges Modell. Einmal einrichten, dann nicht mehr daran denken – und die Kosten im Rahmen halten.”
GLM-5.3. Nur einen halben Punkt hinter Kimi K3 und etwa drei Punkte hinter dem besten geschlossenen Modell im neutralen Index, bei $1,40/$4,40. Führen Sie es mit einem Pro- oder Max-Abonnement über Ollama aus und stellen Sie Denkaufwand: hoch, und mach mit deiner Arbeit weiter. Das Einzige, was dich davon abhalten könnte, diese Lösung zu wählen, ist die Notwendigkeit von Bilddaten.
2. “Meine Arbeit ist visuell – Benutzeroberflächen, Design-to-Code, Fehlerbehebung anhand von Screenshots, Dokumente.”
Kimi K3 oder GLM-5.3-Flash, nicht GLM-5.3. MoonViT-V2 von K3 verarbeitet Text, Bilder und Videos nativ und erreicht im MMMU-Pro-Test 81,6 von 83,4 Punkten. GLM-5.3-Flash ist die kostengünstige Option mit nativer Multimodalität und einer MIT-Lizenz. GLM-5.3 ist rein textbasiert und lehnt die Eingabe schlichtweg ab.
3. “Lange autonome Sitzungen, in denen Fehler teuer zu stehen kommen.”
Claude Fable 5.1. Genau dafür wurde es entwickelt, und die Benchmark-Ergebnisse belegen dies: Terminal-Bench-Science hat sich verdoppelt – 821 TP3T bei den anspruchsvollsten Computer-Aufgaben von Browserbase im Vergleich zu 741 TP3T beim Opus 5 – und die größten veröffentlichten Zuwächse bei mehrstündiger agentischer Arbeit erzielt. Die Cache-Lese-Reduzierung um 751 TP3T macht genau diese Arbeitslast um bis zu 451 TP3T kostengünstiger als zuvor. Man zahlt den Aufpreis dort, wo ein Fehler mehr kostet als die Token.
4. “Die Datenspeicherung innerhalb der EU ist eine zwingende Voraussetzung.”
GLM-5.3-Flash, wenn Sie MIT benötigen, GLM-5.3, wenn Sie Leistungsfähigkeit benötigen. Hosten Sie das Modell selbst auf Ihrer eigenen Hardware oder bei einem EU-GPU-Anbieter, dann stellt sich die Frage der grenzüberschreitenden Datenübermittlung gar nicht erst. Planen Sie für GLM-5.3 bei FP8 8×H200 ein; Flash ist mit 320B/18B weitaus überschaubarer. Falls ein Eigenbetrieb das Budget sprengen würde, ist das Europa-Hosting von Ollama ohne Datenspeicherung der pragmatische Mittelweg – lassen Sie sich die Verpflichtung zur Speicherung in Europa jedoch schriftlich bestätigen, anstatt sie nur aus einer Marketingseite abzuleiten.
5. “Kleines Team, knappes Budget, den ganzen Tag programmieren.”
GLM-5.3-Flash als Standard, GLM-5.3 für schwierige Probleme, Ollama Pro mit $20. Flash kostet $0,15/$0,50 – derzeit bis zum 9. September nur die Hälfte davon – und erreicht 57,5 Punkte im Intelligenzindex. Für 20 Dollar erhält man Tokens im Wert von 60 Dollar ohne wöchentliche Obergrenzen. Für ein Team aus zwei bis vier Personen ist dies nahezu unschlagbar. Der GLM-Coding-Plan für $18 pro Monat (Lite) ist die Alternative, wenn Sie eine feste Quote einem Guthabenpool vorziehen.
6. “Ich muss das gegenüber der Beschaffungs- oder Rechtsabteilung begründen.”
GLM-5.3-Flash. Es ist das einzige Modell in diesem Vergleich, das unter einer von der OSI anerkannten Standardlizenz (MIT) steht, es ist von Haus aus multimodal, erreicht einen Wert von 57,5 auf dem Neutralitätsindex, und die Gewichte sind auf Hugging Face verfügbar – ohne Umsatzbarrieren, ohne Namensnennungspflicht und ohne Klausel zur Sicherheitsüberprüfung. Wenn es um die Frage geht, “was wir bei einer Vertragsprüfung verteidigen können”, übertrifft eine freizügige Lizenzierung jedes Mal den Benchmark um drei Punkte.
Was ich im nächsten Quartal im Auge behalten werde
Ob „Fable 5.1“ im Artificial Analysis-Index einen Wert über 62,1 erreicht. Es wurde am Tag vor der Veröffentlichung dieses Artikels veröffentlicht und wurde noch nicht unabhängig bewertet. Die Unterschiede in den Benchmark-Ergebnissen gegenüber “Fable 5” lassen zwar vermuten, dass es so sein sollte, aber “sollte” ist nicht gleich ’war“, und der Abstand zu den 59,7 von „Kimi K3“ ist der Wert, um den sich die gesamte Debatte um „offen versus geschlossen“ dreht.
Ob sich die Lizenzverschiebung fortsetzt. Innerhalb von acht Wochen sind wir von GLM-5.2 unter MIT zu GLM-5.3 unter einer maßgeschneiderten Lizenz mit einer Ermessensprüfung der Sicherheit übergegangen und von Kimi K2s modifizierter MIT-Lizenz zu den umsatzabhängigen Bedingungen von K3. Sollten GLM-6 und K4 noch restriktiver werden, wird ’Open Weights’ eher zu einem Marketingbegriff als zu einer aussagekräftigen Kategorie. Dass GLM-5.3-Flash weiterhin unter der MIT-Lizenz bleibt, ist das Gegenzeichen, das es im Auge zu behalten gilt.
Ob andere Labore das Modell der schrittweisen Veröffentlichung von Z.ai übernehmen. Eine zweiwöchige Zurückhaltung mit einer veröffentlichten Sicherheitsbegründung ist die neue Norm. Wenn sie Bestand hat, ist sie sinnvoll. Wenn sie jedoch zum Grund dafür wird, dass die Lieferungen immer später erfolgen, ist dies ein sanfter Weg dahin, sie gar nicht mehr auszuliefern.
Unabhängige Überprüfung der Angaben zu den Cyberfähigkeiten. 2.436 Sicherheitslücken in 269 Projekten sind eine außergewöhnlich hohe Zahl, die zudem ausschließlich auf Selbstauskünften beruht. Eine unabhängige Stelle muss diese Zahlen überprüfen, denn sollten sie zutreffen, würde dies die gesamte Debatte um die Sicherheit von Open-Weights neu definieren – und sollten sie nicht zutreffen, handelte es sich um effektives Marketing.
Die Preise pro Token von Ollama in sechs Monaten. Ein Verhältnis von $20 zu $60 bei der Nutzung ist eine aggressive Einstiegsstrategie eines Unternehmens, das im Juli $88M eingeworben hat. Ob diese Multiplikatoren der Realität der tatsächlichen Stückkosten standhalten, ist die wichtigste Variable in der These der “kostengünstigen offenen Modelle” für kleine Teams.
Ob lokale Modelle auf der 30B-Stufe schließen. Qwen3.8-27B mit 61,71 TP3T auf einem SWE-Bench mit 24 GB ist das am wenigsten beachtete Ergebnis des Jahres. Die „Frontier“-Instanz sorgt für Schlagzeilen; doch erst die 24-GB-Stufe verändert entscheidend, was ein normales Unternehmen ohne API-Schlüssel leisten kann.
Häufig gestellte Fragen
Ist Kimi K3 wirklich Open Source? Nein. Die Gewichte von Kimi K3 können kostenlos von Hugging Face heruntergeladen werden, unterliegen jedoch einer eigens festgelegten ’Kimi K3-Lizenz“ und nicht einer von der OSI anerkannten Open-Source-Lizenz. ”Model-as-a-Service“-Anbieter, deren Gesamtumsatz in einem beliebigen zusammenhängenden Zeitraum von 12 Monaten $20 Millionen übersteigt, müssen eine separate kommerzielle Vereinbarung mit Moonshot aushandeln, und Produkte mit mehr als 100 Millionen aktiven Nutzern pro Monat oder einem monatlichen Umsatz von $20 Millionen müssen in ihrer Benutzeroberfläche den Hinweis ”Kimi K3“ anzeigen. Die rein interne Nutzung unterliegt keinen Einschränkungen.
Ist der GLM-5.3 besser als der Kimi K3? Beim neutralen Gesamtindex liegen sie praktisch gleichauf – 59,5 gegenüber 59,7 bei Artificial Analysis. GLM-5.3 ist pro agentischer Aufgabe 2,2-mal kostengünstiger und schneidet bei der Wissensarbeit besser ab (GDPval-AA v2: 1.769 gegenüber 1.687). Kimi K3 ist von Haus aus multimodal, führt beim agentischen Browsen (BrowseComp 91,2) und belegte den ersten Platz in der Frontend-Code-Arena von Arena.AI. Entscheiden Sie sich für GLM-5.3 bei Kosten- und textbasierten Programmieraufgaben; für Kimi K3 bei Bildverarbeitung, Browsing und langfristiger Forschung.
Um wie viel günstiger sind offene Modelle als der Claude Fable 5.1? Bei einer modellierten agentenbasierten Aufgabe mit 60 Durchläufen kostet GLM-5.3 etwa $1,85, während Fable 5.1 $11,94 kostet – GLM-5.3 ist also etwa 6,5-mal günstiger. Kimi K3 kostet etwa $4,07 und ist damit etwa 2,9-mal günstiger. GLM-5.3-Flash kostet etwa $0,21 und ist damit etwa 58-mal günstiger. Bei über 80 Durchläufen pro Monat entspricht dies $148 gegenüber $955.
Kann ich Kimi K3 oder GLM-5.3 lokal ausführen? Nicht auf handelsüblicher Hardware. Kimi K3 benötigt selbst in seinem nativen MXFP4-Format etwa 1,5 TB, und Moonshot empfiehlt 64 oder mehr Beschleuniger. GLM-5.3 benötigt mindestens 8×H200 (1.128 GB) bei FP8. Für eine echte lokale Ausführung sollten Sie sich Qwen3.8-27B (24 GB bei Q4), gpt-oss:20b (16 GB) oder Gemma 4 E4B (~6 GB) ansehen.
Was hat sich in Claude Fable 5.1 geändert? Veröffentlicht am 1. September 2026. Die Cache-Lesezugriffe sanken um 75% von $1,00 auf $0,25 pro Million Token, wodurch typische Workloads um etwa 25% und agentische Workloads um bis zu 45% kostengünstiger wurden; Eingabe und Ausgabe blieben bei $10/$50. Terminal-Bench 4.0 stieg von 42,0% auf 55,8%, Terminal-Bench-Science von 24,71 TP3T auf 52,61 TP3T und AutomationBench von 17,11 TP3T auf 31,41 TP3T. Drei grundlegende Änderungen betreffen die erzwungene Tool-Verwendung, die Portabilität von Thinking-Blocks und die Bearbeitung des Verlaufs.
Wie sieht die neue Preisgestaltung von Ollama aus? Ab dem 31. August 2026 gelten für die Tarife „Pro“, „Max“ und „Team“ Preise pro Token mit enthaltenen Guthaben: Pro: 1 TP4T20/Monat für eine Nutzung von 1 TP4T60, Max: 1 TP4T100 für 1 TP4T300, Team: 1 TP4T500 für 1 TP4T1.000, die auf eine unbegrenzte Anzahl von Nutzern aufgeteilt werden. Die 5-Stunden- und Wochenobergrenzen wurden vollständig abgeschafft, es fallen keine Servicegebühren an, Guthaben werden nicht übertragen, und alle Tarife sehen keine Datenspeicherung vor, wobei das Hosting in den USA und Europa erfolgt.
Welches dieser Modelle unterliegt tatsächlich einer MIT-Lizenz? Nur GLM-5.3-Flash – ein eigenständiges, nativ multimodales 320B/18B-Modell, das am 26. August 2026 veröffentlicht wurde und beim „Artificial Analysis“-Index einen Wert von 57,5 bei $0,15/$0,50 pro Million Token erreicht. GLM-5.3 und Kimi K3 nutzen beide maßgeschneiderte, umsatzabhängige Lizenzen; Claude Fable 5.1 ist vollständig proprietär.
Warum kann ich diese Modelle nicht auf Terminal-Bench vergleichen? Da sie jeweils mit einer anderen Version getestet wurden. Die 88,3 von Kimi K3 stammen aus Terminal-Bench 2.1, die 28,3 von GLM-5.3 aus Version 3.0 und die 55,8 von Fable 5.1 aus Version 4.0. Jede Version ist deutlich schwieriger als die vorherige, daher sind die Werte nicht auf derselben Skala. Vergleiche daher nur innerhalb einer Version. Bei Terminal-Bench 2.1 beispielsweise erzielt Kimi K3 einen Wert von 88,3 gegenüber 88,0 bei Claude Fable 5, 88,8 bei GPT-5.6 Sol und 84,3 bei GLM-5.3-Flash – dieser Vergleich ist aussagekräftig und es lohnt sich, ihn anzuführen.
Soll ich Ollama nutzen oder mich direkt an den Anbieter wenden? Entscheiden Sie sich für Ollama, wenn Sie eine einzige Abrechnungsbeziehung, eine einzige API-Schnittstelle, einen einfachen Modellwechsel und Hosting in der EU bzw. den USA ohne Datenspeicherung wünschen – die Preise pro Token orientieren sich eng an den First-Party-Preisen. Wählen Sie Direct, wenn Sie First-Party-Funktionen wie die von Z.ai benötigen. logische_Überlegung Kontrollen mit voller Genauigkeit, Anbieter-SLAs oder Abonnementmodelle wie der GLM-Coding-Plan. Viele Teams nutzen beides und entscheiden je nach Arbeitslast, welche Variante zum Einsatz kommt.
Unterstützt GLM-5.3 Bilder? Nein. GLM-5.3 ist ein reines Textmodell. GLM-5.3-Flash – trotz des ähnlichen Namens ein völlig anderes Modell – ist von Haus aus multimodal und verarbeitet Text, Bilder, Videos und Dateien. Das Senden von Bildern an die falsche Modell-ID ist der häufigste Anfängerfehler bei der GLM-Familie.
Das Fazit
Vor zwölf Monaten lautete die Frage in der Open-Weight-Klasse, ob diese Modelle einsatzfähig seien. Vor sechs Monaten ging es darum, ob sie wettbewerbsfähig seien. Im September 2026 lautet sie nun tatsächlich: Wofür zahlst du eigentlich immer noch einen Aufpreis für ein geschlossenes Modell?
Auf diese Frage gibt es eine konkrete Antwort, und sie ist enger gefasst als früher. Claude Fable 5.1 ist führend bei den anspruchsvollsten, lang andauernden agentenbasierten Aufgaben, bei allgemeinen Wissensaufgaben und bei der Art von Debugging, bei der ein Modell ein unübersichtliches Problem stundenlang im Kopf behalten muss, ohne vom Kurs abzuweichen. Der „Cache-Read-Cut“ des 75% von Anthropic zielt genau auf diese Arbeitslast ab. Wenn Ihre Ausfallkosten Ihre Token-Kosten übersteigen, ist dieser Aufpreis rational.
In allen anderen Bereichen hat sich die Rechnung geändert. GLM-5.3 erreicht einen Indexwert von 94% im Vergleich zu Claude Opus 5 bei Kosten von 29%. Kimi K3 erreicht 88,3 Punkte im Terminal-Bench 2.1 gegenüber 88,0 Punkten von Claude Fable 5 in derselben Version und belegte in der ’Frontend Code Arena’ von LMArena den ersten Platz vor beiden geschlossenen Flaggschiff-Modellen. Ollama verkauft Ihnen $60 Token für $20 und hebt dabei die Nutzungsbeschränkungen auf. Diese Kombination gab es im Frühjahr noch nicht.
Aber lassen Sie sich von Ihrer Begeisterung nicht davon abhalten, das Kleingedruckte zu lesen, denn es gibt zwei davon, und beide sind wichtig.
Der erste Punkt ist die Lizenzierung. “Open Weights” und “Open Source” bedeuten mittlerweile stillschweigend nicht mehr dasselbe. Sowohl Kimi K3 als auch GLM-5.3 werden unter maßgeschneiderten, umsatzabhängigen Lizenzen ausgeliefert. Die Hürden sind hoch genug, dass die meisten Leser davon nicht betroffen sind – doch “die meisten Leser sind davon nicht betroffen” ist nicht dasselbe wie “uneingeschränkt”, und die undefinierte Klausel zur Sicherheitsüberprüfung in GLM-5.3 stellt für große Unternehmen ein echtes Beschaffungsrisiko dar. GLM-5.3-Flash unter der MIT-Lizenz ist die letzte vollständig freizügige Option, die an die Grenzen des Möglichen stößt – und genau deshalb verdient sie mehr Aufmerksamkeit, als ihr zuteilwird.
Zweitens ist das Selbsthosting meist eher ein Wunschtraum. 1,5 TB an Gewichten und 64 Beschleuniger sind kein Ausstiegsplan für ein mittelständisches Unternehmen. Was offene Gewichte auf dieser Ebene bieten, sind ein wettbewerbsorientierter Inferenzmarkt, Preistransparenz, Versionsbindung, Wahl der Rechtsordnung und eine Verhandlungsposition. Das ist sehr viel wert. Das ist nicht dasselbe, als würde man das Ganze in seinem Keller betreiben.
Die Konfiguration, die ich tatsächlich aufbauen würde: GLM-5.3 als Standard, Fable 5.1 für die Planung und die wirklich kniffligen Probleme, Kimi K3 für Zukunftsvisionen und langfristige Forschung, GLM-5.3-Flash für die Routinearbeit und ein lokales 27B-Modell für alles, was das Gebäude auf keinen Fall verlassen darf. Routen Sie nach Arbeitslast, nicht nach Loyalität. Schreiben Sie Ihre Konfiguration so, dass sich die Modell-IDs mit einer einzigen Zeile ändern lassen.
Denn die einzige Prognose, bei der ich mir sicher bin, ist, dass dieser Artikel noch vor Weihnachten aktualisiert werden muss.
Setzen Sie eines dieser drei Modelle in der Produktion ein? Mich interessiert insbesondere, ob sich die Ausführlichkeit von GLM-5.3 bei großem Maßstab als echtes Kostenproblem bemerkbar macht und ob jemand die Kimi-K3-Lizenz tatsächlich einem Rechtsberater vorgelegt und eine klare Einschätzung zur MaaS-Definition erhalten hat. Melden Sie sich bei mir – Korrekturen und Gegenargumente sind willkommen, und dieser Artikel wird aktualisiert, sobald sich die Lage ändert.
Zuletzt aktualisiert: 2. September 2026.