 Español
 English
 Deutsch
 Italiano
 Français

Hace seis semanas habría escrito este artículo de otra manera.
En julio, Moonshot AI publicó en Hugging Face un modelo de vanguardia con 2,8 billones de parámetros y permitió que cualquiera pudiera descargarlo. El 28 de agosto, Z.ai publicó por fin los pesos del GLM-5.3 que llevaba dos semanas reteniendo, tras descubrir que su propio modelo podía encadenar vulnerabilidades de formas que nadie le había pedido. Y el 1 de septiembre, Anthropic lanzó Claude Fable 5.1 y redujo el coste del trabajo de los agentes hasta en 451 TP3T sin modificar el precio de referencia.
Tres modelos. Tres respuestas totalmente diferentes a la pregunta de qué le debe un laboratorio de IA a la sociedad. Y, por primera vez desde que empezó todo esto, las opciones de «ponderación abierta» no son la solución de compromiso.
Esa es la historia real de finales de 2026, y da para unas ocho mil palabras, porque es en los detalles donde residen todo el dinero y todos los errores.
He recopilado los documentos de arquitectura, las fichas de modelos, los textos de las licencias —con todo detalle, línea por línea, porque dos de los tres no son lo que la gente suele llamar así—, las pruebas de rendimiento de los proveedores, las puntuaciones de los agregadores independientes, las tasas reales por token y la flamante hoja de precios de Ollama. A continuación, he calculado los costes basándome en un mes laboral normal, en lugar de en un escenario de día de lanzamiento.
Esto es lo que ha salido.
En resumen — El veredicto en 60 segundos
GLM-5.3 es, con diferencia, la mejor opción en inteligencia artificial en este momento. Según Artificial Analysis, se sitúa a menos de medio punto de Kimi K3 y a unos tres puntos y medio por detrás de Claude Opus 5, con $1,40 de entrada y $4,40 de salida por millón de tokens. En la misma tarea de agente, cuesta aproximadamente una sexta parte de lo que cuesta Fable 5.1. Los pesos se pueden descargar. Si quieres un modelo al que orientar a tu agente y no diriges un negocio con $10 mil millones de ingresos, este es el adecuado.
Kimi K3 es lo mejor que puedes descargar legalmente. 2,8 billones de parámetros, 104 000 millones activos, un contexto auténtico de 1 millón, visión nativa, la mejor puntuación en navegación agencial que se haya publicado hasta la fecha (BrowseComp 91,2) y —la cifra que debería poner fin al argumento de que “los modelos abiertos van por detrás”— 88,3 en Terminal-Bench 2.1, frente a los 88,0 de Claude Fable 5 y los 88,8 de GPT-5.6 Sol en la misma versión. Además, cuesta $3/$15 —más del doble que el GLM-5.3— y sus 1,5 TB de pesos requieren un rack, no una estación de trabajo. Es el modelo que se utiliza cuando la tarea es difícil y larga, y el modelo al que se recurre cuando alguien te dice que los pesos abiertos están una generación por detrás.
El Claude Fable 5.1 sigue siendo el modelo al que se recurre cuando cometer un error sale caro. Lidera el sector en lo que respecta al trabajo agente sostenido durante varias horas y a la laboriosa depuración que nunca queda reflejada de forma clara en una tabla de clasificación. Anthropic redujo las lecturas de caché en 75% el 1 de septiembre, lo que hace que las sesiones largas de los agentes sean mucho más económicas de lo que eran. Además, cuesta seis veces más que GLM-5.3 por tarea, es de acceso cerrado y ahora incluye restricciones contra la destilación que impiden el funcionamiento de algunas integraciones existentes.
La frase concisa y sincera: Los modelos de peso abierto han reducido la brecha de capacidad a algo así como entre tres y cinco meses, y han eliminado por completo la diferencia de precio. Lo que realmente estás comprando a Anthropic en septiembre de 2026 es fiabilidad en las tareas más difíciles de 10%, y el derecho a no tener que preocuparte por nada de esto.
Y el giro que nadie se atreve a decir en voz alta: Ni Kimi K3 ni GLM-5.3 se distribuyen ya bajo una licencia de código abierto. Ambos han pasado este verano a condiciones personalizadas, sujetas a ingresos. Peso abierto, sí. Código abierto, no. Lee la sección sobre licencias antes de que lo haga tu equipo jurídico.
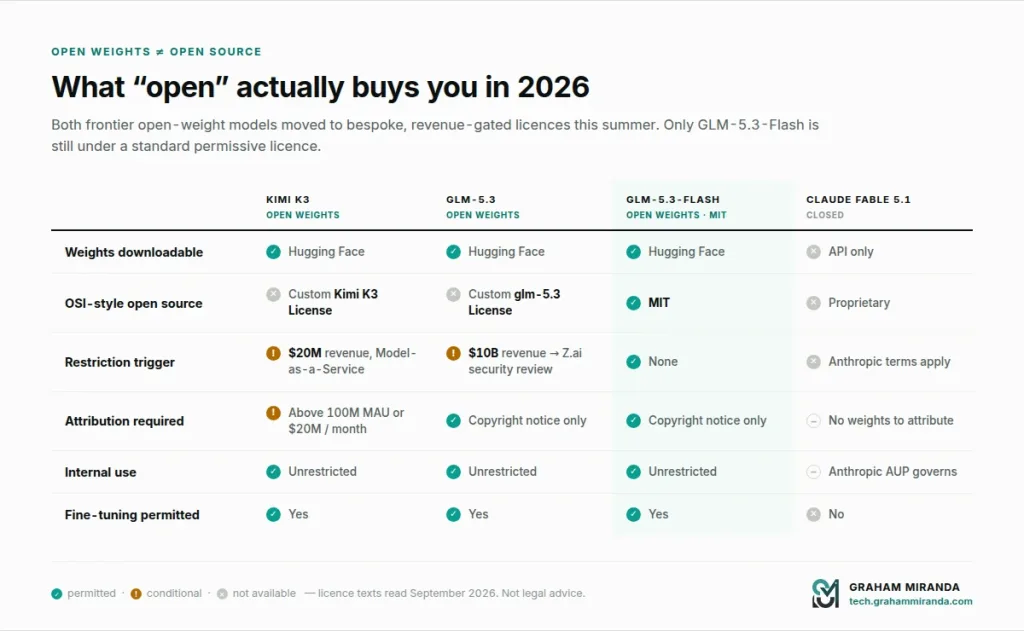
Tabla de comparación rápida
| Kimi K3 | GLM-5.3 | Claude Fable 5.1 | |
|---|---|---|---|
| Fabricante | Moonshot AI | Z.ai (Zhipu AI) | Antropico |
| Publicado | 16 de julio de 2026 (API) · 27 de julio (pesos) | 14 de agosto de 2026 (API) · 28 de agosto (pesos) | 1 de septiembre de 2026 |
| Peso disponible | Sí | Sí | No |
| Licencia | Licencia Kimi K3 (personalizada, con restricciones de ingresos) | Licencia glm-5.3 (personalizada, con restricción en función de los ingresos) | Propietario |
| Parámetros totales | 2,8 T | 753B | No revelado |
| Activo por token | 104B (16 de 896 expertos) | ~40 mil millones (estimación) | No revelado |
| Arquitectura | KDA + residuos de atención, LatentMoE estable, 69 capas de KDA + 24 capas de MLA con compuerta | El modelo MoE, con la misma base que el GLM-5.2, solo obtiene mejoras tras el entrenamiento. | No revelado |
| Ventana de contexto | 1,048,576 | 1,000,000 | 1,000,000 |
| Potencia máxima | 131 072 impagos (hasta 1 048 576) | 128,000 | 128,000 |
| Entrada multimodal | Texto, imagen, vídeo (MoonViT-V2) | Solo texto | Texto, imagen |
| Reflexión | Siempre activo | Siempre activo, esfuerzo_de_razonamiento mín./máx./máx. | Siempre activo, adaptativo, esfuerzo por mensaje (beta) |
| Precio de entrada / 1M | $3.00 | $1.40 | $10.00 |
| Entrada almacenada en caché / 1M | $0.30 | $0.26 | $0.25 |
| Precio de venta / 1 millón | $15.00 | $4.40 | $50.00 |
| Índice de Inteligencia de AA | 59.7 | 59.5 | Aún no se ha puntuado (Fable 5: 62,1) |
| Coste por tarea de evaluación de AA | $0.84 | $0.68 | — (Opus 5: $2.34) |
| Huella de autoalojamiento | ~1,5 TB (MXFP4 nativo) | ~1,5 TB BF16 / ~750 GB FP8 | N/A |
| Sobre Ollama | kimi-k3:cloud | glm-5.3:nube | A través de Claude Code / Claude Desktop como cliente |
Todos los precios son precios de catálogo del fabricante. Las cifras de Artificial Analysis proceden de la instantánea del índice de septiembre de 2026; Fable 5.1 se lanzó el 1 de septiembre y, en el momento de redactar este artículo, aún no había sido evaluado de forma independiente.
Por qué esta comparación a tres bandas es la que realmente importa
Durante dos años, el debate entre «abierto» y «cerrado» se mantuvo en un equilibrio cómodo: los modelos cerrados eran mejores, los abiertos eran más baratos, y cada uno elegía su posición en esa disyuntiva. Todo el mundo sabía cuál era su postura.
Esa forma se rompió este verano.
Nathan Lambert, que realiza un seguimiento de este tema con más detenimiento que casi nadie, sitúa la brecha actual de capacidad entre los modelos de peso libre de vanguardia y los de peso cerrado de vanguardia en de tres a cinco meses — lo que supone un descenso respecto a los seis a nueve meses que se barajaban hace un año. En el momento en que escribió el artículo, Kimi K3 ocupaba el puesto #2 en el índice Vals AI y se situaba cerca de la cima del índice de Artificial Analysis, solo superado por Claude Fable y GPT-5.6 Sol Max. La instantánea del índice de septiembre que utilizo más adelante en este artículo lo sitúa en cuarto lugar, por detrás de Grok 4.6. Sea como sea: eso no es “bueno para un modelo abierto”. Es un puesto en el podio.
Mientras tanto, los datos de uso han dado un giro realmente sorprendente. Los modelos de origen chino han captado aproximadamente 61% de todos los tokens enrutados a través de OpenRouter para mayo de 2026. La cuota estadounidense de ese tráfico se desplomó de unos 70% a unos 30% en doce meses. Llama, de Meta —el modelo que inició la ola de los modelos de peso abierto—, cayó por debajo de los 1% de volumen enrutado. La cuota de Google pasó de unos 371 TP3T a 131 TP3T. El propio estudio de 100 billones de tokens realizado por OpenRouter en colaboración con a16z reveló que los modelos de peso abierto representaban aproximadamente un tercio de todo el volumen de tokens de la plataforma.
Se puede discutir sobre qué representa el tráfico de OpenRouter. Sobrerrepresenta a los desarrolladores, a los aficionados y a las cargas de trabajo en las que el coste es un factor determinante, y subestima los contratos empresariales que nunca pasan por un router. De acuerdo. Pero es el mayor conjunto de datos público del que disponemos sobre lo que la gente elige realmente cuando puede elegir libremente, y la tendencia es inequívoca.
Así pues, la pregunta en septiembre de 2026 ya no será “¿son ya lo suficientemente buenos los modelos abiertos?”. Será mucho más concreta:
Si hay tres modelos que cumplen los requisitos, ¿cuál le recomendarías a tu agente? ¿Y cuánto te cuesta realmente equivocarte?
Esa es una cuestión que tiene que ver con los puntos de referencia, los precios, las licencias y la infraestructura, más o menos en ese orden según la importancia que la gente les da, y exactamente en el orden inverso según la importancia que realmente tienen.
Qué es realmente el Kimi K3
Moonshot AI anunció Kimi K3 el 16 de julio de 2026 y publicó todos los pesos el 27 de julio. Se trata, por número de parámetros, del modelo de peso abierto más grande que se haya publicado jamás: 2,8 billones de parámetros en total, aproximadamente 75% más que DeepSeek V4 Pro.
Esa cifra es menos impresionante de lo que parece y más impresionante de lo que parece, en ese orden.
La arquitectura, en un lenguaje sencillo
Kimi K3 es un modelo de mezcla de expertos que activa 104 000 millones de parámetros por token, seleccionando a 16 expertos de un conjunto de 896. Así pues, aunque el total es de 2,8 T, cada paso hacia adelante afecta a menos de 41 TP3T de los pesos. De ahí radica el interés económico: un enorme volumen de conocimiento almacenado y un coste de inferencia moderado.
Lo más interesante desde el punto de vista de la ingeniería está en la pila de atención. K3 utiliza 93 capas formadas por 69 capas KDA (Kimi Delta Attention) y 24 capas Gated MLA — un diseño híbrido que combina atención lineal y atención completa con una relación de intercalación de aproximadamente 3:1. KDA es una variante de la atención lineal que se ejecuta en tiempo lineal en relación con la longitud de la secuencia, en lugar de en tiempo cuadrático, lo que hace que el contexto de 1 millón sea económicamente viable y no solo una promesa publicitaria. Moonshot informa de hasta un 75%: reducción de la caché KV y hasta Rendimiento de decodificación 6 veces mayor con un contexto de 1 M como consecuencia de ello.
Encima hay una capa de Atención a los residuos (AttnRes), que Moonshot describe como un sustituto directo de las conexiones residuales estándar, y un MoE latente estable marco para el enrutamiento. Se afirma que esta combinación ofrece aproximadamente un Mejora de 2,5 veces en la eficiencia global de escalado frente a Kimi K2.
La visión proviene de MoonViT-V2, un codificador de 401M parámetros, y es nativo, no un complemento añadido: K3 gestiona texto, imágenes y vídeo en un solo modelo.
Otro detalle importante para cualquiera que esté pensando en el autoalojamiento: K3 se entrenó con Entrenamiento nativo de MXFP4 con consideración de la cuantificación, con expertos en MXFP4 y activaciones en MXFP8. No se trata de una cuantificación a posteriori. El punto de control publicado es el modelo cuantificado, razón por la cual los 2,8 billones de parámetros se sitúan aproximadamente en 1,5 TB en el disco en lugar de los ~5,6 TB que necesitaría un punto de control de BF16 de ese tamaño.
La historia de referencia
Las cifras publicadas por Moonshot son sólidas en todos los ámbitos y, cosa poco habitual, varias de ellas han resistido el escrutinio de evaluaciones independientes:
- Terminal-Bench 2.1: 88,3 — la puntuación más alta publicada en esa versión de la prueba de rendimiento
- FrontierSWE: 81,2
- DeepSWE: 67,5
- BrowseComp: 91,2 — Estado actual de la investigación sobre la web agentiva
- GPQA Diamond: 93,5
- MMMU-Pro: 81,6 / 83,4 (visión)
- Maratón de SWE: 91,0
- OfficeQA Pro: 81,3
- AutomationBench: 30,8
- LMArena Frontend Code Arena: 1.679 Elo — primer puesto, por delante de Claude Fable 5 (1.631) y GPT-5.6 Sol (1.618), y se ha impuesto en seis de los siete ámbitos de frontend
Esto último merece una reflexión. Un modelo de peso abierto que se puede descargar gratis se alzó con el primer puesto en una competición de programación de interfaces basadas en las preferencias humanas, por delante de los modelos cerrados insignia de los dos laboratorios mejor financiados del mundo. Independientemente de lo que se piense sobre las pruebas comparativas de este tipo como metodología, se trata de una noticia que habría sido impensable en 2025.
En los índices agregados, se sitúa ligeramente por debajo: 59,7 en el Índice de Inteligencia Artificial Analítica, tercero en la clasificación general, por detrás de Claude Opus 5 (63,0) y Claude Fable 5 (62,1). Las propias cifras de Moonshot — GDPval-AA v2 en 1.687 y Maletín AA a 1.527 — lo sitúan en tercer y segundo lugar, respectivamente, en esas evaluaciones del trabajo del conocimiento. En el Índice Vals v2 ocupa el 57.8%, frente a los 67,21 TP3T de Claude Opus 5, los 66,01 TP3T de Claude Fable 5 y los 63,71 TP3T de GPT-5.6 Sol —la mayor diferencia entre ’abierto’ y «cerrado» que he encontrado en ningún índice, y que conviene tener en cuenta a la hora de analizar las cifras de codificación—.
Las demostraciones y cómo interpretarlas
Moonshot publicó dos demostraciones de autonomía a largo plazo que suscitaron gran interés: una Funcionamiento autónomo durante 48 horas completando todo el proceso de diseño de un chip (un diseño de 4 mm con una frecuencia de cierre de 100 MHz, que simula más de 8.700 tokens por segundo) y una reproducción de la astrofísica Relación «I-Love-Q» en unas dos horas, frente a las una o dos semanas que normalmente necesitaría un investigador sénior.
Son realmente impresionantes, pero yo no basaría una decisión de compra en ellas. Las demostraciones organizadas, preparadas y seleccionadas por el proveedor te muestran lo que un modelo es capaz de hacer en un día perfecto y bajo la supervisión de un experto, no lo que hace en tu repositorio un martes cualquiera. Tómalas como una prueba de viabilidad de una capacidad a largo plazo, no como unas especificaciones técnicas.
Mostrar imagen Dos arquitecturas publicadas y una caja negra. Los modelos abiertos explican exactamente cómo funcionan; el modelo cerrado indica qué puntuación obtiene.
Qué es realmente el GLM-5.3
La versión GLM-5.3 tiene la historia más extraña de las tres, y es la que merece la pena contar como es debido, ya que es la primera vez que un laboratorio importante ha dudado abiertamente a la hora de publicar los pesos por motivos que no son de carácter comercial.
Z.ai anunció GLM-5.3 el 14 de agosto de 2026 con el eslogan “Diseñado según las normas. Listo para la ciberdefensa”. El modelo es un Mezcla de expertos con 753.000 millones de parámetros, con unos 40 000 millones de tokens activos según las estimaciones de la comunidad derivadas de la configuración GLM-5.2. Cuenta con una ventana de contexto de 1 millón de tokens y una salida máxima de 128 000, y —a diferencia de GLM-5.3-Flash, que es un modelo completamente distinto— es solo texto.
“Lo único que hicimos fue ampliar la escala tras la formación”
El dato técnico más interesante sobre el GLM-5.3 es que no hay un nuevo modelo base. Reutiliza la misma base preentrenada que el GLM-5.2. Todas las mejoras se deben a un entrenamiento posterior considerablemente más extenso, que Z.ai resumió de la siguiente manera: “Lo único que hicimos con el GLM-5.3 fue ajustar la escala tras el entrenamiento”.”
Las diferencias no son pequeñas:
| Referencia | GLM-5.2 | GLM-5.3 |
|---|---|---|
| Terminal-Bench 3.0 | 4.6 | 28.3 |
| DeepSWE v1.1 | 46.2 | 66.9 |
| CyberGym | 77.2% | 84.5% |
Una mejora de seis veces en Terminal-Bench y un aumento de veinte puntos en DeepSWE, partiendo de los mismos pesos iniciales, es un resultado verdaderamente importante. Esto indica que la vanguardia aún tiene mucho margen de mejora en la fase posterior al entrenamiento, que es, con diferencia, la mitad más económica del coste total del entrenamiento. Esa es precisamente la razón por la que los laboratorios chinos, que operan con, como dice Lambert, “órdenes de magnitud menos de capital” que los estadounidenses, están manteniendo el ritmo.
Las dos semanas que Z.ai pasó sin realizar envíos
Z.ai afirmó en el momento del lanzamiento que los pesos se publicarían “por fases, tras rigurosas evaluaciones de seguridad”, con un plazo previsto de unas dos semanas. En su repositorio de Hugging Face figuraba la fecha del 28 de agosto. Esa fecha llegó, pasó en cuestión de horas y, a continuación, aparecieron los pesos junto con un informe técnico en el que se explicaba el retraso.
El motivo fue la capacidad cibernética. Durante la evaluación, Z.ai informó de que GLM-5.3 identificó 2.436 vulnerabilidades en 269 proyectos de código abierto, de los cuales 1.097 se clasificaron como de gravedad crítica o alta. Más concretamente, el modelo demostró razonamiento sobre cadenas de exploits de varias etapas — encadenando de forma autónoma los pasos de explotación — lo que Z.ai calificó como un comportamiento que “no era del todo intencionado” y que “se fue agravando a medida que se ampliaba el entrenamiento”.”
Quiero ser prudente en este punto, porque esto se puede interpretar fácilmente como una estrategia de marketing o como alarmismo, y probablemente no sea ninguna de las dos cosas. Un modelo que es eficaz a la hora de detectar vulnerabilidades es eficaz a la hora de detectar vulnerabilidades; los usos defensivos y ofensivos son la misma capacidad orientada en direcciones diferentes. La distribución de resultados de las pruebas comparativas de Z.ai refleja esto con sinceridad: CyberGym 84.5% (descubrimiento de vulnerabilidades, adónde conduce) frente a ExploitBench 54.4% (explotación, donde Claude Fable 5 obtiene una puntuación de 78,01 TP3T). El equipo ha optimizado deliberadamente la mitad defensiva y eso se nota.
Lo que realmente llama la atención es que un laboratorio haya retrasado dos semanas el lanzamiento de un producto estrella y haya hecho público su razonamiento. Independientemente de si ese razonamiento te parece convincente o no, se trata de un precedente sin precedentes.
Dónde aterriza realmente el GLM-5.3
La tabla comparativa publicada por Z.ai no pretende dar a entender que haya arrasado, lo cual es de agradecer:
| Referencia | GLM-5.3 | El mejor comparador |
|---|---|---|
| AutomationBench | 48.2% | Cables GLM-5.3 |
| CyberGym | 84.5% | Cables GLM-5.3 |
| GDPval-AA v2 | 1,769 | Cables GLM-5.3 |
| Terminal-Bench 3.0 | 28.3% | GPT-5.6 Sol: 34,61 TP3T |
| DeepSWE v1.1 | 66.9% | GPT-5.6 Sol: 72,71 TP3T |
| ExploitBench | 54.4% | Claude Fable 5: 78,01 TP3T |
| Code Bench (50 000 tokens) | 31.4% | — |
Por su parte, Artificial Analysis lo sitúa en 59,5 en el índice de inteligencia — estadísticamente indistinguible del 59,7 de Kimi K3, obtenido a partir de un modelo con aproximadamente una cuarta parte de los parámetros.
Una salvedad de esa misma evaluación que nadie del departamento de marketing menciona: GLM-5.3 generó 170 millones de tokens generados en el conjunto de herramientas de análisis artificial, frente a una mediana de 72 millones en su categoría. Es demasiado prolijo. esfuerzo_de_razonamiento por defecto es máx. y no se puede desactivar el pensamiento, por lo que estás pagando por un largo proceso de deliberación, independientemente de si la tarea lo merece o no. Aun así, el coste total de llevar a cabo la evaluación completa ascendió a $0,68 por tarea, frente a $0,84 para el Kimi K3 y $2,34 para el Claude Opus 5; por lo tanto, la mayor complejidad no anula la ventaja en el precio, sino que simplemente la reduce.
Qué es realmente «Claude Fable 5.1»
Anthropic lanzó Claude Fable 5.1 el 1 de septiembre de 2026, junto con el Claude Mythos 5.1 —el mismo modelo con una configuración de medidas de seguridad diferente, disponible únicamente a través de programas de acceso de confianza para trabajos en ciberseguridad y ciencias de la vida—.
La definición es concreta y, en mi opinión, acertada: se trata de “Un modelo diseñado para tareas que no se completan con una sola instrucción”.” Anthropic no afirma que se haya producido un avance en la inteligencia general. Lo que afirma es que las sesiones con agentes, de varias horas de duración, dan mejores resultados.
Las cifras
| Referencia | Fábula 5 | Fable 5.1 | Mythos 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | 42.0% | 55.8% | 60.9% |
| Terminal-Bench-Science 0.1 | 24.7% | 52.6% | — |
| AutomationBench | 17.1% | 31.4% | — |
| CursorBench 3.2.0 | 70.5% | 73.4% | — |
| OSWorld 2.0 (parcial) | 72.9% | 77.9% | — |
| El último examen de la humanidad (con herramientas) | 63.8% | 65.0% | — |
| GDPval-AA v2 | — | 1,853 | — |
Para obtener información adicional sobre este mismo gobernante: GPT-5.6 Sol obtiene una puntuación de 52,31 TP3T en Terminal-Bench 4.0, por lo que el 55,81 TP3T de Fable 5.1 se sitúa en cabeza y el 60,91 TP3T de Mythos 5.1 amplía su ventaja.
El salto en la prueba «Terminal-Bench-Science» —de 24,71 TP3T a 52,61 TP3T, lo que supone duplicar la puntuación— es al que yo daría más importancia si tu trabajo tiene que ver con la informática científica o los flujos de datos. Y en la prueba de rendimiento más exigente de Browserbase en cuanto a uso del ordenador, Fable 5.1 completó 82% de tareas frente a las 74% de Claude Opus 5.
Anthropic también informa de que, aproximadamente, un Reducción de los falsos positivos en materia de ciberseguridad según el modelo 60% — el modelo rechaza una tarea de seguridad legítima porque su patrón coincide con algo peligroso. Si alguna vez un asistente de programación se ha negado a ayudarte a escribir un limitador de velocidad, entenderás por qué esto es importante.
La noticia de verdad es el cambio en los precios
Los tipos de interés de referencia no variaron: $10 por cada millón de tokens de entrada, $50 por cada millón de tokens de salida. Lo que ha cambiado es el multiplicador de lectura de la caché, y ha cambiado mucho.
| Fábula 5 | Fable 5.1 | |
|---|---|---|
| Entrada | $10.00 | $10.00 |
| Resultado | $50.00 | $50.00 |
| Escritura en caché (5 min) | $12.50 | $12.50 |
| Escritura en caché (1 hora) | $20.00 | $20.00 |
| Lectura de caché | $1.00 | $0.25 |
Se trata de una reducción de 75%, conseguida al cambiar el multiplicador de lectura de la caché del valor estándar de 0,1× de la entrada base a 0,025×. Anthropic cita, aproximadamente, 25% más económico para cargas de trabajo típicas y hasta 45% más económico para tareas que requieren un alto nivel de agilidad — y esa segunda cifra es real, porque los bucles de los agentes consisten, en su gran mayoría, en lecturas de caché. Una sesión de agente de 60 iteraciones vuelve a leer el mismo contexto acumulado docenas de veces. La API por lotes reduce a la mitad las entradas y salidas, además, lo que da como resultado $5/$25.
Se trata de una rebaja de precio inteligente y bien orientada. Hace que aquello en lo que el Fable 5.1 destaca especialmente —las sesiones prolongadas— resulte significativamente más barato sin que ello suponga una devaluación general del modelo.
Tres cambios que afectan a la compatibilidad, una regresión
Antes de actualizar una integración en producción, léete esto con atención.
1. Ya no es obligatorio utilizar herramientas. Solicitudes que utilizan tool_choice: "cualquiera" o tool_choice: "herramienta" ahora devuelve un Error 400. El proceso de reflexión está siempre activo y no se puede eludir; si se forzara la llamada a una herramienta, se saltaría este paso. Debes utilizar tool_choice: "auto".
2. Los bloqueos mentales son unidireccionales. Fable 5.1 puede leer los ’thinking blocks» generados por modelos anteriores de Claude, pero los modelos anteriores no pueden leer los de Fable 5.1. Solo Mythos 5.1 puede hacerlo. Si tu arquitectura cambia de modelo en mitad de una conversación para ahorrar dinero, esa solución alternativa obliga ahora a replantear la estrategia.
3. El historial de ediciones invalida los bloqueos mentales. En el caso de las cuentas creadas después del 31 de agosto de 2026, al editar turnos anteriores, el mensaje del sistema o la gama de herramientas invalida todos los bloques de razonamiento posteriores —ya sean errores o omisiones silenciosas—. Se trata de una medida explícita contra la destilación que rompe con un patrón habitual en el que los marcos de agentes reescriben el contexto entre turnos.
Y una regresión que conviene conocer: Según se informa, la llamada paralela a herramientas es más variable en la versión 5.1, ya que a veces se realiza una sola llamada por turno, mientras que en la versión 5 se agrupaban varias. En un bucle de agente prolongado, esto supone una pérdida de tiempo real.
Hay además un detalle sobre el tokenizador que suele pasar desapercibido a la hora de comparar precios: Fable 5.1 utiliza el mismo tokenizador que Claude Opus 4.7, que genera aproximadamente 30% más fichas que el tokenizador de los modelos Claude más antiguos para el mismo texto. Si estás comparando el coste con una referencia de 2025, tenlo en cuenta antes de sacar conclusiones.
El problema de la referencia: tres modelos, tres reglas diferentes
Este es el punto en el que la mayoría de los artículos comparativos se equivocan, y vale la pena ser franco al respecto.
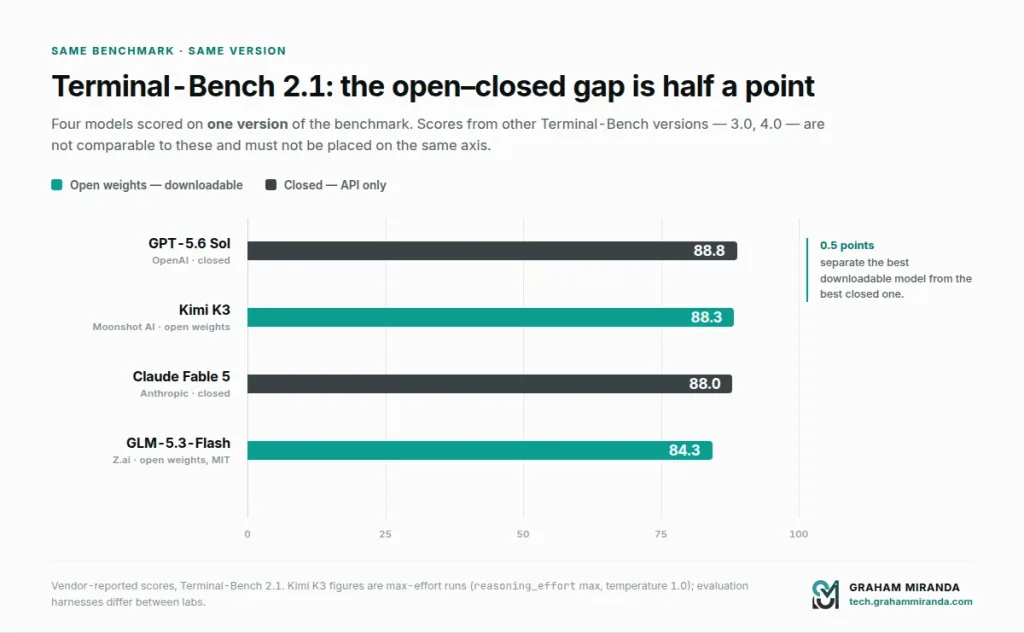
No es posible alinear estos tres modelos en Terminal-Bench. Mira:
- Kimi K3: 88.3 en Terminal-Bench 2.1
- GLM-5.3: 28.3 en Terminal-Bench 3.0
- Fable 5.1: 55.8 en Terminal-Bench 4.0
Se trata de tres pruebas de rendimiento diferentes que comparten nombre. Cada versión se ha vuelto considerablemente más difícil que la anterior; ese es precisamente el objetivo de lanzar una nueva versión. Si interpretaras esos tres números como una clasificación, pensarías que Kimi K3 es tres veces mejor que GLM-5.3 en tareas de terminal, lo cual es una tontería.
El mismo problema se da en AutomationBench, donde los números de versión se indican de forma inconsistente, y en la familia SWE-bench, donde las variantes Verified, Pro y Marathon miden aspectos realmente diferentes. Los laboratorios no hacen esto con la intención de engañar a nadie: realizan la evaluación que estaba vigente cuando recibieron su formación, y las evaluaciones cambian cada pocos meses en la actualidad. Pero el efecto que esto tiene en un lector ocasional es el mismo que el de un engaño, por lo que merece la pena señalarlo con claridad.
Lo que sí se puede comparar legítimamente, dentro de una misma versión:
En Terminal-Bench 2.1: Kimi K3 (88,3), GPT-5.6 Sol (88,8), Claude Fable 5 (88,0) y GLM-5.3-Flash (84,3). Cuatro modelos, un único criterio de evaluación. Esta es la comparación que realmente importa y le he dedicado una tabla propia en la siguiente sección.
En Terminal-Bench 4.0: Fable 5.1 (55,8) frente a GPT-5.6 Sol (52,3). Gana Fable.
Además, desconfía de cualquiera que te muestre un único gráfico de barras con los tres modelos principales de este artículo en un eje «Terminal-Bench». No se puede hacer de forma honesta.
Dónde coinciden realmente: las cifras comparables entre sí
Si eliminamos las discrepancias entre las versiones de las pruebas de rendimiento, quedan tres comparaciones.
1. Índice de Inteligencia Artificial en el Análisis (septiembre de 2026)
Se lleva a cabo de forma independiente, se aplica la misma metodología en todos los modelos y no interviene ningún proveedor en la selección.
| Clasificación | Modelo | Puntuación | Peso libre |
|---|---|---|---|
| 1 | Claude, Op. 5 | 63.0 | No |
| 2 | Claude Fable 5 | 62.1 | No |
| 3 | Grok 4.6 | 60.9 | No |
| 4 | Kimi K3 | 59.7 | Sí |
| 5 | GLM-5.3 | 59.5 | Sí |
| 6 | GPT-5.6 Sol | 58.9 | No |
| 7 | Qwen 3.8: vista previa de Max | 58.1 | Peso por determinar |
| 8 | GLM-5.3-Flash | 57.5 | Sí (MIT) |
| 31 | MiniMax M3 | 45.4 | Sí |
En el momento de redactar este artículo, Fable 5.1 aún no había sido evaluado de forma independiente, ya que se había lanzado el día anterior. Teniendo en cuenta las diferencias en las pruebas de rendimiento de Fable 5.1 con respecto a Fable 5, cabe esperar que alcance una puntuación igual o superior a 62,1 cuando se evalúe.
Una nota sobre la precisión: las distintas instantáneas de este índice presentan variaciones —en una de septiembre, el Kimi K3 y el GLM-5.3 aparecen ambos en 60, mientras que el GPT-5.6 Sol está en 61—. El orden en los primeros puestos es estable; las diferencias en las subpuntuaciones, no. No bases un argumento en medio punto.
Lee esa tabla con atención. El mejor modelo de peso abierto se sitúa 3,3 puntos por detrás del mejor modelo cerrado en el índice neutral más amplio disponible. Hace un año, esa diferencia era de dos dígitos.
2. Terminal-Bench 2.1: la única versión en la que los tres coinciden
Esta es la tabla más útil de todo el artículo, y por poco se me pasa por alto. Kimi K3, Claude Fable 5 y GPT-5.6 Sol fueron evaluados en la misma versión de Terminal-Bench:
| Modelo | Terminal-Bench 2.1 | Peso libre |
|---|---|---|
| GPT-5.6 Sol | 88.8 | No |
| Kimi K3 | 88.3 | Sí |
| Claude Fable 5 | 88.0 | No |
| GLM-5.3-Flash | 84.3 | Sí (MIT) |
Medio punto separa un modelo que se puede descargar del mejor modelo cerrado en la misma prueba de rendimiento, con la misma versión, en el trabajo agénico nativo del terminal.
Esa es la cifra que hay que recordar. Ni el índice agregado, ni el gráfico del proveedor… esta. En cuanto a la forma específica que adopta la codificación agencial, la diferencia se pierde entre el ruido.
Una salvedad, señalada por la fuente y que merece la pena repetir: Todas las cifras publicadas de Kimi K3 corresponden a vueltas a máxima potencia, a esfuerzo_de_razonamiento máximo y temperatura 1,0. Los distintos laboratorios utilizan diferentes sistemas de evaluación y diferentes ajustes de esfuerzo, por lo que incluso las comparaciones entre versiones idénticas conllevan una mayor incertidumbre de lo que sugiere una tabla sin matices.
3. Coste de ejecutar el mismo conjunto de pruebas de evaluación
Si la tabla anterior es la mejor comparación en cuanto a prestaciones, esta es la mejor comparación en cuanto a relación calidad-precio, ya que es la única cifra que agrupa las prestaciones, la verbosidad, la sobrecarga de razonamiento y el precio en un único valor:
| Modelo | Coste por tarea del Índice de Inteligencia |
|---|---|
| GLM-5.3 | $0.68 |
| Kimi K3 | $0.84 |
| Claude, Op. 5 | $2.34 |
Las mismas tareas, la misma puntuación, facturas reales. GLM-5.3 ofrece una puntuación de 94% en el índice de Opus 5 por un coste de 29%.
4. GDPval-AA v2 (trabajo intelectual)
| Modelo | Puntuación |
|---|---|
| Claude Fable 5.1 | 1,853 |
| Claude Fable 5 Max | 1,815 |
| GLM-5.3 | 1,769 |
| GPT-5.6 Sol Max | 1,747.8 |
| Kimi K3 | 1,687 |
Hay que hacer una salvedad al respecto: se ha elaborado a partir de gráficos publicados por los propios proveedores, en lugar de un único análisis independiente, y los sufijos “Max” indican diferentes configuraciones de esfuerzo. No obstante, el orden es, en líneas generales, coherente en todas las fuentes, y revela algo significativo: en lo que respecta al trabajo intelectual en general, a diferencia de la programación, los modelos cerrados siguen manteniendo una ventaja más clara de lo que sugieren las comparativas de programación.
Ese es el patrón que se observa en las tres comparaciones. Los modelos abiertos prácticamente han alcanzado el nivel de los modelos cerrados en lo que respecta a la programación y las tareas de tipo «agente». Sin embargo, siguen un paso por detrás en lo que se refiere al trabajo de conocimiento en general. Si tu volumen de trabajo se ajusta a la primera situación, los argumentos a favor de pagar los precios de los modelos cerrados son débiles. Si se ajusta a la segunda, sigue siendo defendible.
Mostrar imagen Tres puntos y pico separan al mejor modelo cerrado del mejor modelo descargable. Hace doce meses, esa diferencia era de dos dígitos.
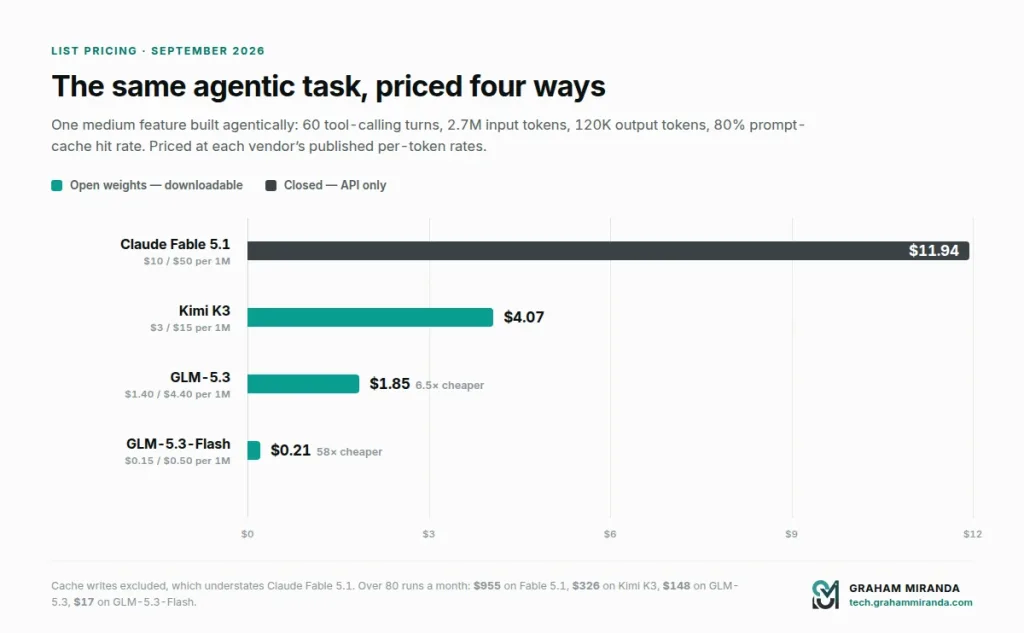
El cálculo de los costes, con cifras reales
Los índices de referencia son abstractos. Las facturas no lo son.
El escenario
Una característica de nivel medio, realizada de forma activa: aproximadamente 60 turnos de selección de herramientas, con una media de 45 000 fichas de entrada por turno a medida que se va acumulando contexto, y 2.000 fichas de salida por turno.
- Total de entradas: 2,7 millones de tokens
- Producción total: 120 000 tokens
- Tasa de aciertos estimada en la caché de comandos: 80% (2,16 millones en caché, 540 000 recientes)
Claude Fable 5.1
| Componente | Fichas | Tarifa | Coste |
|---|---|---|---|
| Novedades | 540 000 | $10,00/M | $5.40 |
| Entrada almacenada en caché | 2,16 millones | $0,25/M | $0.54 |
| Resultado | 120 000 | $50,00/M | $6.00 |
| Total | ≈ $11,94 |
Kimi K3
| Componente | Fichas | Tarifa | Coste |
|---|---|---|---|
| Novedades | 540 000 | $3,00/M | $1.62 |
| Entrada almacenada en caché | 2,16 millones | $0,30/M | $0.65 |
| Resultado | 120 000 | $15,00/M | $1.80 |
| Total | ≈ $4,07 |
GLM-5.3
| Componente | Fichas | Tarifa | Coste |
|---|---|---|---|
| Novedades | 540 000 | $1,40/M | $0.76 |
| Entrada almacenada en caché | 2,16 millones | $0,26/M | $0.56 |
| Resultado | 120 000 | $4,40/M | $0.53 |
| Total | ≈ $1,85 |
Y, a modo de referencia: GLM-5.3-Flash
| Componente | Fichas | Tarifa | Coste |
|---|---|---|---|
| Novedades | 540 000 | $0,15/M | $0.08 |
| Entrada almacenada en caché | 2,16 millones | $0.03/M | $0.06 |
| Resultado | 120 000 | $0,50/M | $0.06 |
| Total | ≈ $0,21 |
Los coeficientes
- El GLM-5.3 es 6,5 veces más barato que el Fable 5.1 por un trabajo idéntico
- Kimi K3 es 2,9 veces más barato que Fable 5.1
- El GLM-5.3 es 2,2 veces más barato que el Kimi K3
- GLM-5.3-Flash es 58 veces más barato que Fable 5.1, con una puntuación de 57,5 en el índice de inteligencia frente a los 62,1 de Fable 5
Conversión a un mes laborable
Cuatro tareas de este tipo al día, veinte días laborables: 80 ejecuciones de agente:
| Modelo | Coste mensual de los tokens |
|---|---|
| Claude Fable 5.1 | ≈ $955 |
| Kimi K3 | ≈ $326 |
| GLM-5.3 | ≈ $148 |
| GLM-5.3-Flash | ≈ $17 |
Tres advertencias sinceras sobre estas cifras
Se excluyen las escrituras en la caché. Fable 5.1 consume $12,50/M en escrituras en caché de 5 minutos, y una sesión prolongada realiza escrituras en caché de forma repetida. La inclusión de las escrituras hace que la cifra real de Fable aumente, en lugar de disminuir. La tasa de aciertos de 80% también es optimista para sesiones cortas.
Los tokens de razonamiento se facturan como tokens de salida. Los tres modelos funcionan en modo «siempre activo». El GLM-5.3, en particular, se describe como muy prolijo —170 millones de tokens de salida frente a una mediana de 72 millones en la suite AA—, por lo que su volumen de salida real supera lo que sugeriría un recuento simplista de turnos. La cifra de $0,68 por tarea ya tiene esto en cuenta, por lo que confío más en ella que en mi propio modelo anterior.
El tokenizador de Fable 5.1 genera unos 30% más tokens que los modelos anteriores de Claude para el mismo texto. Si estás comparando con una factura histórica de Claude, haz los ajustes necesarios.
Incluso tras las tres correcciones, el orden no cambia y la magnitud apenas varía. El trabajo con frontera cerrada cuesta aproximadamente seis veces más que el mejor modelo de peso abierto, por tarea completada.
Mostrar imagen La misma tarea agencial de 60 turnos al precio de catálogo de cada proveedor. El eje vertical representa el argumento completo para los pesos abiertos.
Licencias: ¿Qué te ofrece realmente el concepto “abierto” en 2026?
Esta es la sección que más me gustaría que la gente leyera, porque el vocabulario se ha desviado mucho y eso le va a costar mucho dinero a alguien.
Ni Kimi K3 ni GLM-5.3 son de código abierto. Ambas publican pesos descargables bajo licencias a medida con condiciones que se activan en función de los ingresos. Esto difiere significativamente de las licencias MIT o Apache 2.0, y la diferencia radica precisamente en el tipo de negocio que más se beneficiaría del autoalojamiento.
La licencia Kimi K3
Verás que por todo Internet se repite “MIT modificado” en referencia a K3. Es incorrecto: eso se refería a K2. K3 se distribuye bajo un documento personalizado con dos fases distintas:
La puerta «Model-as-a-Service». Si concedes a terceros acceso a la inferencia o al ajuste fino de modelos —en los casos en que dichos terceros controlen las entradas, los parámetros o los datos de entrenamiento— y “los ingresos totales del titular de la licencia y sus filiales superan los 20 millones de dólares estadounidenses” durante cualquier periodo de 12 meses consecutivos, deberás negociar un acuerdo comercial independiente con Moonshot. Nota agregado ingresos de todas las filiales, no los ingresos atribuibles a K3. Una consultora con una facturación de 25 millones de euros que revende servicios de inferencia ya supera el límite, aunque su negocio de IA sea insignificante.
El escándalo de la atribución. Productos que superen 100 millones de usuarios activos mensuales o $20 millones de ingresos mensuales Debe aparecer “Kimi K3” de forma destacada en la interfaz del producto.
La exención más importante: El uso exclusivamente interno no está sujeto a restricciones. Utilizar K3 para apoyar a tus propios desarrolladores, investigadores, equipo jurídico o para mejorar la productividad general de los empleados no activa ninguna de las dos restricciones. Para la inmensa mayoría de las empresas —incluidas prácticamente todas las mías—, esa es la cláusula relevante, y la respuesta es que no hay ningún problema.
La cláusula nueva con respecto a K2 es el umbral de MaaS de $20M. K2 solo exigía la atribución por encima de sus umbrales. K3 añade un umbral de ingresos mucho más bajo dirigido específicamente a los revendedores de inferencia comercial. Moonshot no pretende impedir que utilices el modelo; lo que pretende es evitar que los proveedores de servicios en la nube desarrollen un negocio basándose en él de forma gratuita.
La licencia de glm-5.3
El producto estrella de Z.ai tomó un rumbo diferente, y supone una ruptura con los antecedentes mucho mayor de lo que la mayoría de los medios han reconocido.
GLM-5.2 se distribuye bajo la licencia MIT. GLM-5.3-Flash se distribuye bajo la licencia MIT. GLM-5.3 no.
La licencia personalizada permite a particulares y empresas comunes ejecutar, implementar y ajustar el modelo sin restricciones adicionales. La opción «Single Gate» está dirigida a los hiperescaladores: una entidad cuya “los ingresos totales del titular de la licencia y sus filiales superen los 10 000 millones de dólares estadounidenses (o su equivalente en otras divisas) en el conjunto de cualquier periodo de 12 meses consecutivos” debe superar la revisión de seguridad de Z.AI antes de utilizar el modelo o sus derivados con cualquier fin comercial.
Se trata de un umbral de $10 mil millones. Esto excluye a casi todo el mundo. Sin embargo, hay dos detalles en la letra pequeña que merecen atención:
En primer lugar, la licencia excluye expresamente a los desarrolladores de aplicaciones que incorporan el modelo en sus funciones, así como a los distribuidores que se limitan a redirigir las solicitudes a otros servidores. El público objetivo es reducido y está claramente definido: las empresas que desean anfitrión GLM-5.3 a gran escala a nivel comercial.
En segundo lugar —y esta es la parte realmente incómoda— La licencia no establece ningún criterio, plazo ni procedimiento de recurso para dicha revisión de seguridad. Solo afirma que su “El alcance y el método… serán determinados de forma razonable por Z.AI”.” Si eres una gran empresa, eso supone una dependencia ilimitada de la discreción de un proveedor extranjero, y tu equipo de compras así te lo dirá.
También cabe destacar que, a pesar de la suspensión de dos semanas de las capacidades cibernéticas que precedió al lanzamiento, La licencia no incluye restricciones de uso aceptable, ni exclusiones cibernéticas, ni reclamaciones sobre la titularidad de los resultados. La preocupación por la seguridad influyó en el lanzamiento sincronización, no el lanzamiento términos.
Entonces, ¿qué es lo que sigue siendo realmente el MIT?
GLM-5.3-Flash. 320 mil millones de parámetros, 18 mil millones activos, multimodal de forma nativa, con licencia del MIT, 57,5 en el índice de inteligencia y $0,15/$0,50 por millón de tokens —actualmente a la mitad de ese precio gracias a un descuento promocional vigente hasta el 9 de septiembre de 2026—. Si lo que necesitas es una licencia verdaderamente permisiva y sin restricciones, en lugar de meros pesos descargables, ahí es donde se sitúa actualmente la frontera, y es notablemente alta.
Resumen práctico
| Kimi K3 | GLM-5.3 | GLM-5.3-Flash | Fable 5.1 | |
|---|---|---|---|---|
| Pesas descargables | Sí | Sí | Sí | No |
| Código abierto al estilo OSI | No | No | Sí (MIT) | No |
| Desencadenador de restricción | Ingresos $20M (MaaS) | Ingresos de $10B (MaaS) | Ninguno | N/A |
| Se requiere la indicación de la fuente | Más de 100 millones de usuarios activos mensuales / $20M-mes | Aviso de derechos de autor únicamente | Aviso de derechos de autor únicamente | N/A |
| Uso exclusivo para uso interno | No | No | No | N/A |
| Se permite el ajuste fino | Sí | Sí | Sí | No |
| Política de uso aceptable | Estándar | No aparece en el texto de la licencia | Ninguno | Se aplica la Política de uso aceptable (AUP) de Anthropic |
Para una empresa típica alemana de tamaño medio, una agencia o una consultora que ejecute modelos internamente o los integre en un producto: Las tres opciones disponibles se pueden utilizar sin necesidad de negociar nada. Las restricciones están ahí para proteger a AWS, no a ti. Pero la frase “lee la licencia” ha pasado de ser un consejo pedante a convertirse en un consejo de verdad, y si tu facturación supera los 20 millones de euros y revendes servicios de inferencia en cualquier formato, consúltalo con un abogado antes de ponerlo en marcha.
Los argumentos de peso a favor de los modelos abiertos
Quiero desarrollar este argumento como es debido, en lugar de limitarme a un eslogan, porque “los modelos abiertos son geniales” no es un argumento, y las razones reales son más interesantes que las simples alabanzas.
1. La caída de los precios no es una subvención, sino un fenómeno estructural
La objeción instintiva a los modelos chinos baratos es que los precios son una estrategia de captación de clientes y que acabarán subiendo hasta alcanzar un nivel normal. En parte, sin duda es así. Pero la cuestión estructural se mantiene al margen de ello: Cuando los pesos son públicos, la inferencia se convierte en un mercado de productos básicos. Veinte proveedores de alojamiento compiten por ofrecer el mismo modelo, y ninguno de ellos puede cobrar una prima por sus capacidades, ya que ninguno cuenta con una ventaja competitiva en este ámbito. Por eso, GLM-5.3 funciona a $1,40/$4,40 y Fable 5.1 a $10/$50, con una diferencia de tres puntos en la puntuación.
La fijación de precios en el modelo cerrado incluye la amortización de I+D, el margen y el hecho de que solo hay un vendedor. La fijación de precios en el modelo abierto incluye la electricidad, la amortización del hardware y un margen reducido. Se trata de negocios diferentes, y la diferencia no se reducirá por el hecho de que los modelos abiertos se encarezcan.
Las pruebas de que se trata de algo real y no pasajero: DeepSeek capturó aproximadamente 17% de uso de tokens en Vercel para mayo de 2026, con una participación en los ingresos de aproximadamente 1%. Eso no es una anomalía en los precios. Así es como se ve la mercantilización en un gráfico.
2. Los derechos de rescisión modifican tu posición negociadora, aunque nunca los ejerzas.
La mayoría de los equipos que lean esto no optarán por el alojamiento propio. En la sección sobre hardware que aparece a continuación se explica el motivo: Kimi K3 necesita un rack. No obstante, la opción sigue siendo interesante.
Si Anthropic sube los precios, deja de dar soporte al modelo en el que has basado tu producto, modifica su política de uso aceptable de tal forma que tu producto deje de funcionar, o tiene un mal trimestre, tu única opción con un modelo cerrado es llevar a cabo un proyecto de migración. Con un modelo de peso abierto, tu única opción es descargar un archivo que podrías haber descargado en cualquier momento. Puede que nunca lo hagas. El hecho de que tú podría es lo que hace que la relación con el proveedor sea de carácter comercial y no de dependencia.
Esto no es una cuestión teórica. Fable 5.1 se lanzó el 1 de septiembre con tres cambios que afectan a la compatibilidad, uno de los cuales invalida los bloques de pensamiento al editar el historial de conversaciones de las cuentas creadas después del 31 de agosto. Si ese patrón es fundamental en tu arquitectura, te verás obligado a rediseñar el sistema según el calendario de Anthropic, no el tuyo.
3. La residencia de datos deja de ser un proyecto
Para cualquiera que opere bajo el RGPD, este es el argumento que realmente cierra los acuerdos.
Con una API cerrada, cada solicitud sale de tu infraestructura. Necesitas un acuerdo con el encargado del tratamiento, una evaluación del impacto de la transferencia si el encargado del tratamiento se encuentra fuera del EEE, un mapa de flujo de datos y una respuesta para tu delegado de protección de datos sobre qué ocurre con los datos en reposo. Todo eso es factible. Pero también supone semanas de trabajo por cada proveedor, y hay que repetirlo cada vez que el proveedor realiza algún cambio.
Con los recursos de infraestructura de peso abierto que tú controlas —tu propio hardware o un servidor de GPU alemán o de la UE—, la cuestión de la transferencia transfronteriza ni siquiera se plantea, ya que no hay transferencia alguna. El modelo se ejecuta allí donde ya se encuentran tus datos. La revisión jurídica pasa de ser una evaluación de la transferencia a una simple lectura de la licencia.
Para los clientes alemanes y de la UE, este suele ser el factor decisivo, por lo que conviene ser preciso en cuanto a la salvedad: El uso de GLM-5.3 a través de la API de Z.ai no te ofrece esto. Se obtiene al gestionar tú mismo los servicios, o a través de un proveedor que los preste en tu jurisdicción. La licencia lo hace legal; no significa que sea automático.
4. La inspeccionabilidad es una realidad, aunque se le saque poco partido
Los pesos abiertos te permiten examinar la arquitectura, realizar tus propias evaluaciones sobre el modelo real —en lugar de sobre un punto final que podría actualizarse de forma silenciosa—, cuantificarlo para adaptarlo a tu hardware, ajustarlo a tu dominio y —lo que es más importante— fijar una versión de forma permanente.
Esto último se suele subestimar. Las API cerradas se actualizan tras los identificadores de modelo estables. El comportamiento se desvía. Las indicaciones que antes funcionaban dejan de hacerlo, y no se puede comparar el cambio porque no se ve. Un punto de control local seguirá siendo idéntico al nivel de byte dentro de un año.
5. La presión competitiva beneficia a todos, incluidos los usuarios de modelos cerrados
Fíjate en lo que ha pasado este verano. Kimi K3 se sitúa en julio en $3/$15, con puntuaciones cercanas a los límites máximos. GLM-5.3 se sitúa en agosto en $1,40/$4,40, a menos de medio punto de distancia. Y el 1 de septiembre, Anthropic redujo las lecturas de caché en 75%.
No estoy afirmando que exista una relación causal directa: Anthropic no hace pública la lógica que sigue para fijar sus precios y la reducción de las lecturas de caché es una optimización natural. Pero un mercado con sustitutos baratos y fiables fija sus precios de forma diferente a uno que carece de ellos, y esos sustitutos han ganado en credibilidad este año. Si utilizas exclusivamente modelos cerrados, el ecosistema de peso abierto sigue reduciendo discretamente tus facturas.
6. Es después del entrenamiento donde se obtienen los resultados, y además es barato
El resultado más destacado del GLM-5.3 —una mejora de seis veces en el índice Terminal-Bench partiendo de los mismos pesos base— es la cifra de mayor importancia estratégica de todo este artículo, y no tiene nada que ver con el GLM.
Afirma que la parte costosa de la creación de un modelo de vanguardia (el preentrenamiento) es, cada vez más, un factor ya resuelto y estandarizado, mientras que la parte diferenciadora (el postentrenamiento, los entornos de aprendizaje por refuerzo y el diseño de tareas a largo plazo) resulta comparativamente asequible. Por eso cuatro laboratorios chinos, con una valoración conjunta de unos $159 mil millones, están a la altura de los laboratorios estadounidenses, cuya valoración es varias veces superior. Según la valoración de Lambert, los laboratorios chinos están funcionando con “órdenes de magnitud menos de capital”.”
Para cualquiera que se encuentre más abajo, la consecuencia es clara: El número de proveedores de modelos fiables está aumentando, no disminuyendo. Planifica tu arquitectura en consecuencia.
7. Los efectos sobre el ecosistema se acumulan
Qwen falleció mil millones de descargas acumuladas en Hugging Face, superando a Llama, y ahora cuenta con más de 200 000 modelos etiquetados y más de 113 000 derivados —aproximadamente 40% de todos los nuevos derivados de LLM en la plataforma se basan en Qwen. Se trata de un ecosistema de herramientas, cuantificación, ajuste y despliegue que solo existe porque los pesos son públicos.
Te beneficias de ese ecosistema, independientemente de si contribuyes a él o no. Conversiones GGUF, núcleos vLLM, adaptadores LoRA, recetas de cuantificación, marcos de evaluación… Todo ello existe porque miles de personas han podido acceder a los pesos reales.
8. Es donde ya han ido los promotores
Modelos de origen chino en ~61% de tokens de OpenRouter. La cuota de mercado de los modelos estadounidenses ha descendido de ~70% a ~30% en un año. Cuatro de los cinco modelos más utilizados en el enrutador son de origen chino. Solo los modelos MiMo de Xiaomi representan aproximadamente el 21% de los tokens enrutados y alrededor del 22% de todo el tráfico de codificación.
El comportamiento de los desarrolladores es un indicador adelantado. Lo fue para Docker, para Postgres y para Linux. Apostar en contra de ello no ha dado buenos resultados a lo largo de la historia.
…Y los argumentos sinceros en contra de
Si solo hubiera escrito la sección anterior, esto sería un anuncio.
Los modelos de peso abierto no son de código abierto, y la deriva del vocabulario es un problema real. Dos de los tres modelos aquí presentados se comercializan bajo licencias personalizadas condicionadas a los ingresos, sin la aprobación de la OSI. La cláusula de revisión de seguridad de GLM-5.3 carece de criterios publicados o de un proceso de apelación. Si tu marco de cumplimiento exige licencias aprobadas por la OSI, la respuesta sincera es que tus opciones son GLM-5.3-Flash, los productos estrella de DeepSeek con licencia del MIT y una lista cada vez más reducida de otros.
Las comparativas de proveedores siguen siendo comparativas de proveedores. Todas las cifras destacadas que han publicado Moonshot y Z.ai son datos facilitados y seleccionados por ellos mismos. En los casos en que han intervenido agregadores neutrales, las cifras se mantienen en líneas generales —lo cual es realmente mérito de ambos laboratorios—, pero la expresión ’se mantienen en líneas generales“ tiene un papel importante en esa frase.
El autoalojamiento es un sueño inalcanzable para la mayoría de los equipos. Kimi K3 tiene una capacidad de 1,5 TB y Moonshot recomienda 64 aceleradores o más. GLM-5.3 necesita como mínimo 8 × H200 a FP8. La salida a la derecha es real; el coste de la operación es un centro de datos.
El apoyo es lo que tú hagas de él. Cuando Fable 5.1 falla, hay una empresa que ofrece un acuerdo de nivel de servicio (SLA). Cuando tu implementación autohospedada de GLM-5.3 genera datos inservibles al alcanzar los 300 000 contextos un viernes por la noche, lo único que tienes es una incidencia en GitHub y tu propia competencia.
La geopolítica es un factor clave en la contratación pública. Las tres opciones de peso abierto que se analizan aquí proceden de laboratorios chinos. Para algunos clientes —el sector público, el sector relacionado con la defensa y determinados sectores regulados—, eso supone un obstáculo insalvable, independientemente de las condiciones de la licencia o de los límites de peso. No me corresponde a mí decirte si esa preocupación está bien fundada. Lo que sí me corresponde es decirte que ese tema saldrá a colación en la reunión.
Los modelos cerrados siguen liderando el ámbito del trabajo de conocimiento general. GDPval-AA v2 obtiene una puntuación de 1.853 en Fable 5.1, frente a los 1.769 de GLM-5.3 y los 1.687 de Kimi K3. En lo que respecta a la programación, la diferencia ha desaparecido; sin embargo, en el ámbito del trabajo intelectual general, no es así.
Mostrar imagen Peso descargable, tres juegos diferentes de cuerdas. Solo GLM-5.3-Flash sigue siendo del MIT.
Ollama en 2026: el cambio en los precios que realmente importa
Ollama se ha convertido, sin hacer mucho ruido, en el elemento de infraestructura más importante de este debate, y en 31 de agosto de 2026 Ha cambiado su sistema de cobros de una forma que merece la pena comprender bien.
¿Qué ha cambiado?
Ollama ha cambiado la facturación de sus planes Pro, Max y Team, que antes se basaba en el tiempo de uso de la GPU, a una tarificación por token conforme a los estándares del sector, con un paquete de créditos de uso incluido en cada plan. La razón que aduce la empresa es, afortunadamente, muy concreta: modelos como el Kimi K3 hacían que fuera imposible predecir los parámetros de tiempo de GPU. Cuando un modelo activa 104 mil millones de parámetros y otro, 3 mil millones, “una hora de GPU” deja de tener sentido para quien paga.
Los nuevos planes
| Plan | Precio | Consumo mensual incluido | Concurrencia |
|---|---|---|---|
| Gratis | $0 | Crédito mensual reducido, modelos básicos | 1 solicitud |
| A favor | $20 al mes (o $200 al año) | $60 de uso | 3 solicitudes |
| Max | $100/mes | $300 de uso | 10 solicitudes |
| Equipo | $500/mes | $1.000 compartido, usuarios ilimitados | 10 solicitudes |
| Empresa | Personalizado | Personalizado | Personalizado |
Vuelve a leer la fila «Pro». $20 compra $60 de tokens. Esto supone un multiplicador de 3× sobre el consumo incluido y, cuando se agote el contingente, seguirás pagando exactamente la misma tarifa por token publicada, sin tramos de penalización ni comisiones de servicio.
Qué se ha eliminado
Esta es la parte que realmente llamó la atención de los desarrolladores: Sin reinicios cada 5 horas ni límites semanales. Cualquiera que se haya encontrado con una ventana de uso variable en plena refactorización entenderá por qué eso era más importante que el precio. El cupo mensual se actualiza en la fecha de renovación de la suscripción y, lo que es más importante, no se da la vuelta — Así que adapta tu plan a un mes normal, no al más ajetreado.
Los términos importantes para el trabajo en la UE
Hay tres compromisos del comunicado que son de especial relevancia si gestionas datos de clientes:
- Sin retención de datos. Las preguntas y las respuestas nunca se registran ni se utilizan para el entrenamiento.
- Alojamiento web en EE. UU. y Europa, además de Singapur para una gama limitada de modelos Qwen.
- Visibilidad del coste por solicitud en tu cuenta: podrás ver exactamente cuánto ha costado cada llamada.
Para una consultora alemana, esto supone una situación de cumplimiento normativo considerablemente mejor que la que ofrecen la mayoría de los proveedores de pasarelas de pago, aunque la expresión “alojado en Europa” es más bien una indicación de enrutamiento que una garantía contractual de residencia de los datos. Si la residencia de los datos es un requisito imprescindible y no una mera preferencia, solicítaselo a Ollama por escrito antes de darlo por sentado.
Las tarifas reales por token
Aquí es donde la cosa se pone interesante. Ollama publica las tarifas por modelo y realiza un seguimiento minucioso de los precios de los propios fabricantes:
| Modelo en Ollama | Entrada / 1M | En caché / 1M | Salida / 1M |
|---|---|---|---|
kimi-k3 | $3.00 | $0.30 | $15.00 |
glm-5.3 | $1.40 | $0.26 | $4.40 |
mistral-large-3 | $0.50 | $0.50 | $1.50 |
gemma4 | $0.14 | $0.05 | $0.40 |
nemotron-3-super | $0.015 | $0.015 | $0.60 |
Aplica a esto los cálculos mensuales que hemos hecho antes. Ochenta ejecuciones de «agent» al mes en GLM-5.3 cuestan aproximadamente $148 en tokens. A El plan Max, con $100 al mes, cubre un consumo de $300. — así que la misma carga de trabajo que costaría aproximadamente $955 al mes en Fable 5.1 cabe perfectamente en una suscripción a Ollama de $100, con margen de sobra.
Ese es todo el argumento económico del modelo abierto resumido en una sola línea de una factura.
Mostrar imagen Ochenta ejecuciones de agente al mes en GLM-5.3 caben en un plan Ollama Max $100 y aún sobra algo. El mismo trabajo en Fable 5.1 supone una factura de $955.
¿Qué más lanzó Ollama en 2026?
El cambio en los precios no se produjo de forma aislada. Los últimos meses han sido muy ajetreados:
- 25 de agosto — Asistencia técnica para Claude Desktop. Ollama trabaja ahora como proveedor externo de pasarelas para Claude Desktop, por lo que puedes utilizar modelos abiertos a través del propio cliente de Anthropic.
- 26 de agosto — v0.33.0. Se ha implementado la integración de la pasarela de Claude Desktop, se ha restablecido la recuperación de datos prellenados en la caché y Ollama ha desactivado el mensaje del sistema de cuenta atrás de tokens de Claude Code, que invalidaba la caché KV en cada turno. Esta última es una corrección de rendimiento discreta pero significativa.
- 26 de agosto — v0.33.1. Compatibilidad de MLX con Qwen 3.8 Flash Next, salida estructurada y una corrección para los tiempos de espera de la GPU al cargar modelos desde un almacenamiento más lento.
- 28 de agosto — v0.33.2. Se ha restablecido el modo oscuro, se ha solucionado el problema de Handoff en macOS y se mantienen activas las solicitudes de proxy de Claude Desktop durante las actualizaciones del catálogo de modelos.
- 20 de agosto — v0.32.15. Nuevo proceso de incorporación para ordenadores de sobremesa y almacenamiento en caché de metadatos entre solicitudes que reducir el tiempo hasta la llegada del primer token aproximadamente a la mitad.
- 11 de agosto — NVIDIA Nemotron 3.5 Lightning, un modelo 30B optimizado para flujos de trabajo agenticos con invocación de herramientas en hardware personal.
- 10 de agosto — «Muse Glimmer», de Meta, un modelo multimodal 30B en el marco de Apache 2.0, acelerado por el motor MLX de Ollama. Cabe destacar que, a pesar del desplome de Llama en cuanto al uso de rutas, Meta sigue ofreciendo pesos verdaderamente permisivos.
- 9 de julio — Ronda de financiación $88M, según informa Ollama 8,9 millones de desarrolladores.
- 29 de junio — Gemma 4 en MLX, hasta 90% más rápido mediante la predicción multitóken, lo que beneficia de forma desproporcionada a los agentes de codificación que utilizan Apple Silicon.
- 5 de junio — En la versión 0.30 se ha añadido compatibilidad con GGUF a través de llama.cpp, ampliando la compatibilidad con el hardware mucho más allá de Apple Silicon.
La idea central es que Ollama ha dejado de ser “la forma más sencilla de ejecutar un modelo pequeño en tu ordenador portátil” para convertirse en una pasarela de uso general que, además, permite ejecutar modelos de forma local. El catálogo en la nube incluye ahora kimi-k3:cloud, glm-5.3:nube, glm-5.3-flash, deepseek-v4-pro, deepseek-v4-flash, minimax-m3, qwen3.5 en siete tallas, gpt-oss en los apartados 20 ter y 120 ter, gemma4, la familia Nemotron 3 y mistral-large-3.
Configurarlo todo: copiar y pegar configuraciones
Ollama + Claude Code (la ruta más rápida)
Ollama incluye un lanzador de un solo comando que se encarga de la configuración del entorno por ti:
bash
ollama launch claudeSi prefieres hacerlo manualmente —lo cual deberías hacer si estás creando un script—, instala primero Claude Code:
bash
# macOS / Linux
curl -fsSL https://claude.ai/install.sh | bash

# Windows (PowerShell)
irm https://claude.ai/install.ps1 | iex
A continuación, apúntalo hacia Ollama:
bash
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
Y ejecútalo con el modelo que quieras:
bash
# Un modelo local
claude --model qwen3.5

# Un modelo en la nube — fíjate en el sufijo :cloud
claude --model kimi-k3:cloud
O bien, en línea, sin exportar nada a nivel global:
bash
ANTHROPIC_AUTH_TOKEN=ollama \
ANTHROPIC_API_KEY="" \
ANTHROPIC_BASE_URL=http://localhost:11434 \
claude --model glm-5.3:cloud
Dos cosas que te van a dar un buen susto.
En primer lugar, no exportar ANTHROPIC_BASE_URL de forma permanente en tu perfil de shell. Es una variable global y redirigirá de forma silenciosa todas las herramientas compatibles con Anthropic de tu equipo a Ollama, incluida aquella con la que querías comunicarte con Anthropic. Defínela por proyecto o por invocación.
En segundo lugar, Establece la longitud del contexto en 64 k o más para cualquier cosa que funcione en un repositorio real. La configuración predeterminada de Ollama es más reducida, y un agente de programación que se ejecute discretamente en segundo plano simplemente empezará a olvidar cosas en lugar de mostrar mensajes de error.
Para ejecuciones de CI, Docker o mediante scripts, --sí omite las indicaciones interactivas:
bash
ollama launch claude --model glm-5.3:cloud --yes -- -p "¿Cómo funciona este repositorio?"GLM-5.3 directamente desde Z.ai
Si prefieres el enrutamiento directo en lugar de pasar por Ollama, Z.ai pone a tu disposición tres puntos de conexión de protocolo:
| Protocolo | URL base |
|---|---|
| Mensajes antropicos | https://api.z.ai/api/anthropic |
| Completados de OpenAI Chat | https://api.z.ai/api/coding/paas/v4 |
| Respuestas de OpenAI | https://api.z.ai/api/v1 |
Un bloque de proveedor OpenCode para GLM-5.3:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "zai": {
 "npm": "@ai-sdk/openai-compatible",
 "name": "Z.AI",
      "options": {
 "baseURL": "https://api.z.ai/api/coding/paas/v4",
 "apiKey": "{env:ZAI_API_KEY}"
      },
 "models": {
 "glm-5.3": {
 "name": "GLM-5.3",
          "limit": { "context": 1000000, "output": 128000 },
 "options": { "reasoning_effort": "high", "temperature": 1 }
        }
 }
    }
  },
  "model": "zai/glm-5.3"
}
Nota importante sobre la actualización: GLM-5.3 requiere que el razonamiento esté habilitado. Si tu configuración actual establece thinking.type: "desactivado", que ahora dará error. Cámbialo por "activado" y establecer esfuerzo_de_razonamiento: "bajo" si quieres volver al perfil de latencia anterior.
esfuerzo_de_razonamiento es tu principal factor a la hora de sopesar calidad y coste: bajo para llamadas en las que la latencia es un factor importante, alto para trabajos de gran envergadura, máx. (la opción predeterminada) para problemas que realmente han resultado imposibles de resolver alto. Dada la verbosidad documentada, yo ejecutaría alto como un escenario cotidiano, en lugar de marcharse máx. y preguntándome dónde se habían ido los tokens de salida.
La configuración de enrutamiento que realmente recomendaría
No se trata de una decisión del tipo “elige una opción”. La respuesta correcta para la mayoría de los equipos es una tabla de enrutamiento de tres niveles, y cualquier sistema de gestión de agentes que se precie admite modelos por agente.
json
{
  "$schema": "https://opencode.ai/config.json",
  "model": "zai/glm-5.3",
  "small_model": "ollama/gemma4",
  "agent": {
    "plan": {
 "description": "Arquitectura, análisis de causas raíz, cualquier cosa que resulte muy costoso hacer mal",
 "model": "anthropic/claude-fable-5-1"
    },
    "build": {
 "description": "La mayor parte del trabajo de implementación",
 "model": "zai/glm-5.3",
 "options": { "reasoning_effort": "high" }
    },
    "investigación": {
 "descripción": "Lectura de textos largos, investigación en la web, síntesis a partir de múltiples fuentes",
 "modelo": "ollama/kimi-k3:cloud"
    },
    "grunt": {
 "description": "Renombramientos, cadenas de documentación, estructura de pruebas, correcciones de lint",
 "model": "ollama/glm-5.3-flash"
    }
  }
}
El razonamiento que hay detrás de cada línea:
- Planning lanza Fable 5.1. La planificación es la fase en la que una mala decisión te cuesta más tokens a largo plazo, y la coherencia a largo plazo es precisamente para lo que se diseñó la versión 5.1. También es la fase en la que gastas menos tokens, por lo que el recargo se aplica a la parte más pequeña de tu factura.
- El edificio cuenta con GLM-5.3. La mejor relación calidad-precio del mercado, y aquí es donde se destina la mayor parte de tu gasto en tokens.
- El departamento de investigación le asigna a Kimi el K3. BrowseComp 91.2 y un contexto 1M auténtico lo convierten en la mejor opción disponible para leer gran cantidad de información y sintetizarla.
- El trabajo mecánico cuenta con GLM-5.3-Flash. En $0.15/$0.50 es prácticamente gratuito, y cambiar el nombre de un símbolo en 40 archivos no requiere un razonamiento complejo.
modelo_pequeñoconsigue algo diminuto para las tareas internas del propio harness: generación de títulos, resumen, llamadas a utilidades internas.
No estás eligiendo un ganador. Estás montando una caja de cambios. Y escribe los identificadores de los modelos de tal forma que cambiarlos suponga un cambio de una sola línea, porque en este mercado volverás a hacer ese cambio antes de que termine el trimestre.
Lo que realmente puedes ejecutar de forma local (la realidad del hardware)
Voy a desmentir una suposición antes de que le cueste dinero a alguien.
No se puede ejecutar Kimi K3 ni GLM-5.3 en una estación de trabajo. Ni con una 5090. Ni con dos.
Kimi K3
- ~1,5 TB de los pesos en MXFP4 nativo — y recuerda que es el punto de control cuantificado, no un punto de partida para una compresión posterior
- Moonshot recomienda un mínimo de 64 aceleradores para un servicio competitivo
- El autoalojamiento realista comienza con clústeres de varios nodos; las implementaciones de referencia utilizan racks GB300 NVL72
- Hay No hay ninguna entrada oficial en la biblioteca de Ollama En cuanto al Kimi K3 local, no hay ninguna conversión GGUF para el mercado de consumo que merezca la pena recomendarte.
- Hay informes que indican que funciona en clústeres de tarjetas RTX 5090 de consumo, pero “un clúster de 5090” no es un portátil y el rendimiento no es comparable
GLM-5.3
- ~1,5 TB en BF16, más o menos 750 GB a FP8
- Nodo único mínimo viable: 8 × H200 (1.128 GB de memoria de GPU) en FP8, lo que deja unos 375 GB para la caché de KV
- BF16 necesita dos nodos 8×H200 o un único nodo 8×B300 (2.304 GB)
- Un único nodo de 8×H200 en BF16 es demasiado pequeño para albergar los pesos y la caché.
Mostrar imagen Los modelos abiertos de Frontier necesitan un rack. El nivel de 24 GB es donde realmente se encuentra “funciona en mi máquina”, y ha mejorado mucho.
Entonces, ¿qué significa realmente “IA local” en septiembre de 2026?
Significa que se trata de una gama diferente de modelos, y esa gama ha mejorado de verdad:
| Modelo | VRAM | Para qué sirve |
|---|---|---|
| Qwen3.8-27B | 24 GB en el cuarto trimestre | El mejor equipo polivalente en hardware de consumo — 61,71 TP3T en SWE-bench |
| gpt-oss:20b | 16 GB | El mejor modelo pequeño, con esfuerzo de razonamiento ajustable |
| Gemma 4 E4B | ~6 GB | La herramienta Vision Plus se ejecuta en un ordenador portátil moderno |
| Mistral 7B | 8 GB | La opción más rápida para uso general, 40-60 tok/seg. |
| DeepSeek-R1 7B | 5 GB | Razonamiento en cadena de pensamientos en la GPU de un ordenador portátil |
| Llama 4 Scout | ~55 GB en el cuarto trimestre | Contexto de 10 M, multimodal: el ámbito de las estaciones de trabajo |
Un Qwen3.8-27B que alcanza los 61,71 TP3T en SWE-bench, funcionando íntegramente con una GPU de consumo de 24 GB y sin conexión a red, es algo extraordinario que habría parecido ciencia ficción hace dieciocho meses. No es GLM-5.3 ni pretende serlo.
La versión sincera: Los precios de mercado en la frontera te permiten comprar soberanía y precio, no ejecución local. Los pesos abiertos en el rango de 7B a 30B te ofrecen una ejecución local auténtica, con un coste de capacidad real pero aceptable, y ese es el nivel en el que el requisito de “funciona en mi máquina, no ve la red” es factible.
La arquitectura que mejor funciona para la mayoría de mis clientes es precisamente esa división: un pequeño modelo local para todo lo que tenga que ver con datos verdaderamente sensibles, y un modelo «frontier» alojado y de peso abierto para todo lo demás, en el que los pesos sirven más como medida de seguridad que como plan de implementación.
Dónde falla realmente cada modelo
Sin exageraciones. Estas son las debilidades reales.
Puntos débiles del Kimi K3
Es caro para ser un modelo abierto. $3/$15 ofrece una velocidad de entrada 2,1 veces superior a la del GLM-5.3 y una velocidad de salida 3,4 veces superior, con una puntuación en el índice de inteligencia prácticamente idéntica. Si te decantas por el K3 en lugar del GLM-5.3, ten claro qué es lo que estás comprando con ese sobreprecio; normalmente se trata de la pila de visión o del rendimiento de navegación.
La licencia tiene la tarifa más baja. Un umbral de ingresos totales de MaaS de $20M afecta a muchas más organizaciones que el de $10B de GLM-5.3. Si la reventa de inferencias forma parte de tu modelo de negocio, K3 es el más restrictivo de los dos.
El autoalojamiento está fuera del alcance de casi todo el mundo. 1,5 TB y más de 64 aceleradores suponen un compromiso importante en materia de infraestructura. El derecho de salida es, en este caso, más teórico que en cualquier otro modelo de esta comparación.
Amplia experiencia en el ámbito del trabajo intelectual. GDPval-AA v2, con una puntuación de 1.687, queda por detrás de GLM-5.3, tanto de Claude Fables como de GPT-5.6 Sol Max. Se trata de un especialista en programación y comportamiento agente que, además, es enorme.
Puntos débiles del GLM-5.3
Solo texto. Sin entrada de imagen, no hay vídeo. Si tu flujo de trabajo incluye la depuración mediante capturas de pantalla, la conversión de diseño a código o el reconocimiento de documentos, GLM-5.3 simplemente no puede hacerlo y necesitarás GLM-5.3-Flash, Kimi K3 o Fable 5.1 en su lugar. Este es, sin duda, el error de configuración más habitual que espero que cometa la gente, ya que los ID de los modelos parecen relacionados, pero no lo están.
Es prolijo, y la prolijidad se factura. 170 millones de tokens emitidos, frente a una mediana de 72 millones en toda la suite de AA. esfuerzo_de_razonamiento por defecto es máx., y no se puede dejar de pensar. Prevé más fichas de producción de las que corresponderían a tu número de turnos.
La licencia ya no es MIT, y la cláusula de revisión de seguridad no tiene límites. Para la mayoría de los lectores, el umbral $10B hace que todo esto sea una cuestión teórica. Para cualquiera que se acerque a ese umbral, la cláusula “el alcance y el método serán determinados de forma razonable por Z.AI” no es algo que vaya a gustar a su equipo jurídico.
Terminal-Bench 3.0, con 28,3, queda por detrás de los 34,6 de GPT-5.6 Sol. En el indicador específico más cercano a la codificación agénica nativa del terminal, se queda por detrás de la competencia más reñida en el mismo ámbito.
Es una novedad en la categoría de peso libre. Lanzado el 28 de agosto. La comunidad lleva unos días, no meses, utilizándolo. Aún no han surgido errores de implementación a largo plazo.
Puntos débiles de Claude Fable 5.1
El precio. Aproximadamente 6,5 veces el GLM-5.3 por tarea agénica completada, incluso tras el recorte de lectura de caché de 75%. Para la mayor parte del trabajo, esa diferencia ya no es justificable desde el punto de vista de la capacidad.
Tres cambios que afectan a la compatibilidad. El uso forzado de herramientas devuelve el código 400. Los «thinking blocks» no son compatibles con versiones anteriores. La edición del historial de conversaciones invalida los «thinking blocks» en las cuentas creadas después del 31 de agosto de 2026. Cualquiera de estas situaciones puede provocar que una integración que funcionaba deje de hacerlo tras una actualización.
La llamada a herramientas en paralelo ha empeorado. Hay informes que indican una llamada por turno, mientras que Fable 5 agrupaba varias. En un bucle largo de agentes, eso supone que estás pagando dos veces por el tiempo real transcurrido.
Opcionalidad de salida nula. Sin ponderaciones, sin autoalojamiento, sin fijación de versiones más allá de lo que ofrece Anthropic, sin inspección. Cuando cambia, te adaptas.
El tokenizador exagera las comparaciones. ~30% más tokens que los modelos anteriores de Claude para el mismo texto, lo que hace que las comparaciones históricas de costes resulten engañosas a favor de Anthropic si no se tiene cuidado.
El marco de decisión: seis escenarios
Mostrar imagen Seis situaciones, seis respuestas. Busca la fila que mejor se ajuste a tu semana.
1. “Quiero un solo modelo. Configúralo una vez, olvídate de él y que la factura no se dispare”.”
GLM-5.3. A menos de medio punto de Kimi K3 y a unos tres puntos del mejor modelo cerrado en el índice neutro, en $1,40/$4,40. Ejecútalo en Ollama con un plan Pro o Max, configura esfuerzo_de_razonamiento: alto, y sigue con tu trabajo. Lo único que debería hacerte descartar esta respuesta es la necesidad de introducir imágenes.
2. “Mi trabajo es visual: interfaz de usuario, diseño a código, depuración de capturas de pantalla y documentación”.”
Kimi K3 o GLM-5.3-Flash, no GLM-5.3. MoonViT-V2 de K3 gestiona texto, imágenes y vídeo de forma nativa y obtiene una puntuación de 81,6/83,4 en MMMU-Pro. GLM-5.3-Flash es la opción más económica, con multimodalidad nativa y una licencia del MIT. GLM-5.3 solo admite texto y, sencillamente, rechazará cualquier entrada que no sea de este tipo.
3. “Sesiones autónomas prolongadas en las que equivocarse sale caro”.”
Claude Fable 5.1. Para eso se diseñó y las pruebas de rendimiento lo confirman: Terminal-Bench-Science duplicó los resultados, con 821 TP3T en las tareas informáticas más exigentes de Browserbase frente a los 741 TP3T de Opus 5, y las mayores mejoras publicadas en tareas agenticas de varias horas de duración. La reducción de 751 TP3T en la lectura de caché hace que precisamente esta carga de trabajo resulte hasta 451 TP3T más económica de lo que era. Vale la pena pagar un sobrecoste cuando un error cuesta más que los tokens.
4. “La residencia de datos en la UE es un requisito imprescindible”.”
GLM-5.3-Flash si necesitas el MIT; GLM-5.3 si necesitas prestaciones. Alójalo tú mismo en tu propio hardware o en un proveedor de GPU de la UE y la cuestión de la transferencia transfronteriza dejará de existir. Calcula un presupuesto de 8×H200 para GLM-5.3 a FP8; Flash es mucho más manejable con 320B/18B. Si el autoalojamiento se sale del presupuesto, el alojamiento de Ollama en Europa, sin retención de datos, es la solución intermedia más pragmática, pero asegúrate de que el compromiso de residencia figure por escrito, en lugar de deducirlo de una página de marketing.
5. “Un equipo pequeño, un presupuesto ajustado y programando todo el día”.”
GLM-5.3-Flash como opción predeterminada, GLM-5.3 para problemas difíciles, Ollama Pro con $20. Flash cuesta $0,15/$0,50 —actualmente la mitad de ese precio hasta el 9 de septiembre— y obtiene una puntuación de 57,5 en el índice de inteligencia. Con veinte dólares se compran sesenta dólares en fichas sin límites semanales. Para un equipo de dos a cuatro personas, esta opción es prácticamente imbatible. El Plan de Codificación GLM a $18 al mes (Lite) es la alternativa si prefieres una cuota fija en lugar de un fondo común de créditos.
6. “Tengo que justificarlo ante el equipo de compras o el departamento jurídico”.”
GLM-5.3-Flash. Es el único modelo de esta comparativa que se rige por una licencia estándar aprobada por la OSI (MIT), es multimodal de forma nativa, obtiene una puntuación de 57,5 en el índice de neutralidad, y los pesos están disponibles en Hugging Face sin restricciones de ingresos, sin obligaciones de atribución y sin cláusula de revisión de seguridad. Cuando la pregunta es “¿qué podemos defender en una revisión contractual?”, las licencias permisivas superan siempre en tres puntos el valor de referencia.
Lo que seguiría de cerca durante el próximo trimestre
Si Fable 5.1 supera los 62,1 en el índice de Análisis Artificial. Se lanzó el día antes de la publicación de este artículo y aún no se le ha realizado una evaluación independiente. Sus diferencias con respecto a Fable 5 en las pruebas de rendimiento sugieren que debería, pero “debería” no es lo mismo que “lo hizo”, y la diferencia con respecto a los 59,7 de Kimi K3 es la cifra en torno a la cual gira todo el debate entre código abierto y código cerrado.
Si la deriva de la licencia continúa. En ocho semanas pasamos de la versión GLM-5.2 bajo la licencia MIT a la GLM-5.3 bajo una licencia a medida con una revisión de seguridad discrecional, y de la versión MIT modificada de Kimi K2 a las condiciones de K3 basadas en los ingresos. Si GLM-6 y K4 se endurecen aún más, ’open weights’ pasará a ser un término de marketing en lugar de una categoría con sentido. Que GLM-5.3-Flash se mantenga bajo la licencia MIT es la señal contraria que merece la pena seguir de cerca.
Si otros laboratorios adoptarán el modelo de lanzamiento por fases de Z.ai. Una retención de dos semanas, acompañada de una justificación de seguridad publicada, se ha convertido en la nueva norma. Si se mantiene, es una buena medida. Si, en cambio, se convierte en una excusa para retrasar cada vez más el envío de las pesas, es un camino fácil hacia la no entrega de las mismas.
Verificación independiente de las afirmaciones sobre la capacidad cibernética. 2.436 vulnerabilidades en 269 proyectos es una cifra extraordinaria y, además, se trata de datos facilitados exclusivamente por los propios interesados. Es necesario que una entidad neutral los verifique, ya que, si son exactos, replantean por completo el debate sobre la seguridad de OpenWeights, y si no lo son, habrán sido una estrategia de marketing eficaz.
Las cotizaciones por token de Ollama dentro de seis meses. Ofrecer $20 por $60 de uso es una estrategia inicial agresiva por parte de una empresa que recaudó $88M en julio. Que esos multiplicadores resistan el contacto con la economía real por unidad es la variable más importante en la tesis de los “modelos de acceso barato” para equipos pequeños.
Si los modelos locales se acercan al nivel 30B. Qwen3.8-27B con 61,71 TP3T en SWE-bench con 24 GB es el resultado del que menos se ha hablado este año. La frontera acapara los titulares; sin embargo, el nivel de 24 GB es lo que cambia lo que una empresa normal puede hacer sin una clave API.
Preguntas frecuentes
¿Es Kimi K3 realmente de código abierto? No. Los pesos de Kimi K3 se pueden descargar gratuitamente desde Hugging Face, pero están sujetos a una ’Licencia Kimi K3“ propia, y no a una licencia de código abierto aprobada por la OSI. Los operadores de ”Modelo como servicio“ cuyos ingresos totales superen los $20 millones en cualquier periodo de 12 meses consecutivos deberán negociar un acuerdo comercial independiente con Moonshot, y los productos con más de 100 millones de usuarios activos mensuales o con unos ingresos mensuales superiores a $20 millones deberán mostrar la mención ”Kimi K3» en su interfaz. El uso puramente interno no está sujeto a restricciones.
¿Es el GLM-5.3 mejor que el Kimi K3? Prácticamente están empatados en el índice agregado neutral: 59,5 frente a 59,7 en Artificial Analysis. GLM-5.3 es 2,2 veces más económico por tarea agénica y obtiene una puntuación más alta en trabajo intelectual (GDPval-AA v2: 1.769 frente a 1.687). Kimi K3 es multimodal de forma nativa, lidera la navegación agentiva (BrowseComp 91,2) y obtuvo el primer puesto en la competición de código frontend de Arena.AI. Elige GLM-5.3 por su coste y para la programación basada en texto; Kimi K3 para la visión, la navegación y la investigación a largo plazo.
¿Cuánto más baratos son los modelos abiertos que el Claude Fable 5.1? En una tarea agencial modelada de 60 turnos, GLM-5.3 cuesta aproximadamente $1,85 frente a los $11,94 de Fable 5.1, lo que supone un coste aproximadamente 6,5 veces menor. Kimi K3 cuesta aproximadamente $4,07, es decir, unas 2,9 veces más barato. GLM-5.3-Flash cuesta aproximadamente $0,21, es decir, unas 58 veces más barato. Más de 80 ejecuciones al mes, lo que supone $148 frente a $955.
¿Puedo ejecutar Kimi K3 o GLM-5.3 de forma local? No en hardware de consumo. Kimi K3 ocupa aproximadamente 1,5 TB incluso en su formato nativo MXFP4, y Moonshot recomienda 64 o más aceleradores. GLM-5.3 necesita un mínimo de 8×H200 (1.128 GB) en FP8. Para una ejecución local auténtica, echa un vistazo a Qwen3.8-27B (24 GB en Q4), gpt-oss:20b (16 GB) o Gemma 4 E4B (~6 GB).
¿Qué novedades presenta la versión 5.1 de Claude Fable? Lanzado el 1 de septiembre de 2026. Las lecturas de caché se redujeron en 751 TP3T, pasando de 1 TP4T 1,00 a 1 TP4T 0,25 por millón de tokens, lo que abarató las cargas de trabajo típicas en unos 251 TP3T y las cargas de trabajo «agenticas» en hasta 451 TP3T; las entradas y salidas se mantuvieron en $10/$50. Terminal-Bench 4.0 pasó de 42,0% a 55,8%, Terminal-Bench-Science de 24,71 TP3T a 52,61 TP3T, y AutomationBench de 17,11 TP3T a 31,41 TP3T. Hay tres cambios importantes que afectan al uso obligatorio de herramientas, a la portabilidad de los bloques de pensamiento y a la edición del historial.
¿Cuál es la nueva estructura de precios de Ollama? A partir del 31 de agosto de 2026, los planes Pro, Max y Team aplicarán una tarifa por token con créditos incluidos: Pro: 1 TP por 4 T al mes para un uso de 1 TP por 4 T al mes; Max: 1 TP por 4 T al mes para un uso de 1 TP por 4 T al mes; Team: 1 TP por 4 T al mes para un uso de 1 TP por 4 T al mes, compartido entre un número ilimitado de usuarios. Se han eliminado por completo los límites de 5 horas y semanales, no hay comisiones por el servicio, los créditos no se acumulan y todos los planes ofrecen cero retención de datos, con alojamiento en EE. UU. y Europa.
¿Cuál de estos modelos tiene realmente una licencia del MIT? Solo GLM-5.3-Flash —un modelo multimodal nativo independiente de 320B/18B lanzado el 26 de agosto de 2026—, que obtuvo una puntuación de 57,5 en el índice Artificial Analysis con $0,15/$0,50 por millón de tokens. Tanto GLM-5.3 como Kimi K3 utilizan licencias a medida basadas en los ingresos; Claude Fable 5.1 es totalmente propietario.
¿Por qué no puedo comparar estos modelos en Terminal-Bench? Porque cada uno de ellos se evaluó con una versión diferente. La puntuación de 88,3 de Kimi K3 corresponde a Terminal-Bench 2.1, la de 28,3 de GLM-5.3 a la versión 3.0 y la de 55,8 de Fable 5.1 a la versión 4.0. Cada versión es considerablemente más difícil que la anterior, por lo que las puntuaciones no están en la misma escala. Compáralas únicamente dentro de una misma versión. En Terminal-Bench 2.1, por ejemplo, Kimi K3 obtiene una puntuación de 88,3 frente a los 88,0 de Claude Fable 5, los 88,8 de GPT-5.6 Sol y los 84,3 de GLM-5.3-Flash; esa comparación es válida y es la que merece la pena citar.
¿Debería recurrir a Ollama o dirigirme directamente al proveedor? Elige Ollama si quieres una única relación de facturación, una única interfaz API, un cambio sencillo de modelos y alojamiento en la UE o EE. UU. sin retención de datos: sus tarifas por token se ajustan estrechamente a los precios del proveedor original. Elige Direct si necesitas funciones propias del proveedor, como las de Z.ai: esfuerzo_de_razonamiento controles con máxima precisión, acuerdos de nivel de servicio (SLA) de los proveedores o planes de suscripción, como el Plan de Codificación GLM. Muchos equipos utilizan ambos y los distribuyen en función de la carga de trabajo.
¿Admite GLM-5.3 imágenes? No. GLM-5.3 es solo de texto. GLM-5.3-Flash —un modelo completamente distinto a pesar de tener un nombre similar— es multimodal de forma nativa y admite entradas de texto, imágenes, vídeo y archivos. Enviar imágenes al ID de modelo equivocado es el error inicial más común con la familia GLM.
Conclusión
Hace doce meses, la pregunta que se planteaba en la categoría de peso libre era si estos modelos eran viables. Hace seis meses, se trataba de saber si eran competitivos. En septiembre de 2026, la pregunta es realmente: ¿Por qué sigues pagando una prima por un modelo cerrado?
Hay una respuesta real a esa pregunta, y es más limitada de lo que solía ser. Claude Fable 5.1 destaca en las tareas agentivas sostenidas más complejas, en el trabajo de conocimiento general y en el tipo de depuración en el que un modelo necesita mantener un problema complejo en su memoria durante horas sin desviarse. El modelo 75% de Anthropic, con lectura de caché, está diseñado precisamente para esa carga de trabajo. Si el coste de un fallo supera el coste de los tokens, esa prima resulta racional.
En todo lo demás, las cifras han cambiado. GLM-5.3 alcanza una puntuación de 941 TP3T en el índice de Claude Opus 5 con un coste de 291 TP3T. Kimi K3 obtiene una puntuación de 88,3 en Terminal-Bench 2.1 frente a los 88,0 de Claude Fable 5 en la misma versión, y se ha situado en primer lugar en la Frontend Code Arena de LMArena, por delante de ambos modelos cerrados insignia. Ollama te venderá $60 de tokens por $20 y, además, eliminará los límites de uso. Esa combinación no existía en primavera.
Pero no dejes que el entusiasmo te haga pasar por alto la letra pequeña, porque hay dos y ambas son importantes.
El primero es el tema de las licencias. “Los términos ”open weights“ y ”código abierto“ han dejado de significar lo mismo, aunque de forma discreta. Tanto Kimi K3 como GLM-5.3 se distribuyen bajo licencias personalizadas y sujetas a ingresos. Los requisitos son lo suficientemente exigentes como para que la mayoría de los usuarios no se vean afectados, pero ”que la mayoría de los usuarios no se vean afectados“ no es lo mismo que ”sin restricciones’, y la cláusula indefinida de revisión de seguridad de GLM-5.3 supone un riesgo real en materia de contratación pública para las grandes empresas. GLM-5.3-Flash bajo la licencia MIT es la última opción totalmente permisiva cercana a la frontera, y precisamente por eso merece más atención de la que recibe.
La segunda es que el autoalojamiento es, en su mayor parte, una aspiración. 1,5 TB de datos de entrenamiento y 64 aceleradores no constituyen un plan de salida para una empresa mediana. Lo que te aportan los datos de entrenamiento abiertos en este nivel es un mercado de inferencia competitivo, transparencia de precios, fijación de versiones, elección de jurisdicción y una posición negociadora. Todo eso tiene un gran valor. No es lo mismo que ejecutar el sistema en tu sótano.
La configuración que realmente montaría: GLM-5.3 como opción predeterminada, Fable 5.1 para la planificación y los problemas realmente difíciles, Kimi K3 para la visión y la investigación a largo plazo, GLM-5.3-Flash para el trabajo pesado, y un modelo local de 27B para todo aquello que nunca deba salir del edificio. Dirige el tráfico según la carga de trabajo, no según la fidelidad. Escribe tu configuración de manera que los ID de los modelos se puedan modificar en una sola línea.
Porque la única predicción de la que estoy seguro es que habrá que actualizar este artículo antes de Navidad.
¿Estás utilizando alguno de estos tres en entorno de producción? Me interesa especialmente saber si la verbosidad de GLM-5.3 supone un verdadero problema de costes a gran escala, y si alguien ha presentado realmente la licencia de Kimi K3 a un asesor jurídico y ha obtenido una interpretación clara de la definición de MaaS. Ponte en contacto conmigo: se aceptan correcciones y pruebas contrarias, y este artículo se actualizará cuando la situación cambie.
Última actualización: 2 de septiembre de 2026.