
 Bahasa Indonesia
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Русский
 العربية
 हिन्दी

Pada 2012, sistem computer vision terbaik di dunia masih keliru membedakan anjing dari kucing. Pada 2026, kamu bisa mengetik satu kalimat dan menonton film tiga puluh detik yang fotorealistis tersusun sendiri — gerakan kamera, pencahayaan sinematik, dialog tersinkronisasi, dan semuanya — dalam waktu lebih singkat daripada menuangkan kopi.
Itu bukan satu dekade kemajuan yang stabil. Itu planet yang berbeda.
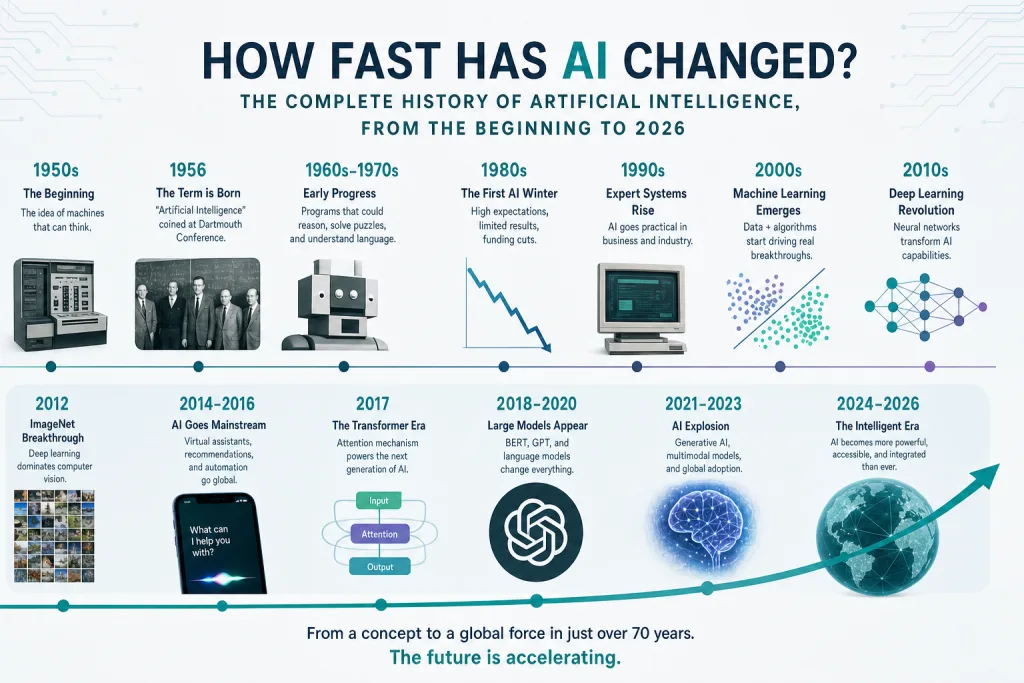
Kisah tentang bagaimana kecerdasan buatan sampai di titik ini adalah salah satu kurva percepatan paling aneh dalam sejarah teknologi. Selama lima puluh tahun ia merangkak. Lalu, dalam sekitar sepuluh tahun, ia berlari melampaui tonggak yang dulu dianggap para peneliti masih beberapa generasi lagi. Kalau kamu merasa lehermu pegal mencoba mengikuti — nama model baru setiap beberapa minggu, kemampuan yang musim semi lalu tampak mustahil muncul sebagai fitur gratis musim panas ini — kamu tidak berkhayal. Lajunya memang secepat itu, dan masih bertambah cepat.
Ini adalah sejarah lengkap dan manusiawi dari percepatan itu: dari mana AI berasal, segelintir terobosan yang mengubah segalanya, perlombaan senjata antara model tertutup dan terbuka, kebangkitan pembuatan gambar dan video AI, dan ke mana semua ini bergerak selanjutnya.
Ambil kopinya. Ini bacaan yang panjang.
Daftar isi
- Jalan panjang dan lambat: AI sebelum ledakan (1950–2011)
- Percikan: bagaimana pembelajaran mendalam menyala pada 2012
- Arsitektur yang mengubah segalanya: Transformer (2017)
- Era GPT dan lahirnya LLM modern (2018–2022)
- ChatGPT: minggu ketika AI menjadi arus utama
- Perlombaan senjata model tertutup (2023–2026)
- Revolusi model terbuka: bobot untuk semua orang
- Ketika AI belajar melihat dan melukis: kisah pembuatan gambar
- Ketika AI belajar bergerak: kebangkitan video AI
- Lebih dari teks dan piksel: suara, multimodalitas, dan era agen
- Mengapa AI tiba-tiba bergerak begitu cepat?
- Ke mana AI pergi berikutnya
- Pertanyaan yang sering diajukan
Jalan panjang dan lambat: AI sebelum ledakan (1950–2011)
Mudah tergoda untuk berpikir kecerdasan buatan ditemukan sekitar 2022. Tidak. Mimpi itu hampir setua komputer modern itu sendiri.
Pada 1950, Alan Turing mengajukan pertanyaan yang tampak sederhana — bisakah mesin berpikir? — dan mengusulkan permainan imitasi yang sekarang kita sebut Turing Test. Enam tahun kemudian, lokakarya musim panas di Dartmouth College memberi bidang ini namanya dan optimisme pendirinya. Para perintis awal percaya mesin berpikir mungkin tinggal dua puluh tahun lagi. Mereka salah sekitar setengah abad, dan salah hitung itu membentuk beberapa dekade pertama bidang ini.
Pendekatan awalnya adalah AI simbolik: gagasan bahwa kecerdasan bisa ditangkap dalam aturan eksplisit, logika, dan pengetahuan yang dikodekan dengan tangan. Kalau kamu cukup menuliskan banyak jika-ini-maka-itu pernyataan, penalarannya akan mengikuti. Ini menghasilkan beberapa “sistem pakar” yang benar-benar berguna pada 1970-an dan 80-an — program yang bisa mendiagnosis penyakit tertentu atau mengonfigurasi pesanan komputer — tetapi pendekatan itu membentur dinding. Dunia nyata terlalu berantakan, terlalu penuh pengecualian, untuk ditangkap oleh aturan yang diketik manusia dengan tangan.
Ketika janji melampaui hasil, pendanaan mengering. Bidang ini melewati dua masa panjang dan dingin yang kini dikenal sebagai musim dingin AI, ketika “AI” hampir menjadi kata kotor di kalangan peneliti serius yang tidak ingin lamaran hibah mereka dibuang ke tempat sampah.
Namun diam-diam, gagasan lain bertahan di pinggiran: pembelajaran mesin. Daripada memprogram kecerdasan dengan tangan, bagaimana kalau kamu membiarkan sistem mempelajari pola dari data? Jaringan neural — yang secara longgar terinspirasi otak — sudah ada sejak 1950-an, tetapi kekurangan daya komputasi dan sebagian besar diabaikan. Sepanjang 1990-an dan 2000-an, pembelajaran mesin statistik menggerakkan filter spam, mesin rekomendasi, dan peringkat pencarian. Itu berhasil, menghasilkan uang, dan hampir tidak ada orang di luar bidang ini yang menyebutnya “AI.” Itu hanya… perangkat lunak yang makin baik dengan lebih banyak data.
Kepingan-kepingannya sudah ada di papan. Tinggal menunggu momen yang tepat.
Percikan: bagaimana pembelajaran mendalam menyala pada 2012
Kalau kamu ingin satu tanggal saat era modern dimulai, kandidat kuatnya adalah 2012.
Tahun itu, sebuah jaringan neural bernama AlexNet masuk ke kompetisi ImageNet — kontes tahunan untuk memberi label yang benar pada jutaan gambar — dan tidak sekadar menang. Ia menang telak, memangkas tingkat kesalahan begitu drastis sehingga hasilnya seperti salah ketik. Ia memakai jaringan neural “dalam” (banyak lapisan yang ditumpuk) yang dilatih di kartu grafis, atau GPU, yang kebetulan sangat jago pada jenis matematika paralel yang dibutuhkan jaringan neural.
Kombinasi itu — data besar, jaringan dalam, dan komputasi paralel yang murah — adalah percikannya. Tiba-tiba pendekatan jaringan neural yang diabaikan selama puluhan tahun bukan hanya layak; ia dominan. Dalam beberapa tahun, pembelajaran mendalam melampaui teknik-teknik lama dalam pengenalan gambar, pengenalan suara, dan penerjemahan. Raksasa teknologi menyadarinya. Mereka mulai merekrut setiap peneliti pembelajaran mendalam yang bisa ditemukan dan mengarahkan anggaran komputasi raksasa ke masalah itu.
Untuk pertama kalinya, “lemparkan lebih banyak data dan lebih banyak komputasi ke jaringan yang lebih besar” adalah strategi yang andal berhasil. Wawasan itu segera membentuk ulang seluruh industri — tetapi bidang ini masih kekurangan satu bahan penting untuk menangani bahasa dengan benar.
Arsitektur yang mengubah segalanya: Transformer (2017)
Inilah terobosan yang hampir tidak diketahui siapa pun di luar AI, padahal ia menopang hampir semua yang kamu pakai sekarang.
Pada 2017, tim peneliti Google menerbitkan makalah dengan judul yang nakal: “Attention Is All You Need”. Makalah itu memperkenalkan Transformer, arsitektur jaringan neural baru yang dibangun di sekitar mekanisme bernama attention — cara bagi model untuk menimbang seberapa erat hubungan setiap kata dalam kalimat dengan setiap kata lain, sekaligus, secara paralel.
Kedengarannya abstrak, jadi inilah kenapa itu penting. Model bahasa sebelumnya memproses teks satu kata demi satu kata, berurutan, sehingga lambat dilatih dan mudah lupa pada bagian yang panjang. Transformer memproses semuanya secara paralel dan bisa menyimpan hubungan jarak jauh dalam “pikiran.” Mereka lebih cepat dilatih, berkembang mulus dengan lebih banyak data dan komputasi, dan — yang krusial — mereka menjadi lebih baik lebih baik dengan cara yang mulus dan terprediksi saat kamu membuatnya makin besar.
Sifat terakhir itulah mesin senyap dari seluruh ledakan ini. Para peneliti menemukan apa yang kemudian dikenal sebagai hukum penskalaan: tuangkan lebih banyak parameter, lebih banyak data, dan lebih banyak komputasi, dan performa meningkat dalam kurva yang bisa diandalkan. Bagi bidang yang menghabiskan puluhan tahun mencari trik cerdik, ini hampir terlalu bagus. Kamu tidak perlu gagasan baru setiap tahun. Kamu hanya perlu versi lebih besar dari gagasan yang sama. Transformer mengubah kecerdasan menjadi sesuatu yang, sampai taraf tertentu, bisa kamu beli.
Setiap model bahasa besar yang pernah kamu dengar — GPT, Claude, Gemini, Llama, DeepSeek, Qwen, dan lainnya — adalah Transformer, atau turunan dekatnya. Makalah 2017 itu adalah engsel tempat dunia modern berputar.
Era GPT dan lahirnya LLM modern (2018–2022)
Laboratorium muda bernama OpenAI mengambil taruhan hukum penskalaan lebih serius daripada hampir semua orang. Tesis mereka sederhana dan, saat itu, kontroversial: ambil sebuah Transformer, latih dengan teks internet dalam jumlah luar biasa untuk memprediksi kata berikutnya, buat sangat besar, lalu lihat apa yang terjadi.
Hasilnya datang dalam gelombang yang makin besar:
- GPT-1 (2018) membuktikan konsepnya dalam skala sederhana.
- GPT-2 (2019) cukup baik dalam menghasilkan paragraf yang koheren sehingga OpenAI awalnya ragu merilis model penuhnya, dengan alasan takut disalahgunakan — keputusan yang menghasilkan berita utama dan cukup banyak gelengan mata, tetapi juga menandakan bahwa sesuatu telah bergeser.
- GPT-3 (2020) adalah yang paling mengagetkan. Dengan 175 miliar parameter, ia bisa menulis esai, menjawab pertanyaan, menghasilkan kode yang berfungsi, dan meniru gaya — semuanya tanpa dilatih khusus untuk tugas-tugas itu. Ia mempelajarinya sebagai efek samping dari belajar memprediksi teks. Pengembang yang mendapat akses awal berbicara tentangnya seperti orang membicarakan trik sulap yang tidak bisa mereka jelaskan.
Sesuatu yang mendalam sedang terjadi di sini. Tidak ada yang memprogram GPT-3 untuk menulis puisi atau men-debug Python. Kemampuan itu muncul dari skala. Model itu hanya berusaha menebak kata berikutnya, dan dengan menjadi sangat baik dalam hal itu, ia menyerap perkiraan yang berfungsi tentang tata bahasa, fakta, penalaran, dan gaya. Sifat inilah — kemampuan yang muncul tanpa diminta seiring model tumbuh — disebut emergence, dan itulah sebabnya bahkan para peneliti yang membangun sistem ini rutin terkejut oleh apa yang bisa dilakukannya.
Pada 2022, model bahasa yang kuat sudah ada. Tetapi mereka hidup di balik API pengembang, berbicara dengan cara mentah dan kadang tak terkendali, dan hanya dikenal beberapa ribu penggemar. Masyarakat umum tidak tahu. Itu akan berubah dalam semalam.
ChatGPT: minggu ketika AI menjadi arus utama
Pada 30 November 2022, OpenAI merilis pratinjau riset gratis dari chatbot yang dibangun di atas model GPT-3.5. Mereka menyebutnya ChatGPT. Di internal, ekspektasinya sederhana.
Ia menjadi aplikasi konsumen dengan pertumbuhan tercepat dalam sejarah, mencapai seratus juta pengguna dalam sekitar dua bulan.
Teknologi di baliknya tidak sepenuhnya baru. Yang baru adalah pengemasannya: kotak obrolan sederhana, model yang disetel untuk mengikuti instruksi dan mengobrol, dan — yang krusial — tanpa hambatan masuk. Siapa pun bisa membuka situs web dan berbicara dengannya. Orang tuamu bisa memakainya. Anak-anakmu bisa memakainya. Dan bagi jutaan orang, percakapan pertama itu adalah momen ketika “AI” yang abstrak menjadi sesuatu yang konkret yang bisa menulis email mereka, menjelaskan pekerjaan rumah mereka, merencanakan perjalanan mereka, dan menyusun draf kode mereka.
Ledakan budayanya instan. Sekolah panik soal esai. Perusahaan bergegas menyusun “strategi AI.” Investor membuka buku cek mereka. Setiap eksekutif teknologi di planet ini tiba-tiba punya satu item di puncak agenda. ChatGPT tidak sekadar meluncurkan produk; ia meletuskan pistol start bagi persaingan korporat paling intens yang pernah dilihat industri teknologi sejak ponsel pintar — bisa dibilang sejak internet itu sendiri.
Dari sini, garis waktunya berhenti merangkak dan mulai mengabur.
Perlombaan senjata model tertutup (2023–2026)
Setelah ChatGPT membuktikan pasarnya, laboratorium terbesar dan paling banyak didanai di dunia pun berperang. Ini adalah model tertutup — sistem milik pribadi yang bobotnya dirahasiakan dan diakses lewat aplikasi serta API berbayar. Mereka berada di garis depan kemampuan mentah, dan persaingan di antara mereka tak pernah surut.
2023 menetapkan polanya. OpenAI merilis GPT-4, lompatan dramatis yang bisa bernalar, lulus ujian profesional, dan menangani gambar maupun teks. Anthropic — didirikan oleh mantan peneliti OpenAI — meluncurkan Claude, menekankan keamanan, dokumen panjang, dan gaya percakapan yang lebih matang. Google, yang terkejut oleh ChatGPT meski telah menemukan Transformer, menata ulang dan meluncurkan Gemini. Perlombaan tiga arah pun dimulai.
Lalu ia terus… meningkat. Setiap laboratorium melompati yang lain setiap beberapa bulan. Jendela konteks — seberapa banyak teks yang bisa dipertimbangkan model sekaligus — meledak dari beberapa ribu kata menjadi seluruh buku dan basis kode. Model memperoleh kemampuan melihat gambar, mendengar audio, menjelajahi web, dan memakai alat. xAI milik Elon Musk masuk dengan Grok, terhubung langsung ke platform sosial X.
Dua pergeseran mendefinisikan garis depan seperti keadaannya pada 2026, dan keduanya lebih penting daripada nama model mana pun:
Pertama, kebangkitan penalaran. Kelas baru model “berpikir” belajar menuntaskan masalah langkah demi langkah sebelum menjawab — berhenti sejenak untuk bernalar secara internal, bukan melontarkan respons pertama. Ini menutup banyak kesenjangan lama dalam matematika, logika, dan pengodean kompleks, dan mengubah benchmark yang membuat model 2023 kelimpungan menjadi kemenangan rutin.
Kedua, pergeseran dari chatbot ke pekerja. Tema penentu 2026 adalah AI agentik. Model terdepan tidak lagi sekadar menjawab pertanyaan — mereka mengambil tindakan. Mereka mengoperasikan komputer, menulis dan menerapkan kode di banyak berkas, menjalankan tugas bertahap yang berlangsung bermenit-menit hingga berjam-jam, dan tersambung ke sistem bisnis untuk benar-benar menyelesaikan pekerjaan. Metafora antarmuka diam-diam bergeser dari “asisten yang kamu ajak mengobrol” menjadi “rekan kerja yang kamu delegasikan tugas.”
Per pertengahan 2026, garis depan model tertutup adalah gugusan rapat di puncak: Claude Opus 4.8 dari Anthropic, GPT-5.5 dari OpenAI, Gemini 3.1 Pro dari Google, dan Grok 4.3 dari xAI, dengan empat lab itu saling bertukar posisi terdepan setiap beberapa pekan. <span>Hal paling mencolok dari lapisan teratas saat ini adalah betapa dekatnya jarak mereka — selisih antara “terbaik” dan “terbaik kedua” kini sering hanya pembulatan, dan posisinya terus berganti.</span>
Perlombaan ini juga menjadi geopolitik. Pada pertengahan 2026, satu model garis depan Anthropic menjadi — sejauh yang bisa diketahui siapa pun — yang pertama dimatikan lalu dinyalakan kembali oleh regulator, sempat ditangguhkan berdasarkan perintah kontrol ekspor Amerika Serikat sebelum aksesnya dipulihkan. AI garis depan bukan lagi sekadar kategori produk. Ia adalah instrumen kebijakan nasional.
Revolusi model terbuka: bobot untuk semua orang
Sementara para raksasa bertarung di balik API mereka, kisah paralel yang sama pentingnya sedang terbentang: kebangkitan model terbuka.
Titik baliknya datang pada awal 2023, ketika Meta merilis LLaMA, model bahasa cakap yang bobotnya bocor lalu dibagikan secara resmi kepada peneliti. Untuk pertama kalinya, model yang benar-benar kuat adalah sesuatu yang bisa kamu unduh, jalankan di perangkat kerasmu sendiri, periksa, dan ubah. Komunitas pengembang dan penggemar global meledak di sekitarnya, menghasilkan gelombang varian fine-tuning, optimasi, dan alat yang menakjubkan — sering lebih cepat daripada laboratorium besar merilis fitur.
Energi komunitas itu tidak pernah surut, dan pada 2026 ekosistem terbuka telah matang menjadi pesaing serius bagi garis depan tertutup. Beberapa hal yang perlu dipahami:
Bobot terbuka tidak sama dengan sumber terbuka. Perbedaan ini menjebak banyak orang. Sumber terbuka berarti kode pelatihan, data, dan bobot semuanya dirilis di bawah lisensi yang permisif. Bobot terbuka berarti kamu mendapat berkas model untuk diunduh dan dijalankan, tetapi lisensinya mungkin membatasi cara kamu memakainya, dan data pelatihan serta resep lengkapnya sering tetap privat. Sebagian besar model yang orang sebut “sumber terbuka” sebenarnya berbobot terbuka. Perbedaannya sangat penting bagi bisnis yang khawatir soal kepatuhan — itulah sebabnya lisensi menjadi fitur kompetitif yang nyata. Lisensi permisif Apache 2.0 dan MIT (dipakai keluarga seperti Qwen, DeepSeek, dan lainnya) sangat dihargai justru karena membiarkan perusahaan membangun dengan bebas.
Pusat gravitasi bergeser ke Timur. Beberapa model berbobot terbuka paling cakap pada 2026 berasal dari laboratorium Tiongkok: DeepSeek (terkenal karena penalaran sekelas garis depan dengan biaya yang mengejutkan murah), Qwen dari Alibaba (keluarga luas berlisensi permisif, dari model kecil untuk laptop hingga sistem raksasa), Kimi dari Moonshot, dan GLM dari Zhipu/Z.ai seri, sedangkan Llama 4 dari Meta menopang lapisan terbuka Barat, sementara Gemma model-modelnya dirancang untuk berjalan di satu GPU atau bahkan laptop, dan pemain Eropa Mistral mengalihkan model unggulannya ke lisensi permisif. Papan peringkat terbuka kini berubah hampir setiap bulan — snapshot terbaru menempatkan model seperti GLM-5.2 dan Kimi terbaru di atau dekat puncak peringkat terbuka independen, dengan beberapa model terbuka mulai masuk ke wilayah yang dulu hanya milik garis depan tertutup.
Keruntuhan harga. Mungkin kisah model terbuka yang paling berdampak adalah soal ekonomi. Persaingan — sebagian besar didorong penyedia terbuka dan berbiaya rendah ini — telah mendorong harga kecerdasan jatuh dari tebing. Kemampuan yang dua tahun lalu memakan biaya besar dalam tarif API kini tersedia seharga sen per juta kata, atau gratis kalau kamu hosting sendiri. Analis kini memperkirakan bobot terbuka terbaik hanya tertinggal dari model tertutup terbaik sekitar bulan pada banyak benchmark, bukan tahun. Untuk sebagian besar tugas dunia nyata, opsi terbuka kini cukup baik, cukup murah, dan cukup privat untuk menang.
Inilah revolusi senyap di bawah judul-judul berita. Garis depan menarik perhatian, tetapi komoditisasi AI “cukup baik” — berjalan di servermu sendiri, di bawah kendalimu sendiri, dengan biaya marginal mendekati nol — mungkin akan membentuk ulang lebih banyak industri daripada model unggulan mana pun.
Ketika AI belajar melihat dan melukis: kisah pembuatan gambar
Bahasa hanyalah separuh revolusi. Separuh lainnya bersifat visual — dan datang sama cepatnya.
Mesin awal untuk gambar AI adalah GAN (Generative Adversarial Network), diperkenalkan pada 2014. Gagasannya cerdik: adu dua jaringan, satu menghasilkan gambar palsu dan satu berusaha mengenali yang palsu, sampai generatornya begitu baik sehingga gambar palsunya meyakinkan. GAN menghasilkan wajah yang realistis secara mengerikan — era “orang-orang ini tidak ada” — tetapi sulit dilatih dan sulit dikendalikan dengan kata-kata.
Terobosan konsumen yang sesungguhnya datang dari teknik lain: model difusi, yang belajar membuat gambar dengan memulai dari derau murni lalu menyempurnakannya sedikit demi sedikit menjadi gambar yang koheren, dipandu prompt teks. Hasilnya, dan garis waktunya, luar biasa:
- DALL·E dan DALL·E 2 (2021–2022) dari OpenAI menunjukkan kepada dunia bahwa kamu bisa mengetik kalimat jenaka — “seorang astronot menunggang kuda dengan gaya fotorealistis” — dan mendapat gambar balik yang sangat bagus.
- Midjourney (2022) datang dengan estetika khas yang memukau dan membangun komunitas besar, hingga menjadi sebutan singkat untuk seni AI yang indah.
- Stable Diffusion (2022) melakukan untuk gambar apa yang nanti dilakukan LLaMA untuk teks: ia dirilis secara terbuka. Siapa pun bisa menjalankannya, melakukan fine-tuning, dan membangun di atasnya. Seluruh ekosistem terbuka berisi alat, plugin, dan model kustom meledak dalam semalam.
Dari sana, bidang ini berlari kencang. Mode kegagalan lama — tangan rusak, teks ngawur, wajah yang mengerikan — diatasi satu per satu. Pada 2026, pasar pembuatan gambar telah terbelah menjadi kubu yang jelas, dan kualitasnya cukup tinggi sehingga hasilnya rutin lolos pemeriksaan sekilas manusia:
- Midjourney (kini di lini V8) tetap favorit estetik untuk karya bergaya yang menghentikan gulir.
- GPT Image dari OpenAI model (penerus DALL·E, kini terpasang langsung di ChatGPT) unggul dalam mengikuti instruksi rumit dan menampilkan teks di dalam gambar dengan benar — masalah yang menghantui setiap model selama bertahun-tahun.
- FLUX dari Black Forest Labs menjadi juara bobot terbuka, menyamai model tertutup premium dalam fotorealisme dengan biaya sebagian kecilnya, dan menarik sebagian besar pengguna sumber terbuka serius dari versi Stable Diffusion yang lebih lama.
- Imagen dari Google dan “Nano Banana” model serta Firefly dari Adobe (dilatih dengan data berlisensi, yang disukai perusahaan karena keamanan hukumnya) melengkapi jajaran profesional.
- Dan, sejalan dengan kisah LLM, model Tiongkok seperti Seedream dari ByteDance melesat naik di peringkat.
Garis depan bukan lagi sekadar soal membuat gambar yang cantik. Ini soal mengedit — memilih area lewat percakapan dan meminta perubahan — dan soal konsistensi, menjaga karakter atau produk yang sama tetap identik di puluhan gambar. Pembuatan gambar AI berubah dari keisengan menjadi alat produksi profesional dalam sekitar empat tahun.
Ketika AI belajar bergerak: kebangkitan video AI
Kalau gambar adalah keajaiban empat tahun lalu, video adalah keajaiban era ini. Dan tidak ada yang menangkap begitu persis laju kemajuan AI selain menyaksikan text-to-video berubah dari bahan lelucon menjadi ancaman bagi industri film dalam waktu kurang dari tiga tahun.
Baru pada 2023, “video AI” berarti beberapa detik gerakan buram dan berkedip dengan wajah meleleh serta objek yang berubah jadi omong kosong antarframe. Itu keanehan, bukan alat.
Lalu, pada awal 2024, OpenAI mempratinjau Sora, dan percakapannya langsung berubah. Klipnya fotorealistis, koheren secara temporal, dan sinematik dengan cara yang terasa seperti melompati beberapa tahun kemajuan yang diperkirakan. Setiap pesaing langsung mulai mengejar standar itu.
Pengejaran itu menghasilkan medan yang luar biasa. Pada 2026, pesaing seriusnya meliputi Veo dari Google,, lini Gen-4 dari Runway (ditanamkan dalam lingkungan penyuntingan kreatif lengkap, bukan dijual sebagai model mentah), dan gelombang model Tiongkok yang kuat — Kling (Kuaishou), Seedance (ByteDance), dan lainnya — yang kini mendominasi puncak papan peringkat kualitas video independen. Standar teknisnya bergerak cepat: audio bawaan yang tersinkronisasi — termasuk dialog yang dihasilkan dengan lip-sync tepat dalam berbagai bahasa — berubah dari fiksi ilmiah menjadi fitur standar dalam sekitar satu tahun.
Kejutan yang tidak diperkirakan siapa pun: Sora, model yang memulai perlombaan itu, dimatikan. OpenAI menghentikan pengalaman web dan aplikasi Sora pada April 2026, disusul API-nya pada akhir tahun itu. Alat yang menentukan laju itu tersalip dan dipensiunkan sementara bidang yang ia ilhami melesat maju — simbol yang nyaris sempurna betapa brutal cepatnya ruang ini bergerak. Pasang standar, dan delapan belas bulan kemudian kamu mungkin sudah jadi benchmark warisan.
Hari ini, seorang solopreneur dengan prompt teks dan anggaran sederhana bisa menghasilkan rekaman yang dulu butuh lokasi, kru, dan anggaran puluhan ribu dolar. Teknologi ini masih punya batas nyata — gangguan fisika, konsistensi di adegan panjang, serta pertanyaan hukum dan etika serius seputar kemiripan dan pengungkapan — tetapi lintasannya tak terbantahkan.
Lebih dari teks dan piksel: suara, multimodalitas, dan era agen
Kategori rapi yang dipakai artikel ini — teks, gambar, video — sejujurnya sudah melebur. Arah penentu era sekarang adalah kemampuan-kemampuan ini bergabung menjadi sistem tunggal yang terpadu.
Multimodalitas adalah nama teknisnya. Model garis depan 2026 bukan model teks yang ditempeli fitur gambar; mereka secara bawaan melihat, membaca, mendengar, dan menghasilkan lintas format dalam satu alur berkelanjutan. Kamu bisa menunjukkan foto kulkasmu dan meminta resep, membagikan tangkapan layar bug dan mendapat perbaikannya, atau berbicara dengannya dan ia menjawab dengan suara alami yang bisa disela dan hampir tanpa jeda. Lingkaran lama yang canggung — “ketik, tunggu, baca” — mulai digantikan sesuatu yang terasa jauh lebih seperti berbicara dengan orang yang cakap.
Dan kemudian ada agen — tema yang menyatukan seluruh kisah 2026. Agen adalah sistem AI yang tidak sekadar merespons tetapi bertindak: ia merencanakan tugas bertahap, memakai alat dan perangkat lunak, memeriksa pekerjaannya sendiri, dan menuntaskan pekerjaan dengan sedikit mungkin arahan tangan. Memesan perjalanan, mencocokkan spreadsheet dengan tiga sumber data, merombak basis kode, menjalankan proyek riset di puluhan halaman web — semua ini bergerak dari “demo” menjadi “alur kerja harian.” Antarmukanya bergeser dari jendela obrolan menjadi antrean delegasi.
Inilah benang merah seluruh sejarah AI, yang sampai pada kesimpulan logisnya. Kita beralih dari pemrograman komputer dengan aturan eksplisit, ke melatih mereka dengan data, ke mengobrol dengan mereka dalam bahasa sehari-hari, ke — sekarang — mendelegasikan pekerjaan nyata kepada mereka. Setiap langkah menghapus satu lapisan hambatan antara niat manusia dan hasil yang sudah selesai. Agen adalah batas terdepan dari penghapusan itu saat ini.
Mengapa AI tiba-tiba bergerak begitu cepat?
Mundurlah sejenak dari nama model dan nomor versi, lalu muncul pertanyaan wajar: setelah lima puluh tahun merangkak, mengapa AI tiba-tiba berlari kencang? Sejumlah kekuatan bertemu, dan pertemuan itulah — bukan salah satunya saja — yang menyalakan sumbu.
Daya komputasi menjadi luar biasa kuat dan melimpah. GPU yang sama yang merender gim video ternyata sempurna untuk melatih jaringan saraf. Seiring chip membaik dan pusat data membesar, tenaga mentah yang tersedia untuk pelatihan AI tumbuh secara eksponensial. Ide-ide yang secara teori sudah benar pada 1990-an sama sekali tidak bisa dijalankan sampai perangkat kerasnya menyusul.
Data membanjir. Internet menghabiskan tiga puluh tahun mengumpulkan korpus teks, gambar, dan video manusia yang hampir tanpa batas. Catatan pengetahuan dan ekspresi manusia yang luas dan berantakan itu menjadi bahan pelatihannya. Tanpa internet, tidak ada AI modern.
Transformer membuka jalan bagi skala. Seperti yang sudah kita lihat, arsitektur 2017 itu memungkinkan perubahan yang andal dari lebih banyak komputasi dan lebih banyak data menjadi lebih banyak kemampuan. Keterprediksian itu mengubah riset menjadi sesuatu yang lebih mirip rekayasa — dan masalah rekayasa cepat terpecahkan ketika uang datang.
Uang pun datang. ChatGPT membuktikan ada pasar yang sangat besar, dan modal pun membanjir. Puluhan miliar dolar mengalir ke laboratorium, chip, dan talenta. Pendanaan itu memampatkan garis waktu yang seharusnya membentang puluhan tahun.
Persaingan sengit menentukan temponya. Dengan OpenAI, Google, Anthropic, Meta, xAI, dan belasan laboratorium Tiongkok semua berlomba, tak ada yang bisa melambat. Keunggulan yang butuh enam bulan untuk dibangun bisa menguap dalam enam minggu. Tekanan itulah sebabnya kamu melihat model unggulan baru hampir setiap kali membuka berita.
Ekosistem terbuka melipatgandakan upayanya. Setiap model yang dirilis terbuka mengubah ribuan pengembang independen menjadi tim R&D tanpa bayaran. Kecerdasan kolektif komunitas sumber terbuka global mempercepat kemajuan dengan cara yang tak bisa ditandingi satu perusahaan mana pun, dan menekan harga AI mendekati dasar.
Gabungkan semuanya dan kamu dapat kurva kemampuan paling tajam yang pernah dihasilkan teknologi. Ini bukan sekadar satu penemuan, melainkan lebih seperti reaksi berantai.
Ke mana AI pergi berikutnya
Memprediksi masa depan AI adalah cara hebat untuk terlihat bodoh enam bulan kemudian — artikel ini sudah mendokumentasikan betapa sering para ahli dikejutkan. Tapi lintasan saat ini menunjuk pada beberapa hal dengan keyakinan yang wajar.
Agen menjadi nyata. Fase berikutnya bukan lagi soal model yang tahu melainkan makin soal sistem yang secara andal lakukan melakukan lebih banyak — menyelesaikan pekerjaan panjang, rumit, dan bertahap dengan otonomi sungguhan. Framing “pekerja AI” akan makin menguat, bersama pertanyaan-pertanyaan sulit soal pengawasan, keandalan, dan apa yang terjadi pada pekerjaan yang dibangun di atas tugas yang kini bisa ditangani agen.
Kecerdasan makin murah. Keruntuhan harga belum selesai. Seiring model terbuka menutup celah dan efisiensi membaik, AI yang mumpuni cenderung hampir gratis dan berjalan secara lokal — di ponselmu, laptopmu, server milikmu sendiri. Komoditisasi itu bisa membentuk ulang seluruh industri dengan lebih senyap dan lebih menyeluruh daripada model mana pun yang jadi berita utama.
Garis-garisnya terus melebur. Teks, gambar, audio, dan video melebur menjadi sistem terpadu, dan “memakai AI” akan terasa bukan lagi seperti mengunjungi sebuah alat, melainkan seperti kemampuan yang terjalin tanpa terlihat dalam semua yang sudah kamu lakukan.
Tata kelola naik ke panggung utama. Penutupan sementara sebuah model terdepan oleh regulator pada 2026 adalah pratinjau. Saat AI menjadi infrastruktur kritis dan tuas kekuatan geopolitik, pertanyaan soal keamanan, hak cipta, kendali, dan strategi nasional akan membentuk bidang ini sama besarnya dengan terobosan riset mana pun. Perlombaan teknis dan perlombaan kebijakan kini menjadi perlombaan yang sama.
Satu prediksi yang aman adalah tempo ini tidak melambat. Setiap bab dalam sejarah ini ditulis oleh orang-orang yang dengan yakin meremehkan seberapa cepat bab berikutnya datang.
Pertanyaan yang sering diajukan
Kapan AI modern sebenarnya dimulai? Konsepnya sudah ada sejak 1950-an, tetapi era deep learning modern biasanya dilacak ke 2012, ketika jaringan saraf AlexNet mendominasi kompetisi pengenalan gambar dan membuktikan bahwa jaringan dalam ditambah data besar ditambah komputasi GPU adalah kombinasi yang menang. Ledakan di mata publik baru dimulai kemudian, dengan peluncuran ChatGPT pada November 2022.
Apa perbedaan antara model AI terbuka dan tertutup? Model tertutup (seperti GPT-5.5, Claude, dan Gemini) menyimpan bobotnya secara privat dan dipakai lewat aplikasi atau API berbayar. Model terbuka (seperti Llama, DeepSeek, Qwen, dan GLM) membagikan bobotnya sehingga siapa pun bisa mengunduh, menjalankan, dan memodifikasinya. Satu nuansa penting: “bobot terbuka” berarti kamu mendapat berkas modelnya, sedangkan “sumber terbuka” sejati juga mencakup kode dan data pelatihannya — sebagian besar model yang disebut sumber terbuka sebenarnya hanyalah bobot terbuka.
Apa terobosan terpenting dalam sejarah AI? Banyak peneliti menunjuk arsitektur Transformer 2017, yang diperkenalkan dalam makalah “Attention Is All You Need”. Arsitektur ini membuat model dapat diskalakan dan efisien untuk dilatih, dan menjadi fondasi hampir semua sistem AI besar yang dipakai saat ini, dari chatbot hingga pembuat gambar.
Bagaimana pembuatan gambar dan video AI bisa sebaik ini secepat ini? Pembuatan gambar melompat maju dengan model difusi sekitar 2021–2022 (DALL·E, Midjourney, Stable Diffusion), lalu cepat menyelesaikan masalah lama seperti tangan yang cacat dan teks yang tak terbaca. Video mengikuti kurva serupa, dari beberapa detik gerakan buram pada 2023 menjadi klip fotorealistis dengan audio tersinkron pada 2026, didorong persaingan sengit antarmodel seperti Veo, Runway, Kling, dan Seedance.
Apakah kemajuan AI akan melambat? Belum ada tandanya. Kombinasi komputasi melimpah, investasi besar, persaingan sengit antarlaboratorium, dan komunitas sumber terbuka yang berkembang pesat terus mendorong tempo. Jika sejarah di atas mengajarkan sesuatu, itu adalah bahwa gelombang berikutnya selalu datang lebih cepat dari yang diperkirakan siapa pun.


