Français
 English
 Deutsch
 Español
 Italiano

L'état des lieux de l'IA en 2026 se résume à trois événements survenus au cours des huit premiers mois de l'année — et presque personne ne les a mentionnés dans la même phrase.
Un modèle a franchi le seuil 96% sur SWE-bench. Vérifié. Il ne s'agit pas du 96% sur un benchmark fictif, mais bien du 96% appliqué à de véritables tickets GitHub issus de Django, Flask et scikit-learn : ce benchmark, qui devait initialement prendre des années, est désormais pratiquement achevé en tant que discriminateur, et les trois modèles en tête se distinguent par un écart inférieur à un point de pourcentage.
Les meilleures données disponibles permettant de déterminer si les outils de codage basés sur l'IA permettent aux développeurs expérimentés de gagner en rapidité indiquent toujours que ce n'est pas le cas. L'essai contrôlé randomisé mené par METR a mis en évidence un ralentissement de 19%. Leur tentative de le reproduire en 2026 a échoué, car les développeurs ont refusé de travailler sans IA, même à un rythme de $50 par heure. Les utilisateurs de ces outils estiment qu'ils sont trois fois plus rapides. Or, d'après les mesures effectuées, ce n'est pas le cas.
Et Microsoft a intégré un modèle de raisonnement comptant 14 milliards de paramètres directement dans Windows, une phrase qui aurait relevé de la science-fiction en 2024 et qui n'est aujourd'hui qu'une note de bas de page dans un discours d'ouverture de la conférence Build.
Ces trois faits constituent l'ensemble État des lieux de l'IA en 2026 en miniature. Les modèles se sont révélés extraordinaires. Mais les gains de productivité escomptés ne se sont pas concrétisés. Et la frontière de l’innovation s’est discrètement déplacée du centre de données vers l’appareil que tu tiens entre tes mains.
Voici la version détaillée du rapport « État des lieux de l’IA en 2026 ». Elle s’adresse aux personnes amenées à prendre des décisions ayant des implications financières : quel modèle choisir, faut-il laisser les agents écrire du code de production, quoi acheter, et que dire à un client ou à un délégué à la protection des données ? J’ai fait la distinction entre ce qui a été commercialisé, ce qui a été annoncé et ce qui relève de la rumeur, car l’erreur la plus coûteuse dans ce domaine est de baser sa planification sur un modèle qui n’existe pas encore.
Dernière mise à jour le 3 septembre 2026. Il faudra la mettre à jour à nouveau d'ici Noël.
En bref — L'état des lieux de l'IA en 2026 en 90 secondes
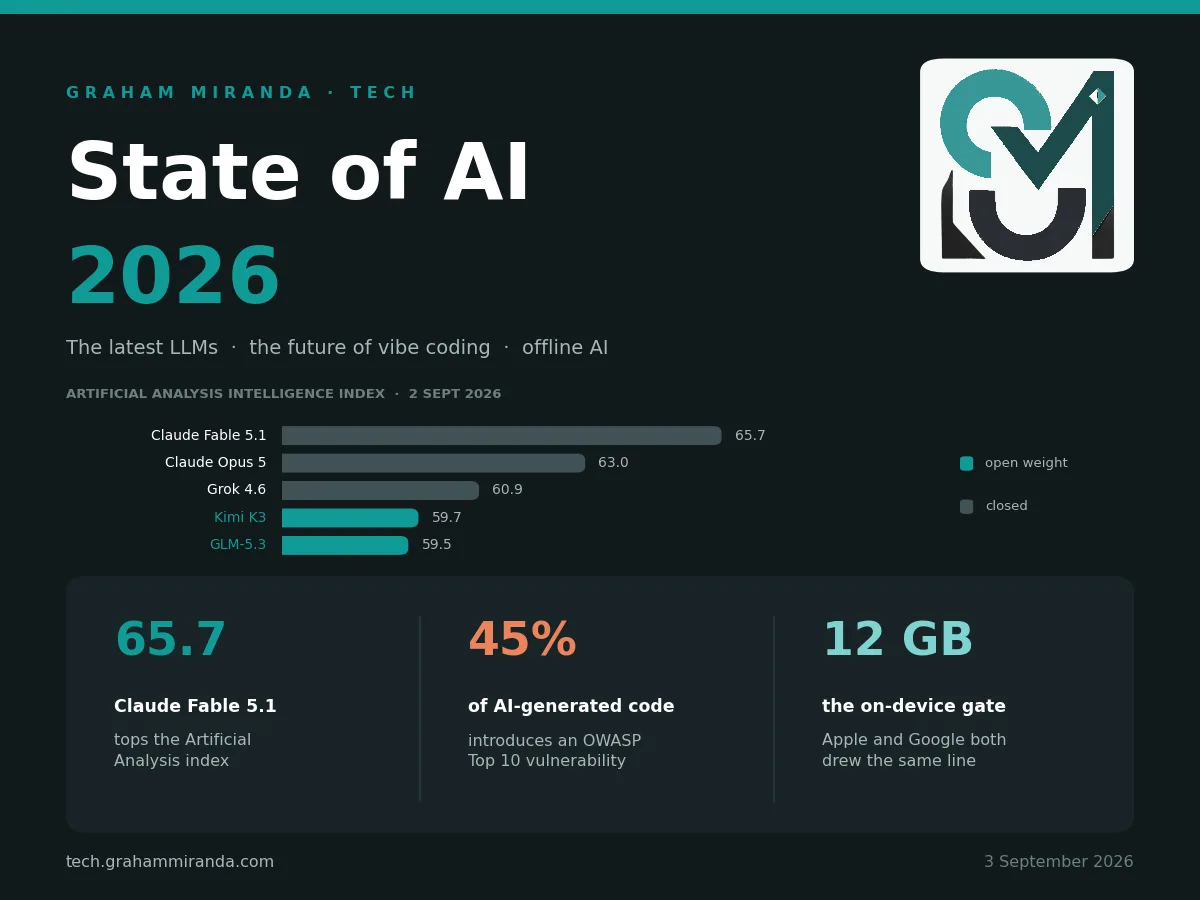
La course fait l'objet d'une lutte à quatre, et Anthropic est actuellement en tête au classement général. Au 2 septembre 2026, l’indice d’intelligence v4.1.1 d’Artificial Analysis attribue à Claude Fable 5.1 un score de 65,7, à Claude Opus 5 un score de 63,0, Grok 4.6 à 60,9 et GPT-5.6 Sol à 58,9. Mais cette moyenne masque l’aspect le plus intéressant : GPT-5.6 Sol devance BrowseComp avec un score de 90,41 TP3T, Gemini 3.8 Flash affiche 58,7 à $0,75 par million de jetons d’entrée, et les dix meilleurs modèles ne se répartissent que sur 8,2 points — un écart suffisamment faible pour que des différences au niveau de l’architecture et des prompts puissent faire gagner ou perdre plusieurs places à un modèle.
Les poids ouverts ont environ une génération de retard, mais ils rattrapent leur retard. GLM-5.3 (753B, en version ouverte) affiche un score de 59,5 — sixième au classement général, devant GPT-5.6 Sol. DeepSeek V4 Pro est distribué avec 1 600 milliards de paramètres sous une licence MIT authentique. Ornith-1.5-397B a atteint 86 sur SWE-bench Verified et a devancé de justesse Claude Opus 4.8 sur Terminal-Bench 2.1, avec un score de 86,1 contre 85,0. Le retard en termes de capacités est désormais d'environ six mois. C'est le retard en matière de licences qui est déterminant.
“Le ” Vibe coding » a remporté le débat sur l'adoption, mais a perdu celui sur les preuves. 90% de développeurs utilisent au moins un outil de codage basé sur l'IA dans le cadre de leur travail. Le marché des agents de codage d’entreprise représente environ $10 milliards en chiffre d’affaires annualisé. Et la confiance des développeurs dans les résultats générés par l’IA est passée de 40% à 29% en deux ans. Ces outils sont universels, et les personnes qui les utilisent leur font de moins en moins confiance chaque année. Ces deux constatations sont tout à fait rationnelles.
La facture de sécurité est arrivée et elle est détaillée. Veracode a constaté que 45% d'exemples de code générés par l'IA présentaient une vulnérabilité figurant dans le Top 10 de l'OWASP. Apiiro a mesuré que les développeurs assistés par l'IA effectuaient leurs commits trois à quatre fois plus rapidement et identifiaient les failles de sécurité dix fois plus vite. Environ 20% de code généré par l’IA fait référence à des paquets qui n’existent pas. Ce n’est pas un argument contre ces outils. C’est une question de savoir où placer la barrière.
Cette année, l'IA hors ligne est devenue véritablement utile, sur du matériel que les utilisateurs possèdent déjà. Un modèle de 2 milliards de paramètres fonctionne à une vitesse de 61 tokens par seconde sur un iPhone. Microsoft a intégré à Windows un moteur de raisonnement de 14 milliards de paramètres, qui nécessite une NPU d’une puissance de 40 TOPS. Google réserve son meilleur modèle embarqué aux appareils dotés de 12 Go de RAM, tout comme Apple. C'est la mémoire, et non la puissance de calcul, qui détermine ce que tu peux exécuter hors ligne, et c'est justement la mémoire qui vient à manquer.
Une phrase qui résume avec honnêteté l'état de l'IA en 2026 : C'est cette année-là que les modèles ont cessé d'être le goulot d'étranglement. C'est la vérification qui est devenue le goulot d'étranglement. Chaque décision importante évoquée dans cet article — quel modèle, quel harnais, quel appareil, quelle porte — découle de ce seul changement.
Comparaison rapide : The Frontier, septembre 2026
L'indice « Artificial Analysis Intelligence » v4.1.1 regroupe neuf évaluations : GDPval-AA v2, τ³-Banking, Terminal-Bench v2.1, SciCode, Humanity’s Last Exam, GPQA Diamond, CritPt, AA-Omniscience et AA-LCR. Les scores ci-dessous correspondent à un instantané du 2 septembre 2026.
| Modèle | Laboratoire | Index AA | Poids | Entrées / Sorties par 1M |
|---|---|---|---|---|
| Claude Fable 5.1 | Anthropique | 65.7 | Fermé | $10.00 / $50.00 |
| Claude, opus 5 | Anthropique | 63.0 | Fermé | $5.00 / $25.00 |
| Claude Fable 5 | Anthropique | 62.1 | Fermé | $10.00 / $50.00 |
| Grok 4.6 | xAI | 60.9 | Fermé | — |
| Kimi K3 | Moonshot | 59.7 | Poids libre | — |
| GLM-5.3 | Z.ai | 59.5 | Poids libre | $1.40 / $4.40 |
| GPT-5.6 Sol | OpenAI | 58.9 | Fermé | $5.00 / $30.00 |
| Gemini 3.8 Flash | 58.7 | Fermé | $0.75 / $3.75 | |
| Aperçu de Qwen 3.8 Max | Alibaba | 58.1 | Fermé | — |
| GLM-5.3-Flash | Z.ai | 57.5 | Poids libre | $0.15 / $0.47 |
| Claude Opus 4.8 | Anthropique | 57.3 | Fermé | $5.00 / $25.00 |
| Muse Spark 1.2 | Méta | 56.8 | Fermé | — |
| GPT-5.5 | OpenAI | 56.3 | Fermé | — |
Lisez la quatrième colonne avant la troisième. Deux des dix meilleurs modèles proposent des poids téléchargeables, et l'un d'entre eux coûte $0,15 par million de jetons d'entrée.
Comparaison rapide : la catégorie « Open-Weight »
| Modèle | Total / Actifs | Contexte | Licence | Publié |
|---|---|---|---|---|
| Kimi K3 | 2,8 T / 104 milliards | 1 million | Par tranche de chiffre d'affaires (personnalisé) | juillet 2026 |
| Qwen3.8-2.4T-A95B | 2,4 T / 95 B | 262 000 (1 million via YaRN) | Apache 2.0 | 14 août 2026 |
| DeepSeek V4 Pro | 1,6 T / 49 B | 1 million | MIT | 12 août 2026 |
| GLM-5.3 | 753B / ~40B | 1 million | Personnalisé (grille $10B) | août 2026 |
| MiniMax M3 | 428B / 23B | 1 million | Personnalisé (mention de source) | 1er juin 2026 |
| Ornith-1.5-397B | 397B Ministère de l'Éducation | 262 000 (1 million via YaRN) | MIT | août 2026 |
| Gemma 4 31B | 31B dense | 256 Ko | Apache 2.0 | 6 avril 2026 |
| Qwen3.8-27B | 27B dense | 262 000 | Apache 2.0 | 14 août 2026 |
| Gemma 4 E4B | ~8 milliards | 128 K | Apache 2.0 | 6 avril 2026 |
Trois de ces neuf sont véritablement « OSI-clean ». C'est là la véritable histoire des catégories de poids ouvertes en 2026, et j'y reviendrai dans la troisième partie.
ACTE I — LES MANNEQUINS
Première partie : Ce qui a réellement été commercialisé en 2026
Avant toute discussion, voyons d'abord les comptes. Je classe cela en trois catégories, car c'est précisément dans ces différences que l'argent est gaspillé.
Commande validée et en cours d'expédition
- 6 avril 2026 — Google lance Gemma 4 sous licence Apache 2.0, ce qui marque un changement par rapport aux conditions spécifiques de Gemma 3. Quatre variantes : 31 milliards de mots denses, 26 milliards avec 4 milliards de mots actifs (MoE), E4B à environ 8 milliards, et E2B à 5,1 milliards au total avec 2,3 milliards de mots actifs. Contexte de 256K pour les grands modèles, 128K pour la série E. Tous prennent en charge les entrées texte, image et vidéo ; les modèles E2B et E4B ajoutent la prise en charge native de l’audio.
- 1er juin 2026 — MiniMax M3. 428 milliards au total / 23 milliards actifs, 1 million de contextes, multimodalité native, un nouvel opérateur d’attention clairsemée, poids disponibles sur Hugging Face. Ce sujet est abordé en détail dans mon article précédent sur le matériel d'IA local.
- 2 juin 2026 — Microsoft annonce Aion 1.0 lors de la conférence Build. Une famille de modèles intégrés directement dans Windows 11 : Aion 1.0 Instruct (compatible avec le processeur, disponible dans Edge Canary à partir de la version 150.0.4070) et Aion 1.0 Plan, un modèle de raisonnement et d’appel d’outils comptant 14 milliards de paramètres et doté d’une fenêtre de contexte de 32 Ko.
- 9 juin 2026 — Claude Fable 5. Le modèle haut de gamme d'Anthropic : $10/$50 par million, contexte de 1 million, sortie maximale de 128K.
- 9 juillet 2026 — OpenAI lance GPT-5.6 en trois versions : Sol ($5/$30), Terra ($2,50/$15) et Luna ($1/$6). La fonctionnalité cyber est intégrée à Sol plutôt que vendue sous forme de modèle distinct, avec un accès amélioré via le programme « Trusted Access for Cyber » d’OpenAI.
- Juillet 2026 — Moonshot dévoile les poids de la Kimi K3. 2 800 milliards de paramètres, 1 million de contextes, MXFP4 natif, sous licence à plusieurs niveaux en fonction du chiffre d'affaires.
- 24 juillet 2026 — Claude Opus 5. $5/$25, inchangé par rapport à Opus 4.8. Anthropic affirme qu’il “ double largement les performances d’Opus 4.8 ’ sur Frontier-Bench v0.1 et obtient un score trois fois supérieur à celui du deuxième meilleur modèle sur ARC-AGI 3.
- 12 août 2026 — DeepSeek V4 Pro sort de la phase de préversion avec des poids sous licence MIT : 1,6 T au total (certaines sources arrondissent ce chiffre à 1,7 T), 49 milliards de poids actifs, 1 million de poids de contexte, 893 Go de tenseurs BF16 et FP8, ainsi qu’un module de décodage spéculatif DSpark. Terminal-Bench 2.1 à 87,9, HLE-with-tools à 60,0, CyberGym à 83,3. DeepSeek a augmenté les tarifs de son API au même moment.
- 14 août 2026 — Qwen 3.8, toutes catégories de poids sous licence Apache 2.0 : un modèle multimodal dense de 27 milliards de paramètres et un modèle géant de 2,4 T-A95B, tous deux disponibles sur Hugging Face et ModelScope, avec un contexte natif de 262 000 éléments extensible à 1 million grâce à YaRN.
- Août 2026 — Coefficients de pondération GLM-5.3 publié sur Hugging Face environ deux semaines après le lancement de l'API. 753 milliards de MoE, 1 million de contextes, 128 000 sorties, BF16 et FP8.
- Août 2026 — Ornith-1.5. Trois modèles (397B MoE, 35B MoE avec 3B actifs, 9B denses), développés à partir de Qwen3.5 et Gemma 4 avec un pré-entraînement continu, sous licence MIT, et affichant un score de 86 sur SWE-bench Verified.
- 1er septembre 2026 — Claude Fable 5.1 et Mythos 5.1. Mode « Adaptive Thinking » activé par défaut, contexte de 1 M, sortie de 128 K. Tarification de base inchangée à 1 TP 4 T 10/1 TP 4 T 50, mais les lectures en cache baissent de 751 TP 3 T, passant de 1 TP 4 T 1,00 à 1 TP 4 T 0,25 par million.
- 2 septembre 2026 — Gemini 3.8 Flash à $0,75/$3,75, contexte d'entrée de 1 Mo, sortie de 66 Ko, date de mise à jour des connaissances : mars 2026, avec des données d'entrée sous forme de texte, d'images, de vidéos, de fichiers audio et de PDF.
- 2 septembre 2026 — Meta commercialise le Muse Spark 1.3 et l'interface en ligne de commande de Muse Code.
Signalé, crédible, non confirmé
- Meta rendra “ prochainement ” publics les paramètres de Muse Spark.” Il s'agit de Mark Zuckerberg sur X, sans date, sans nombre de paramètres, sans détails sur l'architecture et sans texte de licence. Meta n'a communiqué aucune information sur la taille du modèle, quelle que soit la version.
- Gemini Nano v4 est annoncé pour Android, Nano v3 étant pour l'instant réservé à la gamme Pixel 10.
- Plan Aion 1.0 sera disponible “ dans les prochains mois ” ; seul Instruct est actuellement en version préliminaire.
Rumeur, source unique, à prendre avec des pincettes
- Tout ce que tu as lu sur le prochain produit phare d'Anthropic, d'OpenAI ou de Google. Sur un marché où quatre laboratoires ont lancé un modèle classé parmi les dix meilleurs en l'espace de neuf semaines, les rumeurs ont une demi-vie d'environ deux semaines.
Il y a encore un point qui mérite d'être souligné, car c'est une nouveauté dont presque personne ne parle en dehors du milieu de la sécurité. Claude Mythos 5.1 obtient un score de 60,9 sur Terminal-Bench 4.0 — supérieur aux 55,8 de Fable 5.1 — et de 95,51 TP3T sur SWE-bench Verified. Il n'est pas disponible à la vente.
Anthropic décrit Mythos comme son “ modèle le plus performant pour la recherche en cybersécurité et en biologie ”, et celui-ci n’est accessible qu’aux cyberdéfenseurs et aux chercheurs en sciences de la vie ayant fait l’objet d’une vérification préalable, par le biais de deux programmes d’accès sécurisé : le “ Cyber Verification Program ” et le « Life Sciences Verification Program ». Selon les propres termes d’Anthropic, l’entreprise « ne peut le mettre à la disposition que d’un ensemble d’organisations américaines, bien que nous nous efforcions d’élargir l’accès ». Le projet Glasswing, qui vise à élargir cet accès, avait atteint environ 150 organisations dans plus de quinze pays à compter de juin 2026.
Le raisonnement repose sur le principe du « double usage » : un modèle particulièrement efficace pour détecter des vulnérabilités l'est tout autant pour les deux camps, et je pense que cela se justifie. Mais il faut noter la conséquence structurelle, car elle est véritablement nouvelle : Le modèle qui obtient les meilleurs résultats dans un benchmark public de programmation est désormais inaccessible à la plupart des gens dans le monde, quel que soit le prix. Les restrictions d'accès fondées sur des motifs de sécurité plutôt que sur des considérations commerciales vont se généraliser, et non au contraire, et si tu résides en dehors des États-Unis, c'est là un argument pour s'intéresser aux poids ouverts qui n'a rien à voir avec les coûts.
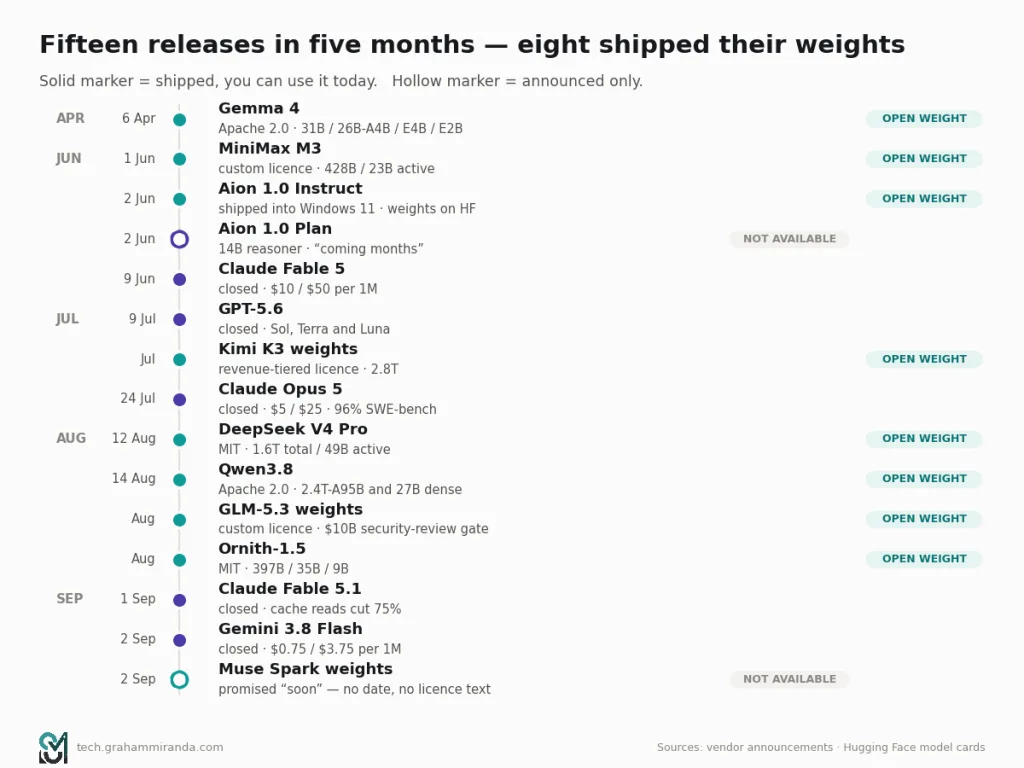
Afficher l'image Neuf mois, douze versions majeures, dont quatre en « open weight ». Les barres pleines correspondent à des versions déjà disponibles ou à un accès API que tu peux acheter dès aujourd’hui ; les contours en pointillés indiquent des versions annoncées mais non encore disponibles.
Deuxième partie : Qu'est-ce qui distingue réellement les modèles Frontier aujourd'hui ?
Voici la vérité dérangeante concernant le haut de ce classement : Pour la plupart des tâches que tu auras à effectuer, les huit meilleurs modèles sont en réalité interchangeables.
Je ne dis pas cela pour faire le contre-courant. Je le dis parce que l'écart global entre l'indice Claude Fable 5.1, à 65,7, et l'indice GLM-5.3-Flash, à 57,5, est de huit points, et que le GLM-5.3-Flash coûte $0,15 par million de jetons d’entrée, contre $10,00 pour le Fable. Cela représente un Une différence de prix de 67 fois pour une différence de performances de 12% sur un score composite, et les notes composites minimisent justement les différences qui comptent pour toi tout en amplifiant celles qui n'ont pas d'importance.
La question pertinente n'est donc pas “ quel est le meilleur modèle ? ”, mais “ en quoi chacun d'entre eux excelle-t-il réellement, et cela correspond-il à mon emploi du temps hebdomadaire ? ”.”
Les quatre éléments qui se distinguent véritablement
1. Fiabilité agentique à long terme. C’est là le véritable facteur de différenciation pour 2026, et il est très mal mesuré. Opus 5 d’Anthropic est explicitement présenté comme “ une amélioration radicale pour la gamme Opus qui alimente les agents fonctionnant sur le long terme ” — non pas comme un modèle plus intelligent, mais comme un modèle qui ne tombe pas en panne au bout de six heures. Les preuves de ce type d’amélioration se trouvent dans les benchmarks d’agentique (Terminal-Bench, OSWorld, Frontier-Bench) plutôt que dans les benchmarks de connaissances, et ces benchmarks sont récents, bruyants et sensibles à la structure d’apprentissage.
2. L'économie de la mémoire cache. Le changement le plus marquant de Fable 5.1 n'était pas une avancée en termes de performances. Il s’agissait de réduire les lectures de cache de 751 TP3T, passant de 1 TP4T1,00 à 1 TP4T0,25 par million de jetons — ce qui, selon MarkTechPost, représente une réduction des coûts d’environ 251 TP3T pour les flux de travail classiques et pouvant atteindre 451 TP3T pour les flux de travail ’ agentic ». Pour tout agent qui relit à chaque tour une invite système volumineuse ou une base de code importante, le coût de la mise en cache a une incidence plus importante sur ta facture mensuelle que le choix du modèle. Personne ne met ça dans un classement.
3. Navigation et utilisation des outils. GPT-5.6 Sol obtient un score de 90,4 % sur BrowseComp — et de 92,2 % avec le paramètre de raisonnement « Ultra ». Il s'agit là d'un point fort spécifique et avéré, et si ta charge de travail relève davantage de la recherche et de la synthèse que du codage et de la vérification, cela vaut plus de deux points d'indice global.
4. Prix par réponse satisfaisante. Le Gemini 3.8 Flash, avec un indice de 58,7 pour une configuration $0,75, est le produit dont la valorisation est manifestement la plus erronée du tableau par rapport à la frontière fermée. Le GLM-5.3-Flash, avec un indice de 57,5 pour une configuration $0,15, est tout simplement le produit dont la valorisation est manifestement la plus erronée, point final.
Le tableau des tarifs, car c'est lui qui détermine réellement la décision
| Modèle | Entrée /1M | Sortie /1M | Données mises en cache /1M | Contexte |
|---|---|---|---|---|
| Claude Fable 5.1 | $10.00 | $50.00 | $0.25 | 1 Mo / 128 Ko en sortie |
| Claude, opus 5 | $5.00 | $25.00 | — | 1 Mo / 128 Ko en sortie |
| GPT-5.6 Sol | $5.00 | $30.00 | — | — |
| GPT-5.6 Terra | $2.50 | $15.00 | — | — |
| Claude Sonnet 5 | $2.00 | $10.00 | — | 1 Mo / 128 Ko en sortie |
| GLM-5.3 | $1.40 | $4.40 | — | 1 Mo / 128 Ko en sortie |
| GPT-5.6 Luna | $1.00 | $6.00 | — | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | — | 1 million / 66 000 sortis |
| GLM-5.3-Flash | $0.15 | $0.47 | — | — |
| MiniMax M3 | $0.30 | $1.20 | — | 1 million |
| Muse Spark (Contributeurs) | $0.10 | $0.20 | $0.002 | — |
Cette dernière ligne mérite qu'on s'y attarde un peu plus. Le niveau « Contributeurs » de Meta correspond à $0.10 en entrée et $0.20 en sortie — avec un accès potentiel à tes données à des fins d’entraînement. Ce n'est pas un prix, c'est un échange. C'est aussi, pour autant que je puisse en juger, l'expression la plus honnête du véritable modèle économique qui se cache derrière bien des déductions simplistes, et je préfère que cela soit clairement indiqué dans un tableau tarifaire plutôt que dissimulé dans un accord de traitement des données (DPA).
Afficher l'image L'intelligence sur un axe, le prix sur une échelle logarithmique sur l'autre. Huit points d'indice séparent le haut du graphique du bas ; les prix sont séparés par un facteur de 67×. La frontière d'efficacité se trouve en bas à droite, et presque personne n'achète à cet endroit.
La rupture d'API dont personne ne t'a prévenu
La version 5.1 de Fable comporte trois changements majeurs : l'utilisation forcée des outils a été supprimée, les blocs de réflexion sont désormais spécifiques à chaque modèle, et les modifications apportées en cours de conversation aux messages système ou aux outils génèrent désormais des erreurs au lieu d'être acceptées sans avertissement.
Ce troisième point va poser problème. Un grand nombre de harnais d’agents modifient l’invite du système ou la liste d’outils entre deux tours : ils ajoutent un outil au début d’une sous-tâche ou raccourcissent les instructions pour économiser du contexte. Dans Fable 5.1, cela génère désormais une erreur. Si tu mets à jour l’ID d’un modèle dans un fichier de configuration et que ton agent commence à renvoyer des codes d’erreur 400 au quatrième tour, c’est pour cette raison.
La leçon générale, qui vaut plus que la leçon particulière : En 2026, la mise à jour d'un modèle consistera en une migration d'API. Écris les identifiants de tes modèles de manière à ce que le remplacement de l'un d'entre eux ne nécessite qu'une seule ligne de code, puis verrouille-les. Tu devras effectuer cette modification à nouveau d'ici un trimestre.
Troisième partie : La frontière du poids libre et le piège de la licence
C'est la partie de l'histoire de 2026 qui me passionne vraiment, mais c'est aussi celle où le marketing est le plus trompeur.
L'écart de capacités est d'environ six mois
Découvrez les résultats obtenus par la catégorie « poids libres » entre juin et août 2026 :
- DeepSeek V4 Pro: 1,6 T au total, 49 milliards actifs, licence MIT, score Terminal-Bench de 2,1 à 87,9. Ce score Terminal-Bench est supérieur à celui de la plupart des modèles fermés publiés cette année.
- Ornith-1.5-397B: 86 sur SWE-bench (vérifié), 86,1 sur Terminal-Bench 2.1 (contre 85,0 pour Claude Opus 4.8) et 92,8 sur GPQA Diamond. Sous licence MIT, 262 Ko de contexte natif extensible à environ 1 Mo avec YaRN. Construit sur la base de Qwen 3.5 et Gemma 4 avec pré-entraînement et post-entraînement continus.
- GLM-5.3: sixième de l'indice « Artificial Analysis » avec un score de 59,5, devant le GPT-5.6 Sol.
- Qwen 3.8: un modèle de 2 400 milliards de paramètres sous licence Apache 2.0, ainsi qu'un modèle multimodal dense de 27 milliards de paramètres qui, selon Alibaba, surpasse le Qwen3.7-Plus, pourtant plus volumineux, dans les tâches de codage et de bureautique.
Il y a six mois, on disait en toute honnêteté que “ les systèmes à poids ouverts ont une génération de retard et sont moins chers ”. Ce point de vue est désormais erroné. Le point de vue correct est le suivant : En ce qui concerne plus particulièrement le codage et les tâches agentiques, les meilleurs modèles à poids ouverts se situent dans les limites des marges d’erreur de la frontière fermée de la dernière génération, et leur coût est de 10 à 60 fois inférieur.
Ornith-1.5 est le modèle le plus intéressant de l'année, et pourtant presque personne n'en a entendu parler
Je voudrais m'attarder sur ce point, car il s'agit d'une véritable innovation et non d'un simple résultat d'extrapolation.
Ornith décrit la version 1.5 comme étendant “ l’auto-échafaudage à une boucle d’auto-amélioration de bout en bout ”. En termes simples : le système propose ses propres nouvelles tâches d’entraînement, génère pour celles-ci des échafaudages spécifiques, produit des déploiements de solutions et optimise ces trois éléments conjointement grâce au GRPO. Des modèles plus performants lui permettent de proposer des tâches plus difficiles ; de meilleurs échafaudages permettent de découvrir de meilleures stratégies ; de meilleurs résultats fournissent un signal d’apprentissage plus clair.
Il a été entraîné à partir de Qwen 3.5 et de Gemma 4 — c'est-à-dire à partir de poids ouverts développés par d'autres — et il surpasse Claude Opus 4.8 sur Terminal-Bench 2.1, tout en comptant 397 milliards de paramètres et en étant sous licence MIT.
Si cette boucle se généralise, il s'agit du résultat le plus important de cet article., car cela signifie que l’écosystème ouvert peut s’améliorer sans qu’aucun laboratoire n’ait à dépenser des sommes colossales pour un cycle de pré-entraînement. Si la généralisation ne se fait pas — si ce à quoi nous assistons n’est qu’un surapprentissage spécifique à un benchmark issu d’un programme d’apprentissage auto-généré —, alors cela constitue un avertissement concernant exactement la même chose. Je ne sais pas de quoi il s’agit. Et, pour autant que je sache, personne en dehors d’Ornith ne le sait non plus. Ce que j’aimerais voir avant de parier là-dessus : une évaluation indépendante sur des tâches qui ne font pas partie de l’environnement du programme d’apprentissage auto-généré, et une référence humaine non utilisée lors de l’entraînement. Aucune de ces deux choses n’existe encore.
Parlons maintenant des licences, car le “ logiciel libre ” est à l'origine de nombreuses pratiques malhonnêtes
Voici ce que ces poids te coûtent réellement en termes d'obligations :
| Modèle | Licence | Le hic |
|---|---|---|
| DeepSeek V4 Pro | MIT | Aucun. Véritablement open source. |
| Qwen 3.8 | Apache 2.0 | Aucun. Véritablement open source. |
| Gemma 4 | Apache 2.0 | Aucune — et une réelle amélioration par rapport aux conditions sur mesure de Gemma 3. |
| Ornith-1.5 | MIT | Non indiqué. Vérifie toi-même la fiche technique avant l'expédition. |
| GLM-5.3 | Personnalisé | Entreprises de plus de Chiffre d'affaires annuel de $10B doit réussir l'examen de Z.ai examen de sécurité avant toute utilisation commerciale. Z.ai a déménagé loin du MIT pour cette version. |
| Kimi K3 | Personnalisé | Barème basé sur le chiffre d'affaires ; attribution claire requise pour les prestataires à fort volume. |
| MiniMax M3 | Personnalisé | Toute utilisation commerciale nécessite la mention bien visible “ Conçu avec MiniMax M3 ” ; une autorisation écrite distincte est requise, comme indiqué ci-dessus. $20M chiffre d'affaires annuel. |
| Muse Spark | Inconnu | Annoncé comme “ à venir ”. Il n'existe aucun texte de licence. |
Trois remarques. J'ai examiné en détail les clauses en petits caractères des trois premières d'entre elles dans Kimi K3 vs Fable 5.1 vs GLM-5.3, je vais donc m'en tenir ici à ce qui a changé depuis.
Tout d'abord, ces passerelles s'adressent aux hyperscalers, pas à toi. Un seuil de chiffre d'affaires de $10 milliards exclut pratiquement tous les lecteurs de cet article. Si tu es une PME allemande, une agence, un cabinet de conseil ou un développeur indépendant, la réponse concrète concernant GLM-5.3 et Kimi K3 est la suivante : tu n'as rien à craindre.
Deuxièmement, “ tu n'as rien à craindre ” n'est pas la même chose que “ ton analyse juridique est correcte ”. Une licence sur mesure, c'est quand quelqu'un te facture pour la lire. Une licence MIT ou Apache 2.0 signifie que quelqu’un la lit en quatre-vingt-dix secondes et passe à autre chose. Pour les achats d’entreprise, cette différence vaut plus de quatre points de référence, et c’est l’argument le plus convaincant en faveur de DeepSeek V4 Pro et Qwen3.8 par rapport à GLM-5.3 dans un produit commercial.
Troisièmement, surveillez le sens de la marche. Z.ai est passé d’une licence MIT pour GLM-5.2 à une licence propriétaire assortie d’un contrôle de sécurité pour GLM-5.3. DeepSeek a suivi le chemin inverse : l’entreprise a conservé la licence MIT tout en augmentant les tarifs de son API — ce qui constitue une stratégie cohérente : faire payer la commodité, fournir gratuitement les poids et laisser les fournisseurs de services d’inférence se faire concurrence sur la qualité du service. Les « poids ouverts » ne constituent pas un mouvement. Il s'agit d'une stratégie commerciale, et ces stratégies évoluent à chaque nouvelle version. Ne concevez pas une architecture de produit en partant du principe que la version de l'année prochaine utilisera la licence de cette année.
Le terme “ open source ” devrait être abandonné pour les modèles
Aucune de ces licences n'est open source au sens où l'entend l'OSI, à l'exception des licences MIT et Apache 2.0 — et même celles-ci ne fournissent que les modèles sans divulguer les données d'entraînement ni le code d'entraînement, ce qui est très différent d'un logiciel open source.
Le vocabulaire que j'utilise et que je recommande :
- Poids libre — tu peux télécharger et exécuter les paramètres. Cela ne dit rien sur les conditions.
- Sous licence libre — MIT, Apache 2.0 ou équivalent. Aucune condition de revenus, aucune obligation de mention de la source, aucune restriction quant au domaine d'utilisation.
- Open source — les poids, le code d’entraînement et la composition des données, sous une licence approuvée par l’OSI. Presque rien dans ce domaine de pointe ne répond à ces critères.
Si un fournisseur parle de “ modèle open source ” et fait référence à la première définition, ce n'est pas tout à fait un mensonge, mais c'est le genre d'imprécision qui finit par se retrouver dans un cahier des charges, puis donne lieu à un litige.
Afficher l'image Les fonctionnalités tendent à s'uniformiser. Les licences, en revanche, divergent. Pour la plupart des acheteurs professionnels, c'est la colonne de droite qui détermine l'achat, et non la note attribuée.
Quatrième partie : Le problème des indices de référence
SWE-bench Verified se présente désormais comme suit :
| Classement | Modèle | Score |
|---|---|---|
| 1 | Claude, opus 5 | 96% |
| 2 | Claude Mythos 5 | 95.5% |
| 3 | Claude Fable 5 | 95% |
| 4 | Claude Opus 4.8 | 88.6% |
| 5 | Claude Opus 4.7 (Adaptative) | 87.6% |
| 6 | Ornith-1.5-397B | 86% |
| 7 | Claude Sonnet 5 | 85.2% |
| 8 | GPT-5.3 Codex | 85% |
Trois modèles se situent à moins d'un point de pourcentage les uns des autres en tête du classement. Ce test de référence n'a plus de valeur. Il ne permet pas de tirer des conclusions utiles sur les différences entre l'Opus 5, le Mythos 5 et le Fable 5, et quiconque s'y référera pour justifier un achat en septembre 2026 s'appuiera sur un outil qui a fait son temps.
Telle est la situation générale actuelle en matière d'évaluation de l'IA, et elle présente quatre types d'échecs qu'il convient de mentionner :
Saturation. Lorsque les meilleurs scores se regroupent au-dessus de 90%, les différences restantes sont principalement dues au bruit des étiquettes et aux détails du harnais plutôt qu’aux capacités. SWE-bench Verified se situe à ce niveau. GPQA Diamond s’en approche.
Sensibilité de l'échafaudage. Un même modèle obtient des résultats différents selon la boucle d'agent qui l'entoure : politique de réessai, ensemble d'outils, gestion du contexte, nombre de tours dont il dispose. Les résultats de Terminal-Bench et d'OSWorld y sont particulièrement sensibles. Il arrive souvent que deux laboratoires publiant les résultats d'un même benchmark n'aient pas mené la même expérience.
Contamination. Tout benchmark public finit par se retrouver dans les corpus d'entraînement. Cela a donné lieu à une course à l'armement consistant à créer des benchmarks privés toujours plus récents et plus complexes — Frontier-Bench, Agents’ Last Exam, GDPval, CritPt, Terminal-Bench-Science —, ce qui résout certes le problème de la contamination, mais en engendre un nouveau : il est impossible de vérifier de manière indépendante un benchmark privé.
Sélection. Les laboratoires publient les tests de performance qu’ils remportent. Anthropic s’est distingué avec Frontier-Bench et ARC-AGI-3 pour Opus 5. OpenAI s’est distingué avec ’ Agents’ Last Exam » et un « Coding Agent Index » pour GPT-5.6. Z.ai s’est distingué avec CyberGym. Aucun d'entre eux ne ment. Tous font un choix.
Ce en quoi j'ai vraiment confiance en septembre 2026
Les tournois par équipes plutôt que les tournois individuels. L’indice d’Artificial Analysis présente l’avantage d’être géré par un tiers, selon une méthodologie fixe, sur la base de neuf évaluations portant sur 190 modèles. Ses chiffres absolus n’ont guère de signification ; son commande est le signal public le plus facile à justifier qui soit.
Résultats normalisés en fonction des coûts. Les affirmations d’Anthropic concernant son Opus 5 illustrent parfaitement la manière de présenter ces informations : “ à moins de 0,51 TP3T du score maximal de Fable 5 pour la moitié du coût ’ sur CursorBench 3.2, et en surpassant Fable 5 sur OSWorld 2.0 ” pour un tiers du coût “. Il s’agit là d’une affirmation utile, car elle précise clairement le compromis.
Efficacité des jetons. Artificial Analysis a relevé que Gemma 4 31B n'avait utilisé que 39 millions de tokens de sortie pour générer l'intégralité de l'Intelligence Index. Pour une charge de travail agentique, un modèle qui parvient à la même réponse en un tiers du nombre de jetons représente un tiers du coût et un tiers de la latence. Cet aspect est sous-estimé, alors qu’il s’agit de l’un des rares indicateurs qui se traduisent directement en termes financiers.
Tes propres évaluations. Vingt tâches issues de ton backlog actuel, testées sur trois modèles, notées par tes soins. Cela prend un après-midi. Cela t'en apprendra davantage que tous les classements présentés dans cet article réunis, et c'est la seule évaluation qui, par définition, est exempte de biais.
Et il y a une chose à laquelle je ne fais pas confiance : tout chiffre concernant le nombre de jetons par seconde ou tout résultat de test de performance cité sans cadre de référence, sans précision sur la quantification et sans date. Considérez cela comme des estimations d'ordre de grandeur.
Cinquième partie : Le nombre qui a réellement évolué — L'horizon temporel agentique
Si tu ne dois retenir qu'un seul indicateur de cet article, retiens celui-ci.
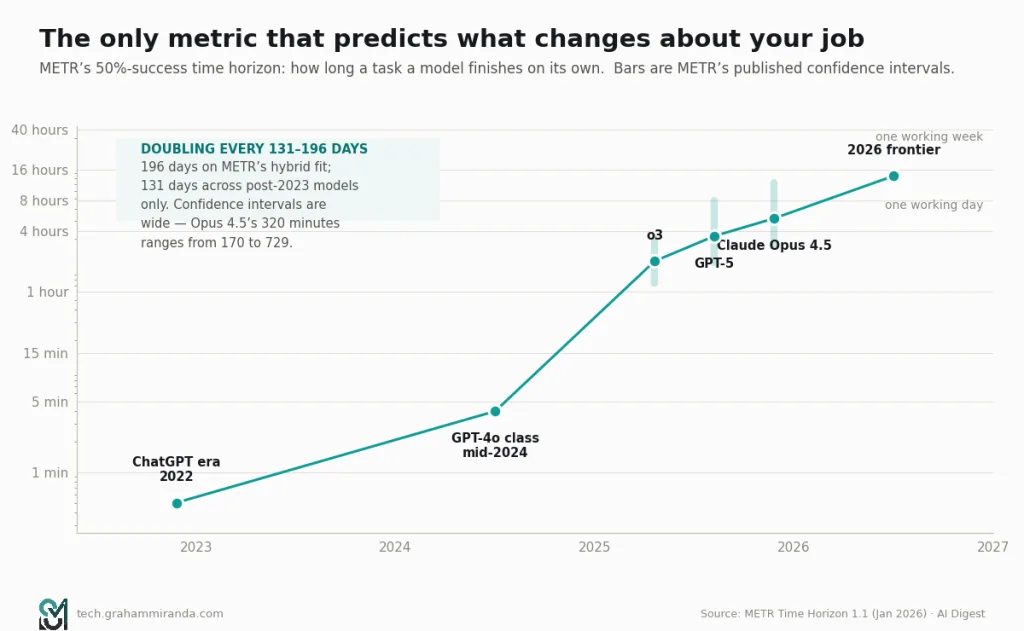
Le METR mesure la durée d’une tâche — en heures-homme — qu’un modèle est capable d’accomplir de manière autonome en réussissant le test 50%. C'est un meilleur indicateur pour déterminer si “ cette chose est capable de faire mon travail ” que n'importe quel benchmark de connaissances, car il rend compte de ce qui échoue réellement dans la pratique : non pas le fait de ne pas connaître la réponse, mais celui de rester cohérent suffisamment longtemps pour y parvenir.
L'évolution, d'après les travaux menés par METR et le suivi effectué par AI Digest :
| Période | 50% - horizon de réussite |
|---|---|
| 2022 (époque du lancement de ChatGPT) | environ 30 secondes |
| Mi-2024 (classe GPT-4o) | environ 4 minutes |
| Fin 2025 (Claude Opus 4.5) | 320 minutes (environ 5,3 heures), IC [170, 729] |
| 2026 : à l'aube d'une nouvelle ère | Plus de 14 heures |
C'est le temps de doublement qui fait débat. La version 1.1 de « Time Horizon » de METR, publiée le 29 janvier 2026 — 228 tâches, dont 31 estimées à huit heures ou plus de travail humain, ont été transférées vers le cadre « Inspect » de l'UK AI Security Institute — indique 196 jours (7 mois) sur un mélange de données anciennes et récentes, mais 131 jours si l'on se limite aux modèles postérieurs à 2023, ce qui représente une accélération d'environ 20% par rapport aux 165 jours obtenus avec la méthodologie précédente.
C'est en extrapolant une courbe exponentielle que l'on se met dans l'embarras ; je tiens donc à souligner clairement les mises en garde avant d'utiliser ce chiffre.
Les réserves sont importantes. Les intervalles de confiance propres à METR sont énormes : l’horizon de 320 minutes d’Opus 4.5 s’étend de 170 à 729 minutes. Seules 5 de leurs 31 tâches longues disposent de références humaines mesurées ; les autres sont des estimations. La composition des tâches modifie la tendance mesurée. Et “ réussir 50 % sur une tâche bien spécifiée dans un environnement propre ” est bien loin de “ réussir 50 % sur ta base de code, avec ta suite de tests instable et ton processus de déploiement non documenté ”.
Cela étant dit,, la tendance ne fait aucun doute et l'ordre de grandeur est globalement correct. D'après cette extrapolation, les agents de pointe atteindront une autonomie d'environ une journée de travail en 2027 et d'environ une semaine de travail en 2028.
Pourquoi ce chiffre est-il si important ?
Parce que C'est le seul indicateur qui permet de prévoir les changements qui vont intervenir dans ton travail.
Un modèle avec un horizon de 4 minutes est doté d'une fonction d'autocomplétion. Tu restes en permanence dans la boucle, et la qualité du modèle détermine la pertinence des suggestions.
Un modèle avec un horizon de 5 heures, c'est comme un collègue à qui tu fais le point le matin et avec qui tu fais le bilan à midi. Tu n'es pas au cœur du processus ; tu en es à la fin. La qualité du modèle détermine à quelle fréquence ce bilan s'avère pénible.
Nous ne disposons pas de structure de gestion adaptée à un modèle avec un horizon de 40 heures. Tu serais amené à examiner une semaine de travail que tu n’as pas suivie, dans une base de code qui a évolué pendant ton absence, en te référant à un cahier des charges que tu as rédigé avant même de connaître les problèmes.
Tous les arguments développés dans la suite de cet article — qu'il s'agisse du « vibe coding », de la vérification ou de l'identification du goulot d'étranglement — portent en réalité sur ce qui se passe lorsque ce chiffre augmente. Les modèles ont acquis une vision à long terme. Ce n'est pas le cas de nos processus d'évaluation.
Afficher l'image L'horizon temporel de réussite du modèle 50%, avec les intervalles de confiance de METR présentés en toute transparence. Ces intervalles sont suffisamment larges pour avoir une incidence — et la tendance se maintient malgré tout.
ACTE II — L'AVENIR DU « VIBE CODING »
Sixième partie : Que signifie aujourd’hui le “ Vibe Coding ” ?
Andrej Karpathy a inventé ce terme en février 2025 pour décrire un phénomène précis et quelque peu espiègle : se laisser porter par l'ambiance, oublier que le code existe, accepter les diffs sans les lire et laisser le modèle prendre les commandes. Il s'agissait d'une description d'un mode, a-t-il déclaré, à moitié pour plaisanter, pour des petits projets de fin de semaine sans grande importance.
Dix-huit mois plus tard, cette expression a parcouru tout son cycle de vie. Elle est d’abord devenue un mouvement, puis un intitulé de poste, ensuite un terme péjoratif, puis le mot de l’année selon le dictionnaire Collins, puis une catégorie de financement par capital-risque, et aujourd’hui — dans la seule évolution qui compte vraiment — un ensemble de pratiques d'ingénierie qui ne correspondent plus à ce que Karpathy avait décrit.
Je tiens à être précis quant à cette distinction, car ces deux notions sont constamment confondues alors qu'elles présentent des profils de risque opposés.
Le « vibe coding », au sens premier du terme. Demander la confirmation, accepter, exécuter, demander à nouveau la confirmation. Ne pas lire le fichier diff. L'artefact est jetable. C'est vraiment génial, et je le fais plusieurs fois par semaine — pour un script qui reformate un fichier CSV, un scraper ponctuel, une visualisation que je ne consulterai qu'une seule fois, un prototype dont le seul but est de concrétiser une conversation. Ce qui le caractérise, ce n'est pas la vitesse. C'est le fait que personne ne s'y fiera jamais.
Ingénierie agentique, détection de courant. Rédigez un cahier des charges. Fournissez à l'agent une suite de tests, un linter, un vérificateur de types et un environnement de test isolé. Laissez-le tourner pendant une heure. Examinez attentivement les modifications. Effectuez la fusion en respectant les mêmes règles de validation qu'une pull request humaine. La caractéristique principale réside dans le fait que les résultats du modèle sont considérés comme ceux d'un collègue débutant : utiles, rapides, mais peu fiables.
Ces deux produits partagent la même technologie, mais n'ont pratiquement rien d'autre en commun. Si tu souhaites la version « pour professionnels » du second, c'est celle-là qu'il te faut. mon précédent article sur le « vibe coding » en 2026 traite de ; cette section aborde l’orientation que prend cette pratique. Les conséquences catastrophiques décrites dans la huitième partie résultent toutes de l’application des pratiques du premier mode aux enjeux du second mode.
Les chiffres relatifs aux adoptions sont colossaux et, pour la plupart, ne font l'objet d'aucune contestation
- 90% de développeurs utilisent au moins un outil d'IA au travail, selon l'enquête ’ AI Pulse » de JetBrains (janvier 2026). L'enquête de Stack Overflow de 2025 avait recensé 84% qui utilisaient ou prévoyaient d'utiliser un tel outil.
- Près de 80% de nouveaux développeurs sur GitHub adopter Copilot dès leur première semaine (GitHub Octoverse 2025).
- 59% de développeurs utilisent au moins trois outils de codage basés sur l'IA en parallèle. Cette statistique en dit plus long que le simple chiffre d'adoption : le marché ne s'est pas consolidé, il s'est fragmenté en outils dédiés à des tâches spécifiques.
Les chiffres du marché
| Outil | Métrique | Source / date |
|---|---|---|
| GitHub Copilot | ~42% : part de marché en fonction du nombre d'utilisateurs ; plus de 20 millions d'utilisateurs | Gartner / fournisseur, 2026 |
| Curseur | $2B+ ARR ; plus d'un million d'utilisateurs actifs quotidiens ; environ 20 à 25% de part de marché en termes de chiffre d'affaires | Publié en février 2026 |
| Claude Code | ~$2,5B en rythme annuel ; 46% “ les plus appréciés ” contre 19% pour Cursor | Publié en avril 2026 |
| Marché des agents de codage d'entreprise | ~$9,8–11B en données annualisées | Gartner, avril 2026 |
Deux éléments ressortent. Copilot compte le plus grand nombre d'utilisateurs, mais affiche le taux de satisfaction le plus bas parmi les trois principaux acteurs. Claude Code dispose de la plus petite base d'utilisateurs, mais bénéficie de loin du plus haut niveau d'attachement. C'est là la marque d'un marché en pleine transition : l'acteur historique a remporté la distribution, le challenger a conquis le flux de travail, et les utilisateurs n'ont pas encore achevé leur migration.
Et le chiffre qui remet tout cela en cause
La confiance des développeurs dans les résultats générés par l'IA est passée d'environ 40% en 2024 à 29% en 2026. Une autre enquête menée par SonarSource a révélé que 96% de développeurs ne font pas entièrement confiance à la justesse fonctionnelle du code généré par l'IA.
Réfléchissez-y. L'utilisation a augmenté. La confiance a diminué. Ces deux phénomènes ne sont pas contradictoires ; ils reflètent justement le processus d'adoption d'un outil par des utilisateurs expérimentés. Personne ne “ fait confiance ” à une tronçonneuse. On l'utilise sans cesse, à deux mains, en portant des équipements de protection, et on ne lui tourne jamais le dos.
Ce sont ceux qui maîtrisent le mieux ces outils qui les utilisent avec le plus de prudence. C'est un signe encourageant, qui est pourtant totalement absent de la plupart des stratégies marketing des fournisseurs.
Septième partie : Est-ce que ça te rend vraiment plus rapide ? Les faits, en toute honnêteté
C'est là que je risque de perdre certains lecteurs, mais je préfère les perdre à ce stade plutôt que de les induire en erreur.
L'essai randomisé apporte une réponse négative
C'est METR qui a mené l'étude que tout le monde cite, en juillet 2025 : des développeurs open source expérimentés, travaillant sur leurs propres dépôts bien établis (plus d'un million de lignes de code), ont été répartis de manière aléatoire, au niveau des tâches, entre deux groupes : l'un utilisant les outils d'IA du début de l'année 2025, l'autre n'y ayant pas recours.
Résultat : 191 TP3T plus lent avec l'IA.
Et cette conclusion qui importe davantage que le titre : Les développeurs estimaient avoir gagné environ 20% en vitesse. Ils ont surestimé l'impact de l'IA sur leur temps de travail d'environ 40 points de pourcentage.
Le suivi de 2026 n'a pas permis de résoudre le problème — il a révélé quelque chose de pire encore
METR a tenté de refaire l'expérience et, en février 2026, a publié un article d'une franchise inhabituelle expliquant pourquoi la conception avait échoué.
- Le recrutement a échoué. Les développeurs refusent de plus en plus de travailler sans avoir accès à l'IA, même à $50 de l'heure.
- La sélection des tâches a été faussée. Entre 30 et 50% de développeurs ont reconnu avoir évité les tâches qu’ils pensaient que l’IA serait capable de gérer efficacement. Un participant l’a parfaitement résumé : “ J’évite les remarques du genre : ”L’IA peut faire ça en seulement deux heures, alors que moi, je dois y passer vingt heures.” »
- Le suivi du temps ne fonctionne plus À une époque, les développeurs exécutaient plusieurs agents simultanément.
Leurs chiffres provisoires bruts pour 2026 variaient entre −18% et −4% — une évolution toujours plus lente, mais de manière moins marquée — ; toutefois, METR qualifie lui-même ces résultats de “ preuves très faibles ” compte tenu du biais de sélection.
Relisez le deuxième point, car il s'agit de la conclusion la plus intéressante de toute la littérature scientifique et elle est noyée dans une note méthodologique. Si les développeurs affectent systématiquement les tâches adaptées à l'IA loin D’après une étude visant à évaluer les avantages de l’IA, celle-ci sous-estimera ces avantages. Cela implique également que, dans la pratique, les développeurs s’occupent déjà de l’acheminement — ce qui est précisément le comportement qui confère toute leur valeur à ces outils et rend difficile la mise en œuvre d’un essai contrôlé randomisé (RCT).
Les sondages indiquent que oui, et de loin, mais leurs résultats sont exagérés
L'enquête menée par METR en mai 2026 (n = 349 : 87 ingénieurs en informatique, 71 chercheurs, 129 universitaires et doctorants, 48 fondateurs et dirigeants ; en moyenne 12 ans d'expérience en programmation, 19 mois d'utilisation d'outils d'IA) a adopté une approche astucieuse. Elle a distingué valeur de vitesse.
Le répondant médian a déclaré un Multiplicateur de vitesse × 3 mais seulement un Une augmentation de 1,4 à 2 fois la valeur de leur travail. Rétrospectivement, ils ont estimé que cette valeur serait de 1,3 fois supérieure en mars 2025 ; ils prévoient qu'elle atteindra 2,5 fois cette valeur d'ici mars 2027.
METR précise clairement que la valeur est le chiffre qui intéresse réellement les concepteurs d'enquêtes, et que les personnes interrogées raisonnent naturellement en termes de vitesse — ce qui correspond exactement au biais que l'essai contrôlé aléatoire (RCT) de 2025 a chiffré à 40 points de pourcentage.
Donc : selon les déclarations des personnes interrogées, le chiffre est de 3×. Si l'on tient compte de ce que les personnes ont réellement voulu dire, ce chiffre se situe entre 1,4 et 2×. La seule mesure contrôlée dont nous disposons indique 0,81×.
Les données organisationnelles indiquent que “ cela dépend de toi, et non de l'outil ”.
Le rapport 2026 de DORA (Google Cloud, mai 2026) est la publication la plus utile de l'année sur ce sujet, et il est utile précisément parce qu'il cesse de se perdre en débats sur l'outil.
- Retour sur investissement (ROI) estimé pour la première année de 39% pour une structure d'ingénierie comptant 500 personnes, avec environ un Amortissement en 8 mois — Une valeur de $11,6 millions contre un investissement de $8,4 millions.
- A courbe en J: la productivité connaît une baisse avant de remonter, en raison de l'adaptation des processus de travail, des coûts liés à la vérification des revues de code et des modifications en aval apportées aux étapes de test et de validation.
- Le taux d'échec des modifications passe de 5% à 6% après l'adoption, ce qui représente un coût de $344 000 en temps d'arrêt selon leur exemple de calcul.
- Et la thèse : “ Les meilleurs retours sur investissement en matière d'IA ne proviennent pas des outils eux-mêmes, mais d'une approche stratégique axée sur le système organisationnel sous-jacent. ”
Cette dernière phrase correspond au consensus pour 2026, s'il y en a un. L'IA renforce les pratiques d'ingénierie que tu mets déjà en œuvre. Des tests de qualité, une véritable révision du code, une annulation rapide des modifications, une responsabilité clairement définie : l'IA permet à ces organisations de gagner considérablement en rapidité. Des tests médiocres, une révision purement formelle, des déploiements manuels, une responsabilité floue : l'IA fait en sorte que ces organisations échouent plus rapidement et à plus grande échelle.
Comment concilier tout cela ?
Je ne pense pas que ces conclusions soient réellement contradictoires. Voici la synthèse à laquelle je suis parvenu, que je considère toutefois comme provisoire :
Les outils de programmation basés sur l'IA constituent un atout majeur pour les tâches peu familières et un léger inconvénient pour celles que l'on maîtrise parfaitement. Sur une base de code que tu connais sur le bout des doigts, dans un langage que tu maîtrises parfaitement, face à un problème que tu as déjà résolu, tu es plus rapide que le cycle « révision-correction ». Face à un framework inconnu, à un langage que tu n'utilises que deux fois par an, à du code standard, à la mise en place de tests, à des migrations ou à une base de code que tu n'as pas ouverte depuis huit mois, ce modèle change la donne.
METR a mené une étude auprès de développeurs expérimentés sur leurs propres dépôts de code bien établis — le seul scénario dans lequel on pourrait s'attendre à un gain minimal. Cela ne signifie pas pour autant que cette conclusion soit erronée. Cela la rend simplement spécifique, et cela devrait t'inciter à te méfier de quiconque la cite comme un verdict général, dans un sens comme dans l'autre.
La deuxième réconciliation : les progrès sont bien réels, mais ils se manifestent ailleurs que là où on les attend. Pas “ cette fonctionnalité a pris quatre heures au lieu de six ”. Mais plutôt : la migration qui n’allait jamais être priorisée a été réalisée ; la couverture de test qui allait toujours rester à 40% est passée à 75% ; la documentation existe. Ces éléments n’apparaissent pas dans une étude sur le temps de réalisation des tâches, et pourtant, ils constituent l’essentiel de la valeur réelle.
Huitième partie : Le projet de loi sur la sécurité est arrivé, et il est détaillé
Si la septième partie était dérangeante, c'est celle-ci que les gens ont tendance à sauter. Je te prie de ne pas la sauter.
Les mesures
Veracode a testé plus de 100 grands modèles linguistiques sur 80 tâches de programmation en Java, Python, C# et JavaScript :
- 45% d'exemples de code générés par l'IA présentent une vulnérabilité figurant dans le classement « OWASP Top 10 ». Le taux de réussite est resté pratiquement inchangé jusqu'au début de l'année 2026 : les modèles sont devenus bien plus performants, mais pas plus sûrs.
- Java a obtenu les pires résultats, avec un taux d'échec de 721 TP3T.
- 86% n'ont pas réussi à se protéger contre les attaques de type « cross-site scripting ». 88% étaient vulnérables à l'injection de journaux.
Apiiro a appliqué son moteur d'analyse approfondie du code aux référentiels d'entreprises du classement Fortune 50 entre décembre 2024 et juin 2025 :
- Les développeurs aidés par l'IA effectuent des commits à trois à quatre fois le taux de leurs pairs.
- Ils présentent leurs conclusions en matière de sécurité sur dix fois le taux.
- Les failles permettant l'escalade de privilèges ont augmenté de 3 221 TP3T. Les failles liées à la conception architecturale ont augmenté de 1 531 TP3T.
USENIX Security 2025 a analysé 576 000 exemples de code générés par l'IA :
- Environ 20% de paquets de référence qui n'existent pas.
- 43% de noms de paquets imaginaires apparaissent systématiquement dans des invites similaires — c'est précisément cet élément qui transforme un bug en surface d'attaque. Une « hallucination prévisible » correspond à un emplacement qu'un attaquant peut préenregistrer sur npm ou PyPI.
Le « Vibe Security Radar » de Georgia Tech a remonté la piste des CVE dans l'historique Git pour les attribuer à des outils d'IA :
| Mois (2026) | CVE attribués |
|---|---|
| janvier | 6 |
| février | 15 |
| mars | 35 |
74 cas confirmés au total ; les chercheurs estiment que le nombre réel dans l'ensemble des logiciels libres s'élève à cinq à dix fois plus élevé.
RedAccess indexé de manière approximative 380 000 applications accessibles au public et classées par ambiance sur Lovable, Base44, Replit et Netlify. Environ 5 000 d'entre elles exposaient des données sensibles, qu'elles soient d'entreprise ou personnelles.
Les incidents, qui ont eu lieu le
| Date | Incident |
|---|---|
| juillet 2025 | Replit AI a supprimé une base de données de production ; 1 200 fiches de cadres ont été affectées et 4 000 comptes fictifs ont été créés |
| février 2026 | Une application EdTech développée par Lovable a exposé 18 697 enregistrements d'utilisateurs, dont 4 538 comptes d'étudiants |
| avril 2026 | La charmante vulnérabilité de BOLA : tous les projets antérieurs à novembre 2025 sont accessibles en cinq appels API |
| 26 avril 2026 | Un “ effacement en 9 secondes ” par inadvertance : la base de données d’une entreprise a été supprimée, ainsi que ses sauvegardes |
| 30 avril 2026 | Vulnérabilité CVSS-10 de Gemini CLI permettant l'exécution de code à distance dans les workflows CI, corrigée |
L'affaire Amazon, que je vais traiter avec prudence
Tu as sans doute entendu parler de l'affaire Amazon. Quatre incidents de niveau Sev-1 entre décembre 2025 et mars 2026 : une panne de 13 heures d'AWS Cost Explorer en Chine, des délais de livraison erronés affichés dans les paniers d'achat le 2 mars, qui auraient entraîné la perte d'environ 120 000 commandes, et un incident de 6 heures le 5 mars au cours duquel les commandes en Amérique du Nord auraient chuté de 99%.
Des articles publiés par le Financial Times, Fortune et The Register ont établi un lien entre des documents internes d'Amazon et ce qui a été décrit comme des “ modifications assistées par l'IA de nouvelle génération ”, en soulignant que la génération rapide de code exposait le système à des vulnérabilités. Amazon a contesté l'existence d'un lien de causalité direct, affirmant dans certaines réponses qu'aucun de ces incidents n'impliquait de code rédigé par une IA.
Je tiens à souligner trois points concernant cette histoire plutôt que de la répéter comme un fait avéré :
- Le chiffre le plus souvent cité concernant l'impact (6,3 millions de commandes perdues) provient d'un article publié sur Medium, et non d'Amazon ni d'un reportage d'un média en particulier. Il convient de le considérer comme une estimation, et non comme un chiffre avéré.
- Le déploiement du 5 mars aurait eu lieu sans documentation officielle ni autorisation. Il s'agit d'une défaillance du processus. La vitesse de l'IA a fait en sorte que possible pour que cela se fasse plus rapidement ; cela n’a pas rendu l’étape d’approbation facultative.
- C'est justement cette distinction qui est essentielle, et c'est la raison pour laquelle je mentionne cette histoire. Le mode de défaillance n'est presque jamais “ l'IA a écrit un code défectueux ”. Il s'agit plutôt de “ l'IA a écrit le code plus vite que le processus censé le vérifier ”.”
Ce que cela implique concrètement dans la pratique
Il ne s'agit pas de “ cesser d'utiliser ces outils ”. Personne de sérieux ne défend cette position, et la note de recherche de la CSA elle-même — qui rassemble la plupart des éléments cités ci-dessus — met l'accent sur la gouvernance plutôt que sur l'abstinence.
La mise en œuvre concrète, telle que je la concevrais :
- Considérez tout outil d'IA disposant d'un accès aux identifiants comme un système privilégié. C'est bien ça. Adapte tes jetons en conséquence.
- SAST, analyse des dépendances et détection des secrets à chaque commit. Pas tous les soirs. À chaque commit. La fréquence des commits a été multipliée par trois ou quatre ; un scan nocturne correspond désormais, en pratique, à une boucle de rétroaction de trois jours.
- Analyse de la composition logicielle, en particulier pour les paquets « hallucinés ». Il s'agit du composant le moins cher et offrant le meilleur rapport qualité-prix de la liste, car la valeur 20% est très élevée et sa défaillance passe totalement inaperçue.
- Une politique écrite stipulant que l’assistance par IA ne doit pas être utilisée sans vérification préalable dans les domaines de l’authentification, de la cryptographie, de l’autorisation ou des codes de paiement. Ce sont là les quatre domaines dans lesquels une erreur, même minime, est à la fois probable et catastrophique, et où l'œil avisé d'un relecteur s'avère le plus précieux.
- Étends ton SBOM pour consigner la provenance des outils d'IA. Lorsque la prochaine étude d'attribution de type Georgia Tech portera sur ta base de code, tu voudras pouvoir répondre toi-même à cette question.
- Considérez les plateformes tierces de codage d'ambiance comme des fournisseurs de services SaaS. Les chiffres de RedAccess, c'est ce qui arrive quand personne ne s'en charge.
Tout cela n'a rien d'exceptionnel. La plupart de ces pratiques correspondaient déjà à ce que faisait n'importe quel magasin compétent en 2019. La différence, c'est que le volume a augmenté d'un ordre de grandeur ; les contrôles doivent donc être automatiques plutôt que culturels.
Afficher l'image Les données relatives à la sécurité proviennent de Veracode, Apiiro, USENIX et Georgia Tech. Remarquez la courbe : la cadence des commits a été multipliée par 3 à 4, tandis que le nombre de failles de sécurité a été multiplié par 10. L'écart entre ces deux multiplicateurs résume tout le problème.
Neuvième partie : Ce qui a remplacé le « Vibe Coding »
La pratique qui fonctionne réellement en 2026 porte un nom — plusieurs noms concurrents, ce qui prouve d'ailleurs qu'elle existe bel et bien — et elle est à peu près à l'opposé de ce qu'on appelle les « vibes ».
Appelons ça développement axé sur les spécifications, ingénierie agentiqueou ingénierie contextuelle. La structure type :
1. Le cahier des charges correspond désormais au code source
Pas un ticket Jira. Un véritable document : ce que fait le système, ce qu’il ne doit pas faire, quelles sont ses interfaces, à quoi ressemble un résultat “ terminé ”, quels sont les modes de défaillance. Enregistré dans le référentiel, versionné, révisé.
On a l’impression de revenir en 1998, mais ce n’est pas le cas. La différence, c’est qu’en 1998, le cahier des charges servait de base à un être humain qui le réinterprétait, et il perdait toute valeur dès le début de la programmation. En 2026, le cahier des charges sert de base à un processus qui régénère l’implémentation à moindre coût — ce qui signifie que lorsque les exigences changent, on modifie le cahier des charges et on le redérive, plutôt que de rafistoler du code qui ne correspond plus à aucune description écrite de lui-même.
La donne économique s'est inversée. Lorsque la mise en œuvre coûtait cher et que la définition du cahier des charges ne coûtait pas cher, on définissait le cahier des charges de manière vague et on investissait dans le code. Lorsque la mise en œuvre ne coûte pas cher et que la définition du cahier des charges constitue le goulot d'étranglement, on investit dans le cahier des charges.
2. La suite de tests constitue la limite de confiance
Un outil capable d'exécuter tes tests et d'effectuer des itérations à partir de ceux-ci est fondamentalement différent d'un outil qui en est incapable. Il s'agit là du changement le plus déterminant que la plupart des équipes puissent mettre en œuvre, et cela n'a absolument rien à voir avec l'IA : c'est simplement que l'IA a enfin permis de mettre en évidence le retour sur investissement lié à la couverture de test pour des personnes que les arguments techniques n'auraient jamais pu convaincre.
Version pratique : L'agent dispose d'un environnement de test, d'une commande de test, d'une commande de vérification syntaxique et d'une vérification de type ; le processus n'est pas terminé tant que ces quatre éléments n'affichent pas tous le statut « vert ». Tout le reste est négociable.
3. La révision est passée de l'analyse ligne par ligne à la comparaison des différences, puis à l'analyse du comportement
La révision ligne par ligne n'est pas adaptée à un fichier de différences de mille lignes généré par un agent, et prétendre le contraire, c'est commencer à valider sans discernement.
Voici ce qui fonctionne, par ordre décroissant d'importance :
- Examinez le cahier des charges, et non la mise en œuvre. Si le cahier des charges est correct et que les tests sont réussis, la mise en œuvre n'est qu'un détail.
- Vérifiez la forme du différentiel — quels fichiers ont été modifiés, quelles dépendances ont été ajoutées, ce qui a été supprimé. La plupart des incidents liés aux agents sont visibles à ce niveau : un fichier inattendu, une nouvelle dépendance, une suppression non sollicitée.
- Examinez tout particulièrement les lignes sensibles sur le plan de la sécurité. Authentification, cryptographie, autorisation, paiements, tout ce qui touche aux données à caractère personnel. Cela ne représente qu'une infime partie de tout diff.
- Ne relisez pas le texte standard. De toute façon, tu ne l'as jamais vraiment évalué.
4. Le harnais est tout aussi important que le modèle
Cet aspect est sous-estimé. Un même modèle, utilisé dans deux boucles d'agents différentes, produit des résultats d'une qualité extrêmement variable — ce qui explique précisément pourquoi les comparaisons de performances entre laboratoires sont si délicates.
Les éléments essentiels : la manière dont le contexte est géré lorsque l'exécution s'éternise, la capacité de l'agent à identifier ses propres échecs de test, sa capacité à parcourir le référentiel ou à se limiter uniquement à ce que tu y colles, la distinction entre une étape de planification et une étape d'exécution, et sa capacité à savoir quand s'arrêter et demander de l'aide.
Les notes de mise à jour de la version 1.3 de Muse Spark de Meta sont particulièrement intéressantes sur ce point précis : elles indiquent que le modèle pose désormais des questions de clarification en cas de requêtes ambiguës, sollicite de l'aide lorsqu'il est bloqué et demande confirmation avant d'entreprendre des actions importantes. Ce ne sont pas des progrès en matière d'intelligence. Ce sont des questions de bonnes manières., et ce sont les bonnes manières qui permettent à un agent à long terme d'assurer sa survie.
5. Le routage par modèle est désormais une pratique courante
Personne de sérieux n'utilise un seul modèle pour tout — j'ai présenté une version à deux modèles de ce concept dans GLM-5.3-Flash vs MiniMax M3 dans OpenCode. La tendance qui s'est installée :
json
{
  "$schema" : "https://opencode.ai/config.json",
  "model" : "anthropic/claude-opus-5",
  "small_model": "ollama/qwen3.8:27b",
  "agent": {
    "plan": {
 "description": "Architecture, cause première, tout ce où se tromper coûte cher",
 "model": "anthropic/claude-fable-5-1"
    },
    "build" : {
 "description" : "L'essentiel de la mise en œuvre — horizon à long terme, sensible aux coûts",
 "model" : "anthropic/claude-opus-5"
    },
    "bulk" : {
 "description" : "Travail mécanique à haut volume où le prix est déterminant",
 "model" : "zai/glm-5-3-flash"
    },
    "private" : {
 "description" : "Tout ce qui touche aux données des clients — s'exécute sur notre propre matériel",
 "model" : "mlx/gpt-oss-120b"
    },
    "grunt" : {
 "description" : "Renommage, chaînes de documentation, corrections de lint, création de tests",
 "model" : "ollama/gemma-4-26b-a4b"
    }
  }
}
Le raisonnement, ligne par ligne :
- Opte pour le modèle le plus performant que tu peux te permettre. Un mauvais plan coûte plus de jetons en aval que ce qu’il a jamais coûté.
- On mise sur le meilleur modèle à long terme, à un prix raisonnable. L'Opus 5, disponible aux références $5 et $25, est clairement conçu à cet effet et coûte la moitié du prix du Fable.
- Le travail mécanique en masse est attribué à GLM-5.3-Flash à $0.15/$0.47, car à ce prix-là, la question n'est pas de savoir s'il est aussi bon, mais s'il est suffisamment performant pour la tâche en question. C'est souvent le cas.
- Tout ce qui est privé reste local, sur un modèle adapté à ta machine.
- Le travail de base revient à une petite agence de communication locale, car renommer un symbole dans quarante fichiers ne nécessite pas de réflexion approfondie et ne t'oblige pas à quitter ton ordinateur portable.
Note les identifiants des modèles de manière à ce que l'interversion de l'un d'entre eux ne nécessite qu'une seule ligne de modification. Étant donné que quatre laboratoires ont commercialisé un modèle figurant dans le top 10 entre juin et septembre, tu devras effectuer cette modification à nouveau au cours du trimestre.
Dixième partie : L'avenir du « Vibe Coding » — Six prévisions, accompagnées d'un niveau de confiance
Les pronostics sans niveau de confiance ne sont que du divertissement. Voici les miens, avec le montant que je serais prêt à parier.
1. Le mot disparaît ; la pratique se divise définitivement. Confiance élevée.
“Le ” vibe coding » est déjà en passe de devenir un terme péjoratif dans les milieux professionnels et un motif de fierté uniquement dans le domaine du marketing. Ce qui le remplace, c’est une distinction claire en deux catégories : d’un côté, des artefacts jetables générés par l’IA dont personne ne lit le code (très bien, c’est correct, il faut en faire davantage) ; de l’autre, une ingénierie « agentique » validée, où la production du modèle passe par les mêmes filtres que celle d’un humain (très bien aussi, et c’est là que se trouve tout l’argent des entreprises).
C'est ce « juste milieu dangereux » — le code de production, non relu — qui constitue la liste des incidents de 2026, et il finira par disparaître dans les contextes commerciaux, sous l'effet des réglementations, des assurances ou des audits. Non pas parce que quelqu'un l'interdit, mais parce qu'un questionnaire de sécurité finira par le demander.
2. La vérification devient le goulot d'étranglement, et les investissements en outils s'y concentrent. Confiance élevée.
Nous en sommes déjà là et le marché n'a pas encore réévalué les prix. Si les agents sont capables de produire une semaine de travail, la contrainte réside dans la capacité humaine à vérifier que cette semaine de travail est bien correcte.
On peut s'attendre à ce que les produits phares de 2027 concernent vérification plutôt que générer: la génération de tests basée sur les propriétés, les outils de comparaison sémantique qui décrivent les changements de comportement plutôt que les modifications de code, la vérification automatisée de la conformité aux spécifications, la vérification à l'exécution des actions des agents, et — c'est celui-là que je développerais — des outils qui t'indiquent quels 5% d'un fichier de différences volumineux une personne doit réellement lire.
3. Les méthodes formelles ont enfin leur heure de gloire, avec vingt ans de retard. Confiance moyenne.
L'objection historique à la spécification formelle était que la rédaction de la spécification coûtait plus cher que l'écriture du code. Cette objection n'a plus lieu d'être aujourd'hui, car l'écriture du code ne coûte pratiquement rien et c'est de toute façon la rédaction des spécifications qui constitue le goulot d'étranglement.
Les systèmes de types, les contrats, les invariants, les tests de propriétés et la vérification formelle allégée trouvent soudainement un cas d’utilisation qui justifie pleinement leur existence : ce sont des déclarations d’intention vérifiables par une machine, que l’agent peut tester de manière itérative sans intervention humaine. Je m’attends à ce que Rust, les modes plus stricts de TypeScript et les bibliothèques de contrats en Python en tirent un bénéfice disproportionné.
La raison pour laquelle ma confiance n'est que modérée : depuis 1985, le milieu prévoit une renaissance des méthodes formelles à peu près tous les sept ans.
4. Les modèles locaux prennent entièrement en charge le niveau « grunt ». Confiance moyenne à élevée.
Regarde ce que fait actuellement un modèle 27B sous licence Apache 2.0, ajoute une année supplémentaire, puis installe-le sur une machine dotée de 64 Go de mémoire unifiée. Renommage, chaînes de documentation, structure de tests, messages de commit, corrections de lint, premières ébauches de traduction, analyse des logs… Rien de tout cela ne nécessite un modèle de pointe ; tout cela représente un volume important, et tout cela correspond exactement au type de travail que tu préfères ne pas confier à un tiers à partir du dépôt d’un client.
La frontière reste dans le cloud pour la planification et les calculs complexes. Le volume se déplace vers le local. À partir de la onzième partie, nous expliquerons pourquoi cela est désormais physiquement possible.
5. Le poste de développeur junior évolue plutôt que de disparaître. Confiance moyenne, et c'est celle que je considère comme la moins sûre.
Le scénario pessimiste est simple : si les agents effectuent le travail que faisaient auparavant les jeunes employés, personne n'embauche de jeunes employés, et dans dix ans, il n'y aura plus de cadres.
Je pense que le scénario le plus probable est que le poste de débutant passe de “ écrire le code ” à “ vérifier le code et prendre en charge le cahier des charges ” — ce qui est un métier plus difficile à aborder au départ, et non pas plus facile, et qui va obliger le secteur à repenser la manière dont il forme ses collaborateurs. Les équipes qui comprendront cela bénéficieront d’un énorme avantage en matière de recrutement par rapport à celles qui se contenteront de cesser d’embaucher.
Une mise en garde en toute honnêteté : c'est précisément dans ce cas que mes motivations et mon analyse vont dans le même sens, et c'est justement à ce moment-là qu'il faut se méfier de soi-même.
6. Quelqu’un est victime d’une défaillance véritablement catastrophique du code d’une IA, dont la responsabilité est publiquement attribuée. Grande certitude quant à l'événement, mais peu de certitude quant à la date.
Il ne s'agit pas d'une fuite de base de données. Il s'agit d'un incident impliquant une autorité de régulation, dont l'impact financier se chiffre en centaines de millions, et dont l'analyse des causes profondes révèle qu'un agent a effectué une opération qui n'a fait l'objet d'aucun contrôle humain.
La courbe d'attribution des CVE — 6, puis 15, puis 35 au cours des mois successifs de 2026, les chercheurs estimant que le taux réel est cinq à dix fois plus élevé — n'est pas une courbe qui s'aplatit d'elle-même. La question est de savoir si le secteur va renforcer ses propres mesures de sécurité de son propre chef ou s'il va attendre qu'un incident l'y oblige.
Ce que je ferais pour les six, en un mot : il vaut mieux investir dans les tests, les spécifications et les outils de vérification plutôt que dans les techniques de prompt, car ces dernières perdent de leur valeur à chaque nouvelle version du modèle, tandis que l'infrastructure de vérification ne cesse de se renforcer.
Afficher l'image Ces deux pratiques ont pour seul point commun la technologie. La boucle de gauche est adaptée aux tâches ponctuelles, mais catastrophique pour la production ; la boucle de droite est ce qui manquait dans la liste des incidents de la huitième partie.
ACTE III — L'IA HORS LIGNE SUR LES APPAREILS GRAND PUBLIC
Onzième partie : L'IA hors ligne a cessé d'être un simple passe-temps cette année
Pendant environ deux ans, “ le gérer localement ” a constitué un compromis fondé sur des principes. C'était possible. L'argument de vente, en toute honnêteté, était le suivant : Voici un modèle de 7 milliards de paramètres qui est moins performant que l'offre gratuite de n'importe quel service, sur du matériel que tu possèdes déjà, et la raison pour laquelle on le fait, c'est par principe.
La situation a changé en 2026, et ce changement s'explique par trois raisons distinctes qui se sont produites simultanément.
Les petits modèles sont devenus vraiment bons. Le modèle E4B de Gemma 4 compte environ 8 milliards de paramètres, prend en charge 128 Ko de contexte, traite le texte, les images, la vidéo et l'audio natif, et est soumis à la licence Apache 2.0. La variante dense de 31 milliards obtient un score de 39 sur l’indice Artificial Analysis — ce qui se situe dans la fourchette considérée comme de pointe il y a dix-huit mois — et a effectué l’intégralité du test sur 39 millions de tokens de sortie, soit une fraction de ce que consomment des modèles comparables. Qwen3.8-27B est un modèle multimodal dense sous licence Apache 2.0, doté d’un contexte natif de 262 000, qui, selon Alibaba, surpasse le bien plus volumineux Qwen3.7-Plus dans les tâches de codage et de bureautique.
Ce sont les systèmes d'exploitation qui l'ont fourni. C'est là le changement qui compte vraiment, et il s'est produit en toute discrétion. Microsoft a intégré Aion 1.0 à Windows 11. Apple propose sur ses iPhone un modèle dense de 3 milliards de paramètres ainsi qu'un modèle clairsemé de 20 milliards de paramètres. Google intègre Gemini Nano aux appareils Pixel et Samsung. L'IA embarquée n'est plus un élément que l'on installe, mais une fonctionnalité qui est déjà présente, ce qui fait la différence entre une technologie réservée aux passionnés et une technologie accessible à tous.
Et le matériel dispose enfin de la mémoire nécessaire. Ce n'est pas la puissance de calcul, mais la mémoire. Je reviendrai plus tard sur les raisons pour lesquelles cette distinction est essentielle.
Ce que “ l'IA hors ligne ” t'apporte réellement
Je vais être précis, car ce produit est mal présenté.
Latence. Un modèle 4B local répond en quelques dizaines de millisecondes. Un aller-retour vers le cloud prend, au mieux, plusieurs centaines de millisecondes. Pour tout ce qui est interactif et continu — dictée, traduction en temps réel, saisie semi-automatique, synthèse au fur et à mesure de la saisie —, la solution locale l’emporte en termes de fluidité, et non de qualité, et c’est cette fluidité que les utilisateurs remarquent.
Une protection de la vie privée qui relève davantage de l'architecture que du contrat. Avec une API, chaque requête sort de ton infrastructure et tu dois disposer d'un accord de traitement, d'une analyse d'impact sur le transfert, d'une cartographie des flux de données et d'une réponse à fournir à ton délégué à la protection des données. Avec un modèle fonctionnant sur l'appareil, La question du transfert transfrontalier ne se pose pas, puisqu'il n'y a pas de transfert. Dans le cadre des relations commerciales avec l'Allemagne et l'Union européenne, c'est souvent là tout l'argument, et c'est ce qui permet de conclure des affaires, ce que le prix seul ne permettrait jamais.
Disponibilité. Dans un avion. Sur un site sans réseau. Dans un établissement où l'accès au réseau est interdit. Lors d'une panne chez ton opérateur.
Prévisibilité des coûts. Ce n'est pas une question d'économies — je ferai le calcul dans la quinzième partie, et le résultat ne correspondra pas à ce que les gens espèrent. Mais un coût matériel fixe associé à un coût marginal nul par jeton représente une ligne budgétaire très différente d'une facturation basée sur l'utilisation, qui évolue en fonction de l'enthousiasme de l'agent.
Verrouillage de version. Dans un modèle API fermé, les mises à jour s'effectuent sous un identifiant de modèle stable, mais le comportement du modèle évolue. Un point de contrôle local reste identique au byte près au bout d'un an. Si tu as déjà vu une instruction qui fonctionnait cesser soudainement de fonctionner, tu sais à quel point cela a de la valeur.
Et ce que cela ne t'apporte pas
Capacité d'exploration. L'écart entre un modèle 4B sur ton téléphone et Claude Fable 5.1 n'est pas négligeable et ne se comblera pas. Quiconque te dit le contraire cherche à te vendre quelque chose.
Vitesse sur les grands modèles. Un modèle 400B local génère des jetons plus lentement que le même modèle sur l'API d'un fournisseur, car ce dernier l'exécute sur du matériel disposant d'une bande passante mémoire quatre à six fois supérieure à la tienne. Tu sacrifies le débit au profit du contrôle.
Douzième partie : Le téléphone dans ta poche
La caractéristique qui fait toute la différence, c'est la mémoire vive (RAM)
Toutes les grandes plateformes ont désormais fixé une limite en matière de mémoire, et cette limite est de 12 Go.
| Plate-forme | Modèle intégré à l'appareil | Porte de mémoire |
|---|---|---|
| Pomme | AFM 3 Core (3 milliards de nœuds denses) + AFM 3 Core Advanced (20 milliards de nœuds clairsemés, 1 à 4 milliards de nœuds actifs) | 12 Go pour deux fonctionnalités d'iOS 27 |
| Gemini Nano v3 (Pixel 10 uniquement) ; Nano v2 sur le Pixel 9 et les modèles antérieurs ; Nano v4 à venir | 12 Go minimum pour Gemini Intelligence | |
| Qualcomm / Samsung | Snapdragon 8 Elite Gen 5 pour Galaxy — processeur Oryon de 3e génération, NPU Hexagon, +39% Capacité NPU | Dépendant du périphérique |
C'est la solution proposée par Apple qui présente le plus d'intérêt sur le plan technique. AFM 3 Core Advanced est un modèle clairsemé de 20 milliards de paramètres stocké sur un support Flash. Les experts partagés restent en mémoire ; les experts acheminés ne sont chargés en DRAM que lorsqu'une requête les sollicite. C'est ainsi qu'il est possible d'intégrer un modèle de 20 milliards d'éléments dans un téléphone : on sacrifie la bande passante de lecture de la mémoire NAND au profit de la capacité de la DRAM.
Mais pour stocker les experts dans la mémoire DRAM, il faut tout de même un endroit où les stocker dans, en plus du système d'exploitation, de l'application en cours d'exécution et du pipeline de la caméra. L'écart entre 9 Go et 12 Go ne correspond pas à une segmentation du marché de trois gigaoctets. Il s'agit du « working set » nécessaire à une gestion experte de la pagination en cas de forte pression sur la mémoire physique. Ming-Chi Kuo indique que deux fonctionnalités d’iOS 27 nécessitent 12 Go : l’expressivité vocale de Siri et la personnalisation du débit, ainsi qu’une amélioration significative de la précision de la reconnaissance vocale. L’iPhone 18 de base, dont la sortie a été repoussée au printemps 2027 et qui disposerait de 9 Go, ne répond pas à ces exigences.
Google est confronté aux mêmes contraintes techniques et à un problème de relations publiques encore plus grave. Gemini Intelligence nécessite Nano v3, or Nano v3 n’est actuellement disponible que sur le Pixel 10 et les appareils Pixel 9 — commercialisés sous une promesse de mise à jour tous les sept ans — utilisent Nano v2. La promesse portait sur les mises à jour. Il n’a jamais été question de fonctionnalités, et la distinction qui semblait logique à un chef de produit en 2023 n’a plus aucun sens pour un client en 2026.
Voici ce qui devrait marquer l'actualité de l'IA grand public au cours des deux prochaines années : une promesse de prise en charge à long terme qui consiste à fournir des correctifs de sécurité à un appareil incapable d'exécuter les fonctionnalités associées à ces correctifs.
Ce qu'un téléphone est réellement capable de faire, mesuré
Tests de performance indépendants réalisés sur un iPhone 17 Pro (A19 Pro) pour quatre durées d'exécution :
| Modèle | Durée d'exécution | Décodage en tok/s | Mémoire maximale |
|---|---|---|---|
| Gemma 4 E2B (4 bits) | LiteRT-LM | 55.4 | 641 Mo |
| Gemma 4 E2B (4 bits) | MLX | 47.5 | 2 900 Mo |
| Gemma 4 E2B (4 bits) | llama.cpp | 37.8 | 3 156 Mo |
| Gemma 4 E2B (4 bits) | CoreML / ANE | 33.4 | 1 187 Mo |
| Qwen 3.5 2B (4 bits) | MLX | 61.2 | 1 279 Mo |
| Qwen 3.5 2B (4 bits) | llama.cpp | 39.1 | 1 479 Mo |
| Qwen 3.5 2B (4 bits) | CoreML / ANE | 27.9 | 241 Mo |
Deux conclusions sautent aux yeux.
Le Neural Engine est la voie la plus lente, mais de loin celle qui utilise le moins de mémoire. 27,9 tok/s à 241 Mo contre 61,2 tok/s à 1 279 Mo pour le MLX : une vitesse cinq fois supérieure pour une mémoire cinq fois plus importante. C’est précisément ce compromis qui explique pourquoi Apple utilise l’ANE pour les fonctionnalités système fonctionnant en permanence et pourquoi les applications tierces ne l’utilisent pas pour les discussions interactives.
Soixante jetons par seconde sur un modèle 2B que tu as dans ta poche, c'est plus rapide que la vitesse de lecture de la plupart des gens. Ce qui signifie que la contrainte qui pèse sur l'IA locale sur mobile n'est pas la vitesse. C'est la capacité ; la capacité dépend des paramètres, les paramètres dépendent de la mémoire — et c'est justement la mémoire que tous les fournisseurs viennent de limiter.
Treizième partie : Le PC et le pari discret de Microsoft
Lors de la conférence Build 2026, le 2 juin, Microsoft a pris une initiative qui, selon moi, prendra davantage d'importance avec le recul qu'elle ne l'a fait le jour même : il a intégré des modèles directement dans Windows.
Guide d'Aion 1.0 Il s'agit d'un petit modèle linguistique destiné à la synthèse, à la réécriture et à l'extraction. Il nécessite un processeur moderne et Windows 11 — pas besoin de NPU ni de carte graphique dédiée. Il est désormais disponible dans Edge Canary à partir de la version 150.0.4070, accessible aux développeurs web via les API Prompt, Summarizer, Writer et Rewriter, et ses poids ouverts ont été publiés sur Hugging Face en juillet 2026.
Plan Aion 1.0 C'est celui-là qui est intéressant : un Modèle de raisonnement et d'appel d'outils comportant 14 milliards de paramètres, avec une fenêtre de contexte de 32K, conçu pour les flux de travail basés sur des agents, la gestion de fichiers et l'orchestration de sous-agents. “ Dans les mois à venir ” au moment de la rédaction de cet article.
Le slogan utilisé par Microsoft était “ une intelligence illimitée pour chaque foyer et chaque bureau ”. Laissons de côté l'aspect marketing et concentrons-nous sur le choix architectural : une API JavaScript dans le navigateur qui interroge un modèle local, sans clé, sans facture et sans connexion réseau. Si cela devient la norme, une vaste catégorie de petites fonctionnalités d'IA cessera d'être un produit SaaS pour devenir une fonctionnalité de la plateforme. Cela aura un impact bien plus important sur l'économie du secteur de l'IA que n'importe quel lancement de modèle individuel cette année.
L'étage dédié au matériel informatique existe bel et bien et exclut de nombreuses machines
La solution NPU nécessite un PC équipé de Copilot+ avec un au moins 40 TOPS NPU:
| Silicium | NPU | Est-ce que ça correspond aux critères ? |
|---|---|---|
| Qualcomm Snapdragon X Elite | 45 HAUTS | ✅ |
| Intel Lunar Lake | 45–48 TOPS | ✅ |
| AMD Ryzen AI 300 / Max+ 395 | 50 HAUTS | ✅ matériel ; logiciels “ à venir ” |
| Intel Meteor Lake | ~10–11 AU MAXIMUM | ❌ |
Et voici le chiffre qui devrait remettre les attentes à zéro : Sur un NPU 45-TOPS, un modèle 8B génère environ 5 tokens par seconde. Le modèle « Plan 14B » sera plus lent.
Cinq tokens par seconde, ce n'est pas une expérience de chat. Cela convient pour un résumé en arrière-plan, une réécriture, une classification, une extraction — c'est-à-dire les tâches pour lesquelles Aion 1.0 Instruct est réellement conçu. Mais cela ne convient pas pour tout ce que l'on regarde en direct.
Pourquoi est-ce si lent sur 45 TOPS ? En effet, la génération de tokens dépend de la bande passante mémoire, et non de la puissance de calcul brute. La NPU est capable d’effectuer les multiplications matricielles ; le problème réside dans le transfert des poids depuis la mémoire système pour chaque token. C’est là le même obstacle qui concerne tous les appareils mentionnés dans cet article, et c’est pourquoi le “ TOPS ” est un indicateur pratiquement inutile lors de l’achat d’un appareil.
Les boîtiers de bureau
Si tu recherches une machine spécialement conçue pour l'inférence locale, la gamme des 128 Go se résume désormais à deux options et une valeur atypique :
| NVIDIA DGX Spark | AMD Ryzen AI Max+ 395 (Strix Halo) | Mac Studio M5 Ultra | |
|---|---|---|---|
| Mémoire | 128 Go unifiés | 128 Go LPDDR5X-8000 | jusqu'à 512 Go unifié |
| Largeur de bande | ~273 Go/s | ~256 Go/s | 1,2 To/s |
| Prix | ~$3,999 | $2 300 – $2 500 | à partir de $5 499 |
| Notes | Écosystème CUDA | Processeur puissant (1,6 TFLOPS au test Linpack contre 708 GFLOPS pour Spark) | Modèle de 512 Go : fin octobre, prix non communiqué |
Ces prix, ainsi que les chiffres concernant les modèles Spark et Strix Halo, proviennent de tests publiés fin décembre 2025 ; il convient donc de les considérer comme indicatifs plutôt qu’actuels, car les prix de la mémoire ont évolué depuis. En matière de génération de jetons, les DGX Spark et Strix Halo sont bien plus proches l’un de l’autre que ne le laissent supposer leurs performances de calcul — car tous deux se situent autour de 256 à 273 Go/s de bande passante, ce qui constitue la contrainte limitante. Le Spark l’emporte haut la main en matière de génération d’images (~120 TFLOPS contre ~46 sur FLUX.1 Dev BF16) et de compatibilité CUDA. Le Strix Halo l’emporte sur le prix et les performances CPU.
Le Mac Studio M5 Ultra se situe dans une catégorie à part, tant en termes de mémoire que de bande passante, et j'ai longuement abordé ce sujet dans le composant matériel d'IA local. En résumé : un modèle de 512 Go à 1,2 To/s est la seule machine grand public capable de contenir en mémoire un modèle de l'ordre de 400 milliards, et le prix à payer pour ce privilège se situe entre environ $16 000 et $20 000, configuration comprise.
Les modèles à exécuter concrètement
| Modèle | Paramètres | Licence | Convient parfaitement à | Idéal pour |
|---|---|---|---|---|
| Gemma 4 E2B | 5,1 milliards / 2,3 milliards d'utilisateurs actifs | Apache 2.0 | 4 Go | Téléphones, toujours allumés, entrée audio |
| Gemma 4 E4B | ~8 milliards | Apache 2.0 | 8 Go | Tâches répétitives sur ordinateur portable, synthèse |
| Guide d'Aion 1.0 | petit SLM | Catégories de poids ouvertes (HF, juillet 2026) | Processeur uniquement | Tâches de traitement de texte natives de Windows |
| Qwen3.8-27B | 27B dense | Apache 2.0 | 24 à 32 Go | Meilleur modèle local polyvalent de moins de 32 Go |
| Gemma 4 26B-A4B | 26B / 4B actifs | Apache 2.0 | 24 Go | MoE rapide, faible coût d'activation |
| Gemma 4 31B | 31B dense | Apache 2.0 | 32 Go | Qualité locale optimale pour les fichiers de moins de 32 Go |
| Ornith-1.5 35B | 35B / 3B actif | MIT | 32 Go | Codage agentique, empreinte active minime |
| gpt-oss-120b | 120B / 5,1B actifs | Apache 2.0 | 128 Go | Le bon compromis à 128 Go |
| Ornith-1.5-397B | 397B Ministère de l'Éducation | MIT | 256 Go+ | Presque la frontière, mais il faut une grosse machine |
| MiniMax M3 | 428B / 23B actifs | Personnalisé | 512 Go | Tient seulement sur un M5 Ultra |
| DeepSeek V4 Pro | 1,6T / 49B actifs | MIT | Cluster | Pas un modèle pour machine grand public |
| Kimi K3 | 2,8T / 104B actifs | Personnalisé | Cluster | Ne tient sur aucun Mac vendu par Apple |
Si tu dimensionnes une machine Apple en particulier, j'ai détaillé les paliers de mémoire dans le guide de l'IA locale du MacBook Pro M5 Pro 64 Go — en bref, 64 Go, c'est le seuil où les compromis cessent d'être pénibles.
Si tu veux une seule recommandation : sur une machine de 32 Go, lance Qwen3.8-27B fido Gemma 4 31B. Les deux sous Apache 2.0, les deux multimodaux, les deux vraiment utiles, les deux tiennent. C'est le choix par défaut de 2026, et un bien meilleur choix par défaut que celui de 2025.
Afficher l'image Ce qui tient vraiment, par palier de mémoire. Les traits verticaux marquent les tailles de mémoire qu'on peut réellement acheter ; les modèles qui débordent du trait de droite sont le plafond de l'IA de pointe locale en 2026.
Partie quatorze : le mur de la mémoire, c'est toute l'histoire
Tout ce qui est dans l'acte III revient à une seule équation, alors la voici explicitement.
Est-ce que ça tient ?
poids (Go) ≈ total_params (B) × octets_par_paramètre
             4 bits  → × 0,5
             8 bits  → × 1,0
             BF16    → × 2,0

disponible ≈ (mémoire système × 0,75) − surcoût OS et applications − cache KV
À quelle vitesse va-t-il générer ?
tokens/s ≈ (bande passante mémoire × efficacité) ÷ octets actifs par tokenNote que la seconde formule raisonne en paramètres actifs , pas le total. C’est pourquoi les modèles à mélange d’experts sont si disproportionnellement bons sur du matériel grand public. Le 26B-A4B de Gemma 4 a 26 milliards de paramètres de capacité et 4 milliards de paramètres de coût par token. Le 35B d'Ornith-1.5 active 3B. MiniMax M3 compte 428B au total et 23B actifs.
Dans cette formule, l'efficacité se situe en pratique entre 0,5 et 0,8 selon le moteur d'exécution, la quantification et la part de bande passante mémoire que le reste du système utilise.
Maintenant, applique-la. Un portable avec un NPU de 45 TOPS et de la LPDDR5X à, disons, 120 Go/s, qui fait tourner un modèle 8B en 4 bits (4 Go de poids actifs) : 120 × 0,6 ÷ 4 ≈ 18 tokens par seconde en théorie. En pratique, on mesure environ 5. L'écart tient à l'ordonnancement, à la contention mémoire, au coût du prefill et au fait que les chaînes d'outils NPU sont encore immatures. C'est dans cet écart entre le calcul et la mesure que logent la plupart des déceptions du domaine.
La pénurie de DRAM est la variable cachée derrière chaque chiffre de cet article
Les fabricants de mémoire ont passé 2025 et 2026 à réaffecter leurs capacités vers les clients des centres de données IA, qui signent des contrats plus gros et mieux margés que les fabricants d'appareils grand public. Les conséquences se voient partout :
- Apple a augmenté les prix de ses Mac et iPad en juin 2026.
- Le palier 512 Go du Mac Studio a glissé à fin octobre pour des raisons d'approvisionnement et reste sans prix.
- Le M6 d’Apple plafonne à 32 Go de mémoire unifiée, et les M6 Pro, Max et Ultra ont été purement annulés.
- Ming-Chi Kuo a rapporté qu'Apple réduisait ses livraisons de matériel 2026 à cause de l'approvisionnement en mémoire.
Chaque plafond cité dans cet article remonte à la même pénurie. Le seuil des 12 Go sur téléphone. Le plafond des 32 Go du M6. Le plafond des 128 Go sur portable. Le palier 512 Go reporté. Aucun n'est une limite technique du silicium ; tous sont des décisions d'allocation dans un marché où la mémoire est rare et chère.
Si tu attends que les prix se normalisent pour acheter une machine d'inférence locale : personne de crédible ne prévoit quand cela arrivera.
Partie quinze : passer à la pratique
La partie pratique. Tout ce qui suit, je l'ai fait tourner ; quand je rapporte au lieu d'exécuter, je le dis.
La voie la plus simple : LM Studio
Une interface graphique, native MLX sur Apple Silicon, un navigateur de modèles intégré, un serveur compatible OpenAI activable d'un bouton. Si tu veux faire tourner un modèle en dix minutes, commence ici. C'est aussi l'outil contre lequel Apple se compare dans ses propres communiqués de presse, ce qui en dit long sur le point où c'est devenu grand public.
La voie la plus souple : Ollama
bash
# Install
curl -fsSL https://ollama.com/install.sh | sh

# Pull and run the 2026 default
ollama run qwen3.8:27b

# The context default is too small for real code work — raise it
OLLAMA_CONTEXT_LENGTH=65536 ollama serve
C'est la deuxième commande que tout le monde oublie. Le contexte par défaut d’Ollama est réglé de façon prudente ; sur une tâche de code, il tronquera sans rien dire et tu en voudras au modèle.
La voie la plus rapide sur Apple Silicon : MLX
bash
pip install --upgrade mlx-lm

# Générer directement
mlx_lm.generate \
  --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explique en deux paragraphes le routage des modèles à mélange d'experts." \
  --max-tokens 512

# Ou servir un point de terminaison compatible OpenAI
mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
Pointe n'importe quel client compatible OpenAI vers http://localhost:8080/v1.
Augmente la limite de mémoire câblée avant de te plaindre des plantages
Par défaut, macOS ne laisse pas le GPU câbler toute ta mémoire unifiée. Sur une machine à grande mémoire, c'est la différence entre un modèle qui charge et un modèle qui échoue :
bash
# Check the current limit
sysctl iogpu.wired_limit_mb

# Example for a 128 GB machine, leaving ~14 GB for the OS
sudo sysctl iogpu.wired_limit_mb=116736

# Persist it
echo "iogpu.wired_limit_mb=116736" | sudo tee -a /etc/sysctl.conf
Ne la règle pas sur la totalité de ta mémoire. Laisse 12–16 Go à l'OS sur une grosse machine, sinon tu auras des kernel panics au lieu d'une inférence rapide. Et vérifie à nouveau après chaque mise à jour de macOS, parce qu'elles réinitialisent la valeur.
Sous Windows, commence par les modèles de l'OS
Avant d'installer quoi que ce soit, regarde ce que Windows te donne déjà. Les API Prompt, Summarizer, Writer et Rewriter d'Edge appellent Aion 1.0 Instruct en local, sans clé et sans facture. Pour résumer, réécrire et extraire dans une application web, c'est une solution complète avec zéro infrastructure.
javascript
// Edge Canary 150.0.4070+ — runs entirely on device
const summarizer = await Summarizer.create({ type: "key-points" });
const summary = await summarizer.summarize(longText);
S'il te faut plus que ça, LM Studio et Ollama tournent très bien sous Windows, et sur une machine sans NPU éligible ils utiliseront le GPU ou le CPU, ce qui pour les modèles de la classe 8B est souvent plus rapide que le chemin NPU, de toute façon.
Une configuration hybride sensée
L'architecture que je construirais vraiment, et à peu près ce que je fais tourner :
- Niveau 1 — sur l'appareil. Un petit modèle pour le routage, la classification, l'extraction, le résumé, la dictée. Gemma 4 E4B ou Aion 1.0 Instruct. Toujours disponible, coût marginal nul.
- Niveau 2 — ton propre matériel. Un modèle à poids ouverts de 27B à 120B sur une machine qui t'appartient, pour tout ce qui touche des données clients qui ne doivent pas sortir du territoire. Qwen3.8-27B sur 32 Go,
gpt-oss-120bsur 128 Go. - Niveau 3 — la pointe via API. La planification, le raisonnement difficile, les longues sessions agentiques, tout ce pour quoi se tromper coûte cher.
Le débat n'est jamais “local ou cloud”. La question, c'est où tu traces les lignes, et les lignes ont beaucoup bougé cette année.
Partie seize : le calcul des coûts et de la conformité
L'argument des économies ne résiste pas à une calculatrice
Prends une charge réaliste de petite entreprise : un mois de travail de codage agentique modéré, disons 40 millions de tokens en entrée et 3 millions en sortie.
| Option | Coût mensuel |
|---|---|
| API GLM-5.3-Flash (0,15 $ / 0,47 $) | ~$7.40 |
| API Gemini 3.8 Flash (0,75 $ / 3,75 $) | ~$41 |
| API Claude Opus 5 (5 $ / 25 $) | ~$275 |
| API Claude Fable 5.1 (10 $ / 50 $, sans cache) | ~$550 |
| Une machine Strix Halo à 2 400 $, amortie sur 3 ans | ~67 $/mois + électricité |
Note bien ce que dit vraiment ce tableau. Le matériel local coûte moins cher que le haut de la frontière et plus cher que son bas de gamme. Face à GLM-5.3-Flash, une machine locale n'atteint jamais l'équilibre sur le prix des tokens. Face à Fable 5.1 sans cache, elle s'amortit en cinq mois — mais tu ne compares pas des choses comparables, parce que Fable 5.1 est un modèle bien meilleur que tout ce qui tient dans 128 Go.
Donc n'achète pas de matériel local pour économiser. Achète-le pour l'une de ces cinq raisons, toutes réelles :
- La résidence des données comme décision d'architecture plutôt que comme projet juridique.
- Pas de limites de débit, pas de quotas, pas d'incidents de capacité. Ta machine ne connaît pas de mardi chargé.
- Un épinglage de version définitif. Un checkpoint local est identique à l'octet près un an plus tard.
- Le fonctionnement hors ligne.
- Il te fallait de toute façon la station de travail. C'est le cas le plus fréquent où acheter est simplement la bonne décision — si tu allais déjà dépenser 2 500 € dans une machine, le coût marginal de la capacité IA, c'est l'extension de mémoire, pas la machine entière.
Le paysage de la conformité européenne, parce qu'il a changé en 2026
Pour les lecteurs en Allemagne et dans l'UE, le terrain réglementaire a bougé cette année et les dates sont désormais fixes plutôt que conditionnelles.
- 2 août 2025 — les fournisseurs de modèles GPAI ont assumé les obligations de documentation, de résumé du contenu d'entraînement et de droits d'auteur.
- 2 août 2026 — les pouvoirs de sanction et les obligations de transparence de l'article 50 sont entrés en application. Les amendes sont désormais applicables.
- 27 juillet 2026 — le Digital Omnibus, règlement (UE) 2026/1744, est entré en vigueur, remplaçant le mécanisme conditionnel antérieur pour les systèmes à haut risque par des dates fermes.
- 2 décembre 2026 — fin de la période de grâce pour le filigrane lisible par machine sur les systèmes existants.
- 2 août 2027 — la fenêtre de transition de deux ans se referme pour les modèles GPAI déjà commercialisés.
- 2 décembre 2027 — les systèmes à haut risque autonomes relevant de l'annexe III (recrutement, notation de crédit, éducation, infrastructures critiques).
- 2 août 2028 — l'IA à haut risque intégrée à des produits réglementés relevant de l'annexe I (dispositifs médicaux, machines).
Le Digital Omnibus a aussi ajouté des interdictions sur les images intimes non consenties générées par IA et sur les contenus pédocriminels (CSAM), et élargi les pouvoirs de supervision de l’EU AI Office.
Ce que cela signifie concrètement pour les lecteurs de cet article. Si tu construis sur des modèles au lieu de les entraîner, la plupart des obligations GPAI incombent au fournisseur, pas à toi. Ce qui te revient, c'est la transparence — dire aux gens quand ils interagissent avec l’IA, et signaler les contenus synthétiques — plus la question de la classification à haut risque si ton système touche au recrutement, au crédit, à l'éducation ou aux infrastructures critiques. La date de décembre 2027 est assez lointaine pour être planifiée et assez proche pour que “on verra plus tard” ne soit plus une stratégie.
Et le point le plus pertinent pour l'acte III : un modèle embarqué simplifie concrètement plusieurs de ces conversations d'un coup. Pas de transfert, pas de sous-traitant, une carte des flux de données bien plus courte. Ce n'est pas une faille — les obligations de transparence s'appliquent toujours — mais cela supprime toute une catégorie de travail.
Je ne suis pas juriste et ceci n'est pas un conseil juridique. Pour tout ce qui engage de l'argent, fais examiner ton déploiement précis par un conseiller qualifié en Allemagne ou dans l'UE.
Partie dix-sept : l'argument honnête contre tout ça
Si je m'arrêtais à la partie seize, ce serait une publicité.
Les mesures de productivité ne justifient toujours pas l'enthousiasme. Un essai contrôlé randomisé, 19 % plus lent. Une réplication impossible à mener proprement. Des auto-évaluations gonflées de 40 points de pourcentage. Tout le monde dans ce secteur, moi compris, fonctionne largement à l'intuition sur des intuitions.
Les données de sécurité sont mauvaises et ne s'améliorent pas. Le taux d’échec OWASP de 45 % relevé par Veracode est resté globalement inchangé jusqu'au début 2026, alors que les modèles devenaient bien plus intelligents. Ce n'est pas un problème transitoire que l'échelle corrigera. Capacité et sécurité ne sont pas le même axe, et personne n'optimise sérieusement le second.
Les benchmarks sont saturés en haut et invérifiables au milieu. Sur SWE-bench Verified, trois modèles se tiennent à un point d'écart. Les benchmarks qui le remplacent sont de plus en plus privés, ce qui règle la contamination en rendant toute vérification indépendante impossible.
Les poids ouverts sont à une révision de licence de ne plus être ouverts. Z.ai a fait passer GLM de MIT à une licence propriétaire avec un contrôle de sécurité entre 5.2 et 5.3. Meta a promis des poids ouverts pour Muse Spark sans date, sans taille et sans texte de licence. Si ton architecture suppose des poids téléchargeables l'an prochain, cette supposition relève d’une décision commerciale d'un éditeur, pas d'une loi de la nature.
La frontière n'est toujours pas locale, et elle devient aussi de moins en moins achetable. Mythos 5.1, le meilleur score sur Terminal-Bench 4.0, est réservé à des cyberdéfenseurs et des spécialistes des sciences du vivant déjà contrôlés, aujourd'hui surtout aux États-Unis. Kimi K3 et DeepSeek V4 Pro ne tiennent sur aucune machine grand public. Ce qui tient sur ton bureau, c'est un excellent modèle de deuxième division : c'est une chose vraiment utile à être, et ce n'est pas la frontière.
Les performances embarquées sont pires que le marketing ne le laisse croire. Cinq tokens par seconde pour un modèle 8B sur un NPU de 45 TOPS. Un seuil de 12 Go de mémoire qui exclut la plupart des téléphones en circulation. Une promesse de sept ans de mises à jour qui ne couvre pas les fonctionnalités. L'écart entre le badge “AI PC” et ce que la machine sait réellement faire est aujourd'hui énorme.
Et la géopolitique est un critère d'achat, que tu le veuilles ou non. Plusieurs des meilleurs modèles à poids ouverts — Kimi, GLM, DeepSeek, Qwen, MiniMax — viennent de laboratoires chinois. Pour le secteur public, la défense et certains clients régulés, c'est un obstacle dirimant, peu importe où tournent les poids ou ce que dit la licence. En face, le modèle de codage le plus capable d'Anthropic est réservé à des organisations américaines contrôlées. L'écosystème ouvert est déchiré le long des lignes nationales, par les deux bouts, et si tu es en Europe, tu n'es à aucun des deux bouts.
Partie dix-huit : la grille de décision pour l'état de l'IA en 2026
Afficher l'image Sept situations, sept réponses. Trouve la ligne qui ressemble à ton année.
Sept situations, rapportées à l'état de l'IA en 2026 tel qu'il se présente vraiment aujourd'hui.
1. “Je veux le meilleur modèle et le prix n'est pas un problème.”
Claude Fable 5.1 à 65,7 sur l'indice agrégé, 10/50 $, 1 M de contexte — et active le cache, parce que la réduction de 75 % sur la lecture du cache vaut 25–45 % de ta facture. Garde GPT-5.6 Sol disponible pour la recherche à forte composante navigation, à 90,4 % sur BrowseComp. Ne te torture pas l'esprit : l'écart entre eux est plus petit que celui entre ton meilleur et ton pire prompt.
2. “Je fais tourner beaucoup d'agents et la facture devient ridicule.”
Claude Opus 5 à 5/25 $ pour le travail de longue haleine, GLM-5.3-Flash à 0,15/0,47 $ pour le travail mécanique en volume, et un modèle local pour la besogne. Le routage est le plus gros levier de coût à ta disposition, et c'est un fichier de config, pas un projet. Mesure la répartition de tes tokens par rôle d'agent avant d'optimiser quoi que ce soit — la plupart des gens découvrent que 80 % de leurs dépenses vont à des tâches qui n'avaient pas besoin d'un modèle de pointe.
3. “Le GDPR et la résidence des données sont des exigences fermes pour le travail client.”
Qwen3.8-27B ou Gemma 4 31B sur du matériel qui t'appartient, les deux sous Apache 2.0, les deux multimodaux. Monte à gpt-oss-120b sur une machine de 128 Go si le travail l'exige. Le but n'est pas la vitesse — c'est qu'aucun prompt ne quitte le bâtiment et que ta revue juridique devienne une lecture de licence au lieu d'une analyse d'impact des transferts. Choisis exprès des modèles sous licence permissive pour que cette lecture soit courte.
4. “Je veux essayer l'IA locale sans trop dépenser.”
Ce que tu possèdes déjà, plus LM Studio, plus Gemma 4 E4B. Huit gigaoctets de mémoire suffisent pour être vraiment utile. Découvre si l'IA locale est pour toi avant d'y mettre de l'argent — la plupart des gens découvrent qu'ils veulent le niveau 1 et le niveau 3 et n'ont jamais eu besoin du niveau 2.
5. “J’achète une machine exprès pour l'inférence locale.”
Achète sur la bande passante mémoire et la capacité, dans cet ordre, et ignore les TOPS. Dans la classe 128 Go, Strix Halo à ~2 400 $ est le meilleur rapport qualité-prix et DGX Spark à ~3 999 $ t'achète CUDA et une génération d'images bien meilleure. Au-dessus, le Mac Studio M5 Ultra est la seule machine qui tient un modèle 400B, à un prix qui n'a de sens que si tu avais de toute façon besoin de la station de travail.
6. “Mon équipe adopte des outils de codage IA et c'est moi qui porte le risque.”
Fais les choses ennuyeuses, dans cet ordre : SAST et détection de secrets à chaque commit ; analyse de composition logicielle pour les paquets hallucinés ; une politique écrite excluant le code IA non relu de l'authentification, de la crypto, des autorisations et des paiements ; des identifiants d'agents traités comme privilégiés ; et un SBOM qui trace la provenance des outils. Attends-toi ensuite à un courbe en J — DORA a mesuré une vraie baisse avant le gain — et ne panique pas au troisième mois.
7. “Quel téléphone acheter pour l'IA ?”
N'importe quel modèle à 12 Go. C’est la ligne que toutes les plateformes ont tracée : iPhone 17 Pro et 18 Pro à 12 Go, Pixel 10 pour Nano v3, Galaxy S26 Ultra sur Snapdragon 8 Elite Gen 5. L'iPhone 18 de base, à 9 Go selon les rumeurs, et le Pixel 9 et les modèles plus anciens feront très bien tourner le téléphone et n'auront pas les fonctionnalités. Si tu es déjà sur un appareil à 12 Go, la mise à niveau de cette année est incrémentale, spécifiquement pour l'IA.
Partie dix-neuf : ce que je surveille au prochain trimestre
La livraison effective des poids de Muse Spark par Meta, et la licence qu’il choisira. “Bientôt” de la part d'un CEO sur X, sans nombre de paramètres ni texte de licence, c'est la forme d'engagement la plus faible de cet article. S'ils publient sous Apache 2.0, cela change matériellement l'écosystème ouvert. S'ils publient sous une licence sur mesure avec un seuil de chiffre d'affaires, c'est désormais la norme du secteur et les poids ouverts deviennent une catégorie marketing plutôt qu'une propriété.
La réplication du résultat d'auto-amélioration d'Ornith-1.5. Une évaluation indépendante sur des tâches hors du programme auto-généré est ce qui trancherait. C'est l'élément à plus forte variance de la liste : c'est soit le résultat le plus important de 2026, soit un récit d'avertissement sur les benchmarks auto-générés, et je ne sais pas encore lequel.
La sortie réelle d'Aion 1.0 Plan, et sa vitesse d'exécution. Un modèle de raisonnement 14B dans Windows, c'est une catégorie vraiment nouvelle. S'il tourne à 3 tokens par seconde sur du matériel éligible, c'est une démo. S'il tourne à 20, cela change ce qu'une application de bureau peut supposer.
La courbe d'attribution des CVE. 6, 15, 35 sur trois mois consécutifs. Si avril à août ont poursuivi cette trajectoire, les données de Georgia Tech seront la publication sur la sécurité de l'IA la plus lourde de conséquences de l'année quand elles sortiront.
La construction effective de l'outillage de revue. L'écart entre ce que les agents savent produire et ce que les humains savent vérifier est le problème déterminant de 2027, et à ce jour presque tout l'argent du capital-risque va encore à la génération plutôt qu'à la vérification. Celui qui livrera l'outil qui te dit de façon fiable quels 5 % d'un diff ont besoin d'yeux humains sera très difficile à concurrencer.
La détente de la pénurie de mémoire. C'est la variable cachée derrière le seuil des 12 Go sur téléphone, le plafond des 32 Go du M6, le palier 512 Go des Mac reporté et la hausse des prix Apple de juin. Personne de crédible n'annonce d'accalmie.
Et de savoir si les modèles de pointe filtrés pour raison de sécurité restent une exception. Mythos 5.1 est filtré pour des raisons de double usage que je trouve défendables, et Project Glasswing élargit activement l'accès — environ 150 organisations dans plus de quinze pays en juin 2026. Mais le précédent est posé : le meilleur score sur un benchmark de codage public est désormais quelque chose que la plupart des organisations ne peuvent acheter à aucun prix. Si cela devient un schéma plutôt qu'un cas particulier, “mon organisation peut-elle être validée” devient un critère de choix de modèle, et l'argument en faveur des poids ouverts hors des États-Unis cesse d'être une question de coût.
Foire aux questions
Quel est le meilleur LLM en septembre 2026 ?
Sur l'agrégat, Claude Fable 5.1 mène l'Intelligence Index v4.1.1 d’Artificial Analysis à 65,7, devant Claude Opus 5 à 63,0, Claude Fable 5 à 62,1, Grok 4.6 à 60,9 et GPT-5.6 Sol à 58,9. Mais l'agrégat écrase les différences qui comptent. GPT-5.6 Sol mène la navigation à 90,4 % sur BrowseComp ; Gemini 3.8 Flash donne 58,7 à 0,75 $ le million de tokens en entrée ; GLM-5.3-Flash donne 57,5 à 0,15 $. Pour la plupart des charges réelles, les huit premiers modèles sont interchangeables et la décision doit se faire sur le prix, la latence, l'économie du cache et la licence plutôt que sur le classement.
Quel est le meilleur modèle à poids ouverts en ce moment ?
Cela dépend de ton matériel et de ta tolérance aux licences. GLM-5.3 (753B) obtient le meilleur score à 59,5 mais porte une licence sur mesure avec un contrôle de sécurité au-delà de 10 milliards de dollars de chiffre d'affaires. DeepSeek V4 Pro (1,6T au total, 49B actifs) est sous licence MIT et obtient 87,9 sur Terminal-Bench 2.1, mais exige un cluster. Pour une machine qui t'appartient vraiment, Qwen3.8-27B ou Gemma 4 31B — les deux sous Apache 2.0 — sont les meilleurs modèles qui tiennent dans 32 Go.
Le vibe coding est-il mort en 2026 ?
Le mot se meurt ; la pratique s'est scindée en deux. Le vibe coding au sens d'origine — prompt, accepter, ne pas lire le diff — reste valable pour le travail jetable : scripts, prototypes, analyses ponctuelles. Ce qui l'a remplacé pour tout ce qui part en production, c'est l'ingénierie agentique pilotée par spécification : une spécification écrite, un bac à sable, une suite de tests que l'agent doit passer et une vraie revue du diff produit. Le milieu dangereux — du code de production non relu — est d'où viennent tous les incidents documentés de 2026.
Le codage IA rend-il vraiment les développeurs plus rapides ?
Le seul essai contrôlé randomisé dit non. METR a constaté que des développeurs expérimentés étaient 19 % plus lents avec les outils IA du début 2025 sur des bases de code matures, tout en croyant avoir été 20 % plus rapides — une surestimation de 40 points de pourcentage. Leur réplication de 2026 n'a pas pu être menée proprement, car les développeurs ont refusé de travailler sans IA. Les enquêtes rapportent un facteur 3 sur la vitesse, mais seulement 1,4 à 2 fois sur la valeur du travail. Ma lecture : de gros gains sur le travail inconnu, le code répétitif, les tests et les migrations ; des gains faibles ou négatifs sur les bases de code que tu connais intimement.
Quel est le risque du code généré par IA ?
Risqué de façon mesurable, et lent à s'améliorer. Veracode a trouvé que 45 % des échantillons générés par IA introduisent une vulnérabilité du Top 10 OWASP, le Java étant le pire à 72 %. Apiiro a mesuré des développeurs assistés par IA produisant des commits 3 à 4 fois plus vite et des constats de sécurité 10 fois plus vite, avec des chemins d'élévation de privilèges en hausse de 322 %. Environ 20 % du code généré par IA référence des paquets qui n'existent pas, et 43 % de ces noms hallucinés reviennent de façon récurrente — ce qui constitue une surface d'attaque de la chaîne d'approvisionnement. La solution, ce sont des barrières automatisées à chaque commit, pas l'abstinence.
Est-ce que tu peux faire tourner un bon LLM hors ligne sur ton propre ordinateur ?
Oui, et 2026 est la première année où c'est vrai sans ambiguïté. Avec 8 Go de mémoire, Gemma 4 E4B est vraiment utile. Avec 32 Go, Qwen3.8-27B ou Gemma 4 31B sont de solides modèles multimodaux sous Apache 2.0. Avec 128 Go, gpt-oss-120b est le bon compromis. Ce qui ne tient sur aucune machine grand public, c'est la vraie pointe : Kimi K3 à 2 800 milliards de paramètres et DeepSeek V4 Pro à 1 600 milliards ont tous deux besoin d'un cluster.
Qu'est-ce que Microsoft Aion 1.0 ?
Une famille de modèles embarqués annoncée à Build le 2 juin 2026 et livrée dans Windows 11. Aion 1.0 Instruct est un petit modèle de résumé, de réécriture et d'extraction qui tourne sur un CPU moderne sans NPU, exposé via les API JavaScript Prompt, Summarizer, Writer et Rewriter d’Edge, avec des poids ouverts sur Hugging Face depuis juillet 2026. Aion 1.0 Plan est un modèle de raisonnement et d'appel d'outils de 14 milliards de paramètres avec une fenêtre de contexte de 32K pour les flux de travail agentiques, qui exige un Copilot+ PC avec un NPU de 40 TOPS minimum, et qui était encore “dans les prochains mois” début septembre 2026.
Pourquoi les téléphones ont-ils besoin de 12 Go de RAM pour les fonctions IA ?
Parce que les modèles embarqués sont limités par la mémoire, pas par le calcul. L’AFM 3 Core Advanced d'Apple est un modèle clairsemé de 20 milliards de paramètres qui vit dans le stockage flash et échange les experts routés vers la DRAM à la demande — ce qui demande encore de la place pour les échanger, en plus de l'OS, de l'app et du pipeline caméra. Ming-Chi Kuo rapporte deux fonctions d'iOS 27 exigeant 12 Go. Le Gemini Intelligence de Google impose le même minimum de 12 Go. L'écart entre 9 Go et 12 Go, c’est l'ensemble de travail, pas de la segmentation marketing.
Un NPU vaut-il la peine pour l'IA locale ?
Moins que le marketing ne le suggère. Sur un NPU de 45 TOPS, un modèle 8B génère environ 5 tokens par seconde, parce que la génération de tokens est limitée par la bande passante mémoire plutôt que par le calcul. Les NPU sont excellents pour les tâches permanentes, à faible consommation et en courtes rafales — celles qu'un système d'exploitation exécute en continu. Pour du chat interactif sur un portable, le GPU ou même le CPU est souvent plus rapide. Achète sur la bande passante mémoire et la capacité ; considère les TOPS comme presque sans valeur pour choisir.
Les modèles à poids ouverts sont-ils vraiment open source ?
En grande partie non. DeepSeek V4 Pro (MIT), Qwen3.8 (Apache 2.0), Gemma 4 (Apache 2.0) et Ornith-1.5 (MIT) portent des licences réellement permissives. GLM-5.3 impose aux entreprises dépassant 10 milliards de dollars de chiffre d'affaires de passer la revue de sécurité de Z.ai ; Kimi K3 utilise une licence par paliers de revenus ; MiniMax M3 exige une mention bien visible “Built with MiniMax M3” pour tout usage commercial et une autorisation écrite au-delà de 20 millions de dollars de revenus. Aucun d’entre eux ne publie ses données d'entraînement ni son code d'entraînement. “Poids ouverts” est le terme exact ; “open source” fait un travail malhonnête.
Est-ce moins cher de faire tourner les modèles en local que de passer par une API ?
Presque jamais sur le seul coût des tokens. Un mois modéré de travail agentique — 40 M de tokens en entrée et 3 M en sortie — coûte environ 7 $ sur GLM-5.3-Flash et environ 41 $ sur Gemini 3.8 Flash. Une machine locale à 2 400 $ amortie sur trois ans revient à environ 67 $ par mois hors électricité. Le matériel local bat le haut de la frontière sur le coût et perd contre son bas. Achète local pour la résidence des données, la liberté de débit, l'épinglage de version et le fonctionnement hors ligne — ou parce qu'il te fallait de toute façon la station de travail.
Que demande l'AI Act européen en 2026 ?
Depuis le 2 août 2026, les pouvoirs de sanction et les obligations de transparence de l'article 50 s'appliquent à l'IA à usage général, et les amendes sont désormais possibles. Le Digital Omnibus, règlement (UE) 2026/1744, est entré en vigueur le 27 juillet 2026 et a fixé des dates fermes : le 2 décembre 2026 met fin à la période de grâce sur le filigrane ; le 2 août 2027 clôt la transition pour les modèles GPAI déjà sur le marché ; le 2 décembre 2027 s'applique aux systèmes à haut risque autonomes de l'annexe III ; le 2 août 2028 couvre l'IA à haut risque intégrée à des produits réglementés. Si tu construis sur des modèles au lieu de les entraîner, la plupart des obligations GPAI incombent au fournisseur — ce qui te revient, c'est la transparence et la question de la classification à haut risque. Ceci n'est pas un conseil juridique.
Combien de temps un agent IA peut-il travailler sans surveillance ?
METR mesure la longueur de tâche qu'un modèle mène seul avec 50 % de réussite. Ce chiffre est passé d’environ 30 secondes en 2022 à plus de 14 heures pour les systèmes de pointe en 2026, avec un temps de doublement d’environ 196 jours selon l'ajustement hybride de METR, ou 131 jours si on se limite aux modèles postérieurs à 2023. Les intervalles de confiance sont très larges — l’horizon de 320 minutes de Claude Opus 4.5 va de 170 à 729 minutes — et seules 5 des 31 tâches longues de METR utilisent des références humaines mesurées. Extrapolé, cela donne environ une journée de travail de longueur de tâche autonome en 2027.
Quel modèle choisir pour coder, précisément ?
Route plutôt que de choisir. La planification et l'architecture au modèle le plus capable que tu peux te payer (Claude Fable 5.1) ; le gros de l'implémentation longue à Claude Opus 5 à moitié prix ; le travail mécanique en volume à GLM-5.3-Flash à 0,15/0,47 $ ; tout ce qui touche des données clients à un modèle local à poids ouverts ; et les renommages, docstrings et corrections de lint à un petit modèle local. Écris les identifiants de modèles de façon qu'en remplacer un soit une modification d'une ligne — quatre laboratoires ont livré un modèle du top 10 entre juin et septembre 2026.
En résumé
Il y a douze mois, la question intéressante en IA était de savoir quel modèle était le plus intelligent. L'état de l'IA en 2026, c'est que cette question est devenue presque inintéressante. Les dix premiers modèles tiennent dans 8,2 points sur le meilleur agrégat disponible, et le moins cher d'entre eux coûte un soixante-septième du plus cher.
Ce qui l'a remplacée est plus utile et moins excitant : peux-tu vérifier ce que ces choses produisent, assez vite pour les suivre ?
Cette seule question explique chacun des constats de cet article. Elle explique pourquoi SWE-bench s'est saturé à 96 % et a cessé d'être informatif. Elle explique pourquoi l'adoption des outils de codage IA a atteint 90 % alors que la confiance tombait à 29 %. Elle explique pourquoi le taux d’échec de sécurité de Veracode n'a pas bougé pendant que les capacités grimpaient, parce que capacité et vérifiabilité sont deux axes différents et qu'un seul est optimisé. Elle explique pourquoi DORA a constaté que les gains viennent de l'organisation plutôt que de l'outil. Et elle explique pourquoi la pratique qui marche vraiment en 2026 — spécification, bac à sable, barrière de tests, vraie revue — paraît tellement moins magique que les démos.
Quatre choses que j'en retiens.
La pointe s'est banalisée plus vite que prévu, et l'écart des poids ouverts est désormais d'environ six mois. Un modèle de 397B sous licence MIT bat la frontière fermée de la génération précédente sur SWE-bench. Un modèle à poids ouverts de 753B dépasse GPT-5.6 Sol sur l’indice agrégé. Planifie un monde où le modèle n'est pas ton facteur différenciant, parce que ce n'est presque déjà plus le cas.
Lis la licence avant le benchmark. La capacité converge ; les conditions divergent. Z.ai s'est éloigné de MIT entre deux versions. Meta a promis des poids sans texte de licence. Le meilleur modèle de codage d’Anthropic est filtré par nationalité. Pour un acheteur commercial, quatre points de benchmark valent moins qu'une licence que ton avocat lit en quatre-vingt-dix secondes.
La vérification, c'est tout le jeu désormais, et presque personne ne la finance. Les agents produisent une journée de travail ; on la relit avec des outils conçus pour relire une heure de travail. Si tu choisis où mettre ton effort d'ingénierie dans les douze prochains mois, mets-le dans les tests, les spécifications et l'outillage de revue plutôt que dans la technique de prompt. La technique de prompt se déprécie à chaque sortie de modèle. L'infrastructure de vérification, elle, se cumule.
Et l'IA hors ligne est devenue réelle, sur un budget mémoire qui vient de devenir cher. Un modèle multimodal de 27 milliards de paramètres sous licence Apache tourne sur une machine à 2 500 €. Windows embarque un modèle dans le système d'exploitation. Ton téléphone fait tourner un modèle clairsemé de 20 milliards de paramètres depuis la flash. Chaque plafond là-dessus — le seuil des 12 Go sur téléphone, le plafond des 32 Go sur portable, le plancher des 40 TOPS — est une décision d'allocation de mémoire dans un marché où la DRAM est rare, pas une limite du silicium.
La configuration que je monterais vraiment aujourd'hui : Gemma 4 E4B sur l'appareil pour le niveau toujours actif ; Qwen3.8-27B sur ton propre matériel pour tout ce qui ne doit pas quitter le bâtiment ; GLM-5.3-Flash à 0,15/0,47 $ pour le milieu à fort volume ; et Claude Opus 5 ou Fable 5.1 pour la planification et les problèmes vraiment difficiles, avec le cache activé. Route entre eux dans un fichier de config, et prépare-toi à réécrire ce fichier dans trois mois.
Reviens là-dessus en décembre. Meta aura livré des poids ou non. Aion 1.0 Plan sera réel ou du vent. Le résultat d'auto-amélioration d'Ornith se sera reproduit ou aura discrètement disparu. Et la courbe d'attribution des CVE nous aura dit si 2026 a été l'année où le secteur a resserré ses propres barrières ou celle où il a attendu que quelqu'un d'autre le fasse.
Tu fais tourner des modèles à poids ouverts en production dans l'UE, ou tu fais passer du code écrit par des agents par un processus de revue auquel tu fais vraiment confiance ? Deux choses m'intéressent particulièrement : des répartitions de coût par token mesurées par rôle d'agent, et tout ce qui marche pour relire des diffs d'agent de mille lignes. Corrections et contre-preuves bienvenues — cet article est mis à jour quand la situation change.
Dernière mise à jour : 3 septembre 2026.