العربية
 English
 Deutsch
 Español
 Italiano
 Français
 Português do Brasil
 Tiếng Việt
 ไทย
 Bahasa Indonesia
 Русский
 हिन्दी

تم تمويل بحث هذا المقال من GrahamMiranda.com. وقد أصبحت النسخ الاحترافية التي اختُبرت خلال هذا التحليل ممكنة بفضل دعمهم.
جدول المحتويات
- مشهد نماذج الذكاء الاصطناعي في نوفمبر 2025: ما الذي تغيّر
- ثورة الطبقة المجانية: أي نماذج ذكاء اصطناعي لا تكلّف شيئًا فعلاً
- فهم هياكل الأسعار: اقتصاديات الطبقة الاحترافية
- تفصيل معايير القياس: ماذا تعني هذه الدرجات فعلاً
- الأداء في العالم الحقيقي: أين يتفوّق كل نموذج فعلاً
- لعبة أسعار API: أين تهمّ الاقتصاديات الحقيقية
- تمييز الميزات: ما الذي يفصل هذه النماذج حقًا
- تحليل التكلفة والعائد: أي نموذج ذكاء اصطناعي تختار فعلاً؟
- المجاني مقابل الاحترافي: الفرق الحقيقي في 2025
- نظرة إلى الأمام: ما القادم في أواخر 2025
- الخاتمة: اتخاذ قرارك
بينما ندخل الأشهر الأخيرة من 2025، تغيّر مشهد الذكاء الاصطناعي تغيّرًا جذريًا. فما بدأ سباقًا بين طرفين، OpenAI وGoogle، تطوّر إلى منظومة شديدة التنافس تضم سبعة منافسين كبار، يقدّم كل منهم طبقات مجانية ومدفوعة جذابة. وسواء كنت منشئ محتوى أو مطوّرًا أو باحثًا أو محترفًا في الأعمال، فإن اختيار نموذج الذكاء الاصطناعي المناسب قد يعني الفرق بين إهدار المال على قدرات لن تستخدمها أبدًا وبين تحقيق مكاسب إنتاجية حقيقية. يفصّل هذا الدليل الشامل كل منصة ذكاء اصطناعي كبيرة، ويقارن عروضها المجانية بنظيراتها المدفوعة ببيانات معايير قياس حقيقية، وأسعار فعلية، وتقييمات أداء صادقة مبنية على أحدث مقاييس الأداء في نوفمبر 2025.
مشهد نماذج الذكاء الاصطناعي في نوفمبر 2025: ما الذي تغيّر
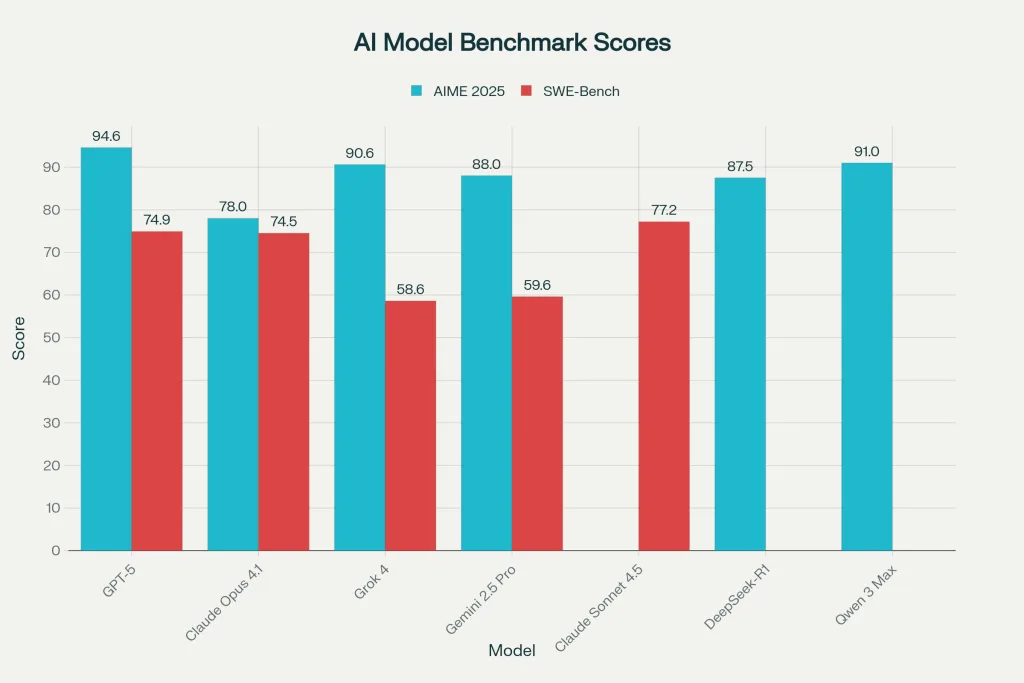
شهدت صناعة الذكاء الاصطناعي تحولات هائلة في 2025. أطلقت OpenAI GPT-5 في 7 أغسطس 2025، مُرسيةً معيارًا جديدًا للأداء بدرجة 94.6% في معيار قياس AIME 2025 للرياضيات. وقبل أسابيع قليلة فقط، كانت xAI قد أطلقت Grok 4 في 9 يوليو 2025، في موقع البديل الأسرع للمعلومات في الوقت الفعلي مع تكامل بيانات مباشر من X (المعروفة سابقًا بتويتر). وفي الوقت نفسه، لم تكن Anthropic جالسة مكتوفة الأيدي—إذ أطلقت Claude Opus 4.1 في يوليو 2025 ثم Claude Sonnet 4.5 في سبتمبر 2025، وكلاهما مصمّم لحالات استخدام محددة بدلًا من مطاردة أرقام معايير القياس الخام.
واستجابت Google DeepMind بعائلة Gemini 2.5، بما في ذلك نسخ Pro وFlash وFlash-Lite، وكل منها محسّن لنسب مختلفة بين الأداء والتكلفة. ولم يتخلّف مجتمع المصادر المفتوحة بدوره، إذ أطلقت DeepSeek نموذج R1 بترخيص MIT وأداء رياضي استثنائي (87.5% في AIME 2025)، بينما أطلقت Alibaba نموذج Qwen 3 Max بأكثر من تريليون معامل. هذه ليست مجرد منافسة—إنها إتاحة للجميع. فلأول مرة، أصبحت أدوات الذكاء الاصطناعي القوية حقًا مجانية فعلاً أو شبه مجانية، مما يجعل ذكاءً اصطناعيًا بمستوى المؤسسات في متناول أي شخص لديه اتصال بالإنترنت.
ثورة الطبقة المجانية: أي نماذج ذكاء اصطناعي لا تكلّف شيئًا فعلاً
من أهم تطورات 2025 جودة الوصول المجاني الحقيقي إلى الذكاء الاصطناعي. وخلافًا للسنوات الماضية حين كانت “الطبقات المجانية” نسخًا دعائية بالكاد تعمل، فإن العروض المجانية اليوم مفيدة فعلاً لملايين الأشخاص.
الطبقة المجانية من ChatGPT توفّر الوصول إلى GPT-5 مع تبديل تلقائي بين وضع أسرع وقدرات استدلال محدودة. ويحصل المستخدمون على حدود يومية للرسائل (غير معلنة رسميًا لكنها كافية عادةً للاستخدام العابر)، ووصول كامل إلى تصفح الويب، ورفع الملفات، وتوليد صور أساسي. والقيد الأساسي ليس القدرة—بل سقف الاستخدام. وخلال ساعات الذروة، قد يواجه المستخدمون المجانيون أوقات استجابة أبطأ، لكن النموذج نفسه هو النظام القوي ذاته المتاح للعملاء الدافعين.
الطبقة المجانية من Claude تقدّم 25 رسالة يوميًا عبر Claude.ai، مع وصول إلى Claude 3.5 Sonnet بقدرات كاملة للبحث والمساعدة في البرمجة والكتابة والتحليل. ونموذج Sonnet، رغم تأخّره عن Opus 4.1 في القدرة الاستدلالية الخالصة، يتفوّق عليه فعليًا في كثير من مهام البرمجة العملية، بدرجة 77.2% في SWE-Bench (مقابل 74.5% لـ Opus 4.1). ولمنشئي المحتوى والكتّاب، فإن الطبقة المجانية من Claude كافية فعلاً للعمل اليومي.
الطبقة المجانية من Gemini تستحق اهتمامًا خاصًا بوصفها ربما العرض المجاني الأكثر سخاءً في 2025. يحصل جميع المستخدمين على وصول غير محدود إلى Gemini 2.5 Flash بـ120 رسالة يوميًا، إضافة إلى وصول محدود إلى Gemini 2.5 Pro الأقوى للمهام المصنّفة “Reasoning, Math & Code”. ويحصل المستخدمون أيضًا على 15GB من التخزين السحابي (Google Drive القياسي) وتكامل مع Gmail وDocs. ويعني قيد نافذة السياق (120 رسالة يوميًا) أنك لا تستطيع مواصلة جلسات بحث مطوّلة، لكنه للمشاريع الفردية أو العمل اليومي قادر بشكل ملحوظ.
الطبقة المجانية من Grok تستحق ذكرًا كعرض xAI لمنظومة الطبقات المجانية. ورغم وجود قيود على الطبقات، يمكن للمستخدمين الوصول إلى Grok برصيد مجاني يكفي لاستخدام يومي معتبر، مع قدرات بحث ويب في الوقت الفعلي. والردود المبنية على الشخصية والنهج غير المفلتر في بعض الموضوعات تجعله متميزًا عن المنافسين.
DeepSeek-R1 يمثّل حالة خاصة: مجاني تمامًا، مفتوح المصدر بترخيص MIT، ومتاح إما عبر Alibaba Cloud أو Hugging Face أو محليًا على أجهزتك. لا حاجة إلى بطاقة ائتمان، ولا حدود للاستخدام، ولا مراقبة. ويحقق هذا النموذج 87.5% في معايير AIME 2025 الرياضية—منافس لكل نموذج باستثناء GPT-5—مما يجعله ربما أفضل قيمة مقابل السعر في الذكاء الاصطناعي اليوم.
فهم هياكل الأسعار: اقتصاديات الطبقة الاحترافية
يكشف تطوّر الأسعار في 2025 عن ثلاث فلسفات متمايزة تتنافس على دولار اشتراكك. وفهم هذه الاختلافات حاسم لاتخاذ قرارات فعّالة من حيث التكلفة.
نهج OpenAI ذو الطبقات الثلاث:
- ChatGPT Plus ($20/شهر): وصول كامل إلى GPT-5 مع أولوية في ساعات الذروة
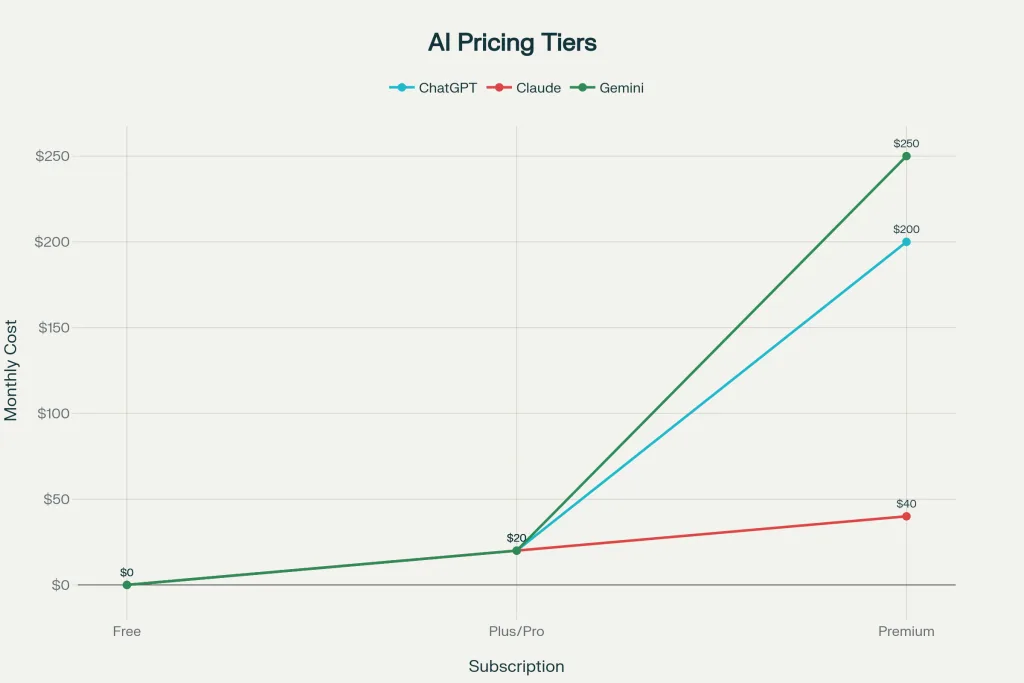
- ChatGPT Pro ($200/شهر): وصول غير محدود إلى GPT-5 مع وضع استدلال “Pro”، وعدد رسائل غير محدود، وحوسبة متقدمة للمهام المعقدة
- ChatGPT Team ($25-30/مستخدم/شهر): ميزات تعاون للمؤسسات
تمثّل طبقة $200/شهر رهان OpenAI على أن بعض المستخدمين (الباحثين والمؤسسات والمحترفين) سيدفعون مقابل توفر مضمون وقدرة استدلال غير محدودة. وهذا هو الاشتراك الوحيد في الذكاء الاصطناعي الذي يتجاوز حاجز $100/شهر، بما يعكس التموضع المتميز لقدرات GPT-5.
استراتيجية Anthropic المرتكزة على القيمة:
- Claude Pro ($20/شهر): وصول غير محدود إلى Claude 3.5 Sonnet مع حصة استخدام خمسة أضعاف مقابل الطبقة المجانية
- Claude Max ($40/شهر): وصول إلى Claude Opus 4.1 لمهام الاستدلال المعقدة
- Claude Team ($30/مستخدم/شهر): ميزات التعاون ومساحات العمل
أسعار Anthropic معتدلة عن قصد، مما يشير إلى أن استراتيجيتها تقوم على الانتشار والحصة السوقية بدلًا من الاستخراج الأقصى للإيرادات. وسقف $40 للوصول المتميز غير المحدود أقل بكثير من $200 لدى ChatGPT، ومع ذلك تضع درجة Opus 4.1 البالغة 74.5% في SWE-Bench ضمن مسافة تنافسية من GPT-5.
الحل الوسط الهجومي من Google:
- الطبقة المجانية من Gemini: وصول كامل إلى Gemini 2.5 Flash (120 رسالة يوميًا) مع وصول محدود إلى Gemini 2.5 Pro
- Google One AI Pro ($19.99/شهر): يشمل وصولًا غير محدود إلى Gemini 2.5 Pro (100 استعلام يوميًا)، و2TB من التخزين، وتكاملًا مع Workspace
- Google One AI Ultra ($249.99/شهر): “وكلاء متقدمون” وميزات من أحدث ما توصلت إليه التقنية
طبقة Ultra من Google بسعر $249.99/شهر (مقابل Gemini 2.5 Pro بسعر $19.99) قفزة هائلة، تستهدف عملاء المؤسسات الذين يحتاجون أحدث القدرات على الإطلاق. وحد الـ120 رسالة في الطبقة المجانية هو الأكثر تقييدًا بين المنصات الكبرى، لكن الجودة والتكامل مع خدمات Google (Docs وSheets وGmail) يوفّران قيمة حقيقية في مكان العمل للطلاب والمحترفين الذين يستخدمون منظومة Google بالفعل.
أسعار الاشتراكات الشهرية: ChatGPT مقابل Claude مقابل Gemini
تفصيل معايير القياس: ماذا تعني هذه الدرجات فعلاً
درجات معايير الذكاء الاصطناعي تشبه امتحان SAT للنموذج—مهمة لكنها غير كاملة. ومع ذلك، يساعدك فهم هذه المعايير على توقّع الأداء في العالم الحقيقي.
AIME 2025 (الاستدلال الرياضي) يمثّل مسابقة رياضيات متقدمة من 15 سؤالًا. ودرجة 94.6% تعني أن GPT-5 حلّ ما يقارب 14 من 15 مسألة بشكل صحيح. وقد تشبّع هذا المعيار أمام نماذج LLM القديمة منذ سنوات؛ ونسخة 2025 أصعب بكثير. وللمقارنة، فإن متوسط أداء الإنسان في AIME هو 26-40% (نحو 4-6 مسائل)، مما يعني أن حتى “أسوأ” نموذج ذكاء اصطناعي كبير (Gemini 2.5 Pro بـ88%) يتفوّق على 99.9% من البشرية في حل المسائل الرياضية الخالصة.
SWE-Bench (هندسة البرمجيات) يقيّم مشكلات GitHub الواقعية لاختبار ما إذا كانت النماذج تستطيع حل مشكلات برمجية عملية فعلاً. ودرجة Claude Sonnet 4.5 البالغة 77.2% تعني أنه قادر على حل ما يقارب 77 من 100 مهمة هندسة برمجيات واقعية بشكل مستقل—إنجاز مذهل يضعه في أعلى 1% من المطورين البشر. وأداء GPT-5 البالغ 74.9% في التقييم الموحّد تنافسي رغم التوقعات. وهذه ليست درجات نظرية؛ بل تُقيَّم مقابل طلبات سحب وإصلاحات أخطاء فعلية في قواعد برمجية إنتاجية.
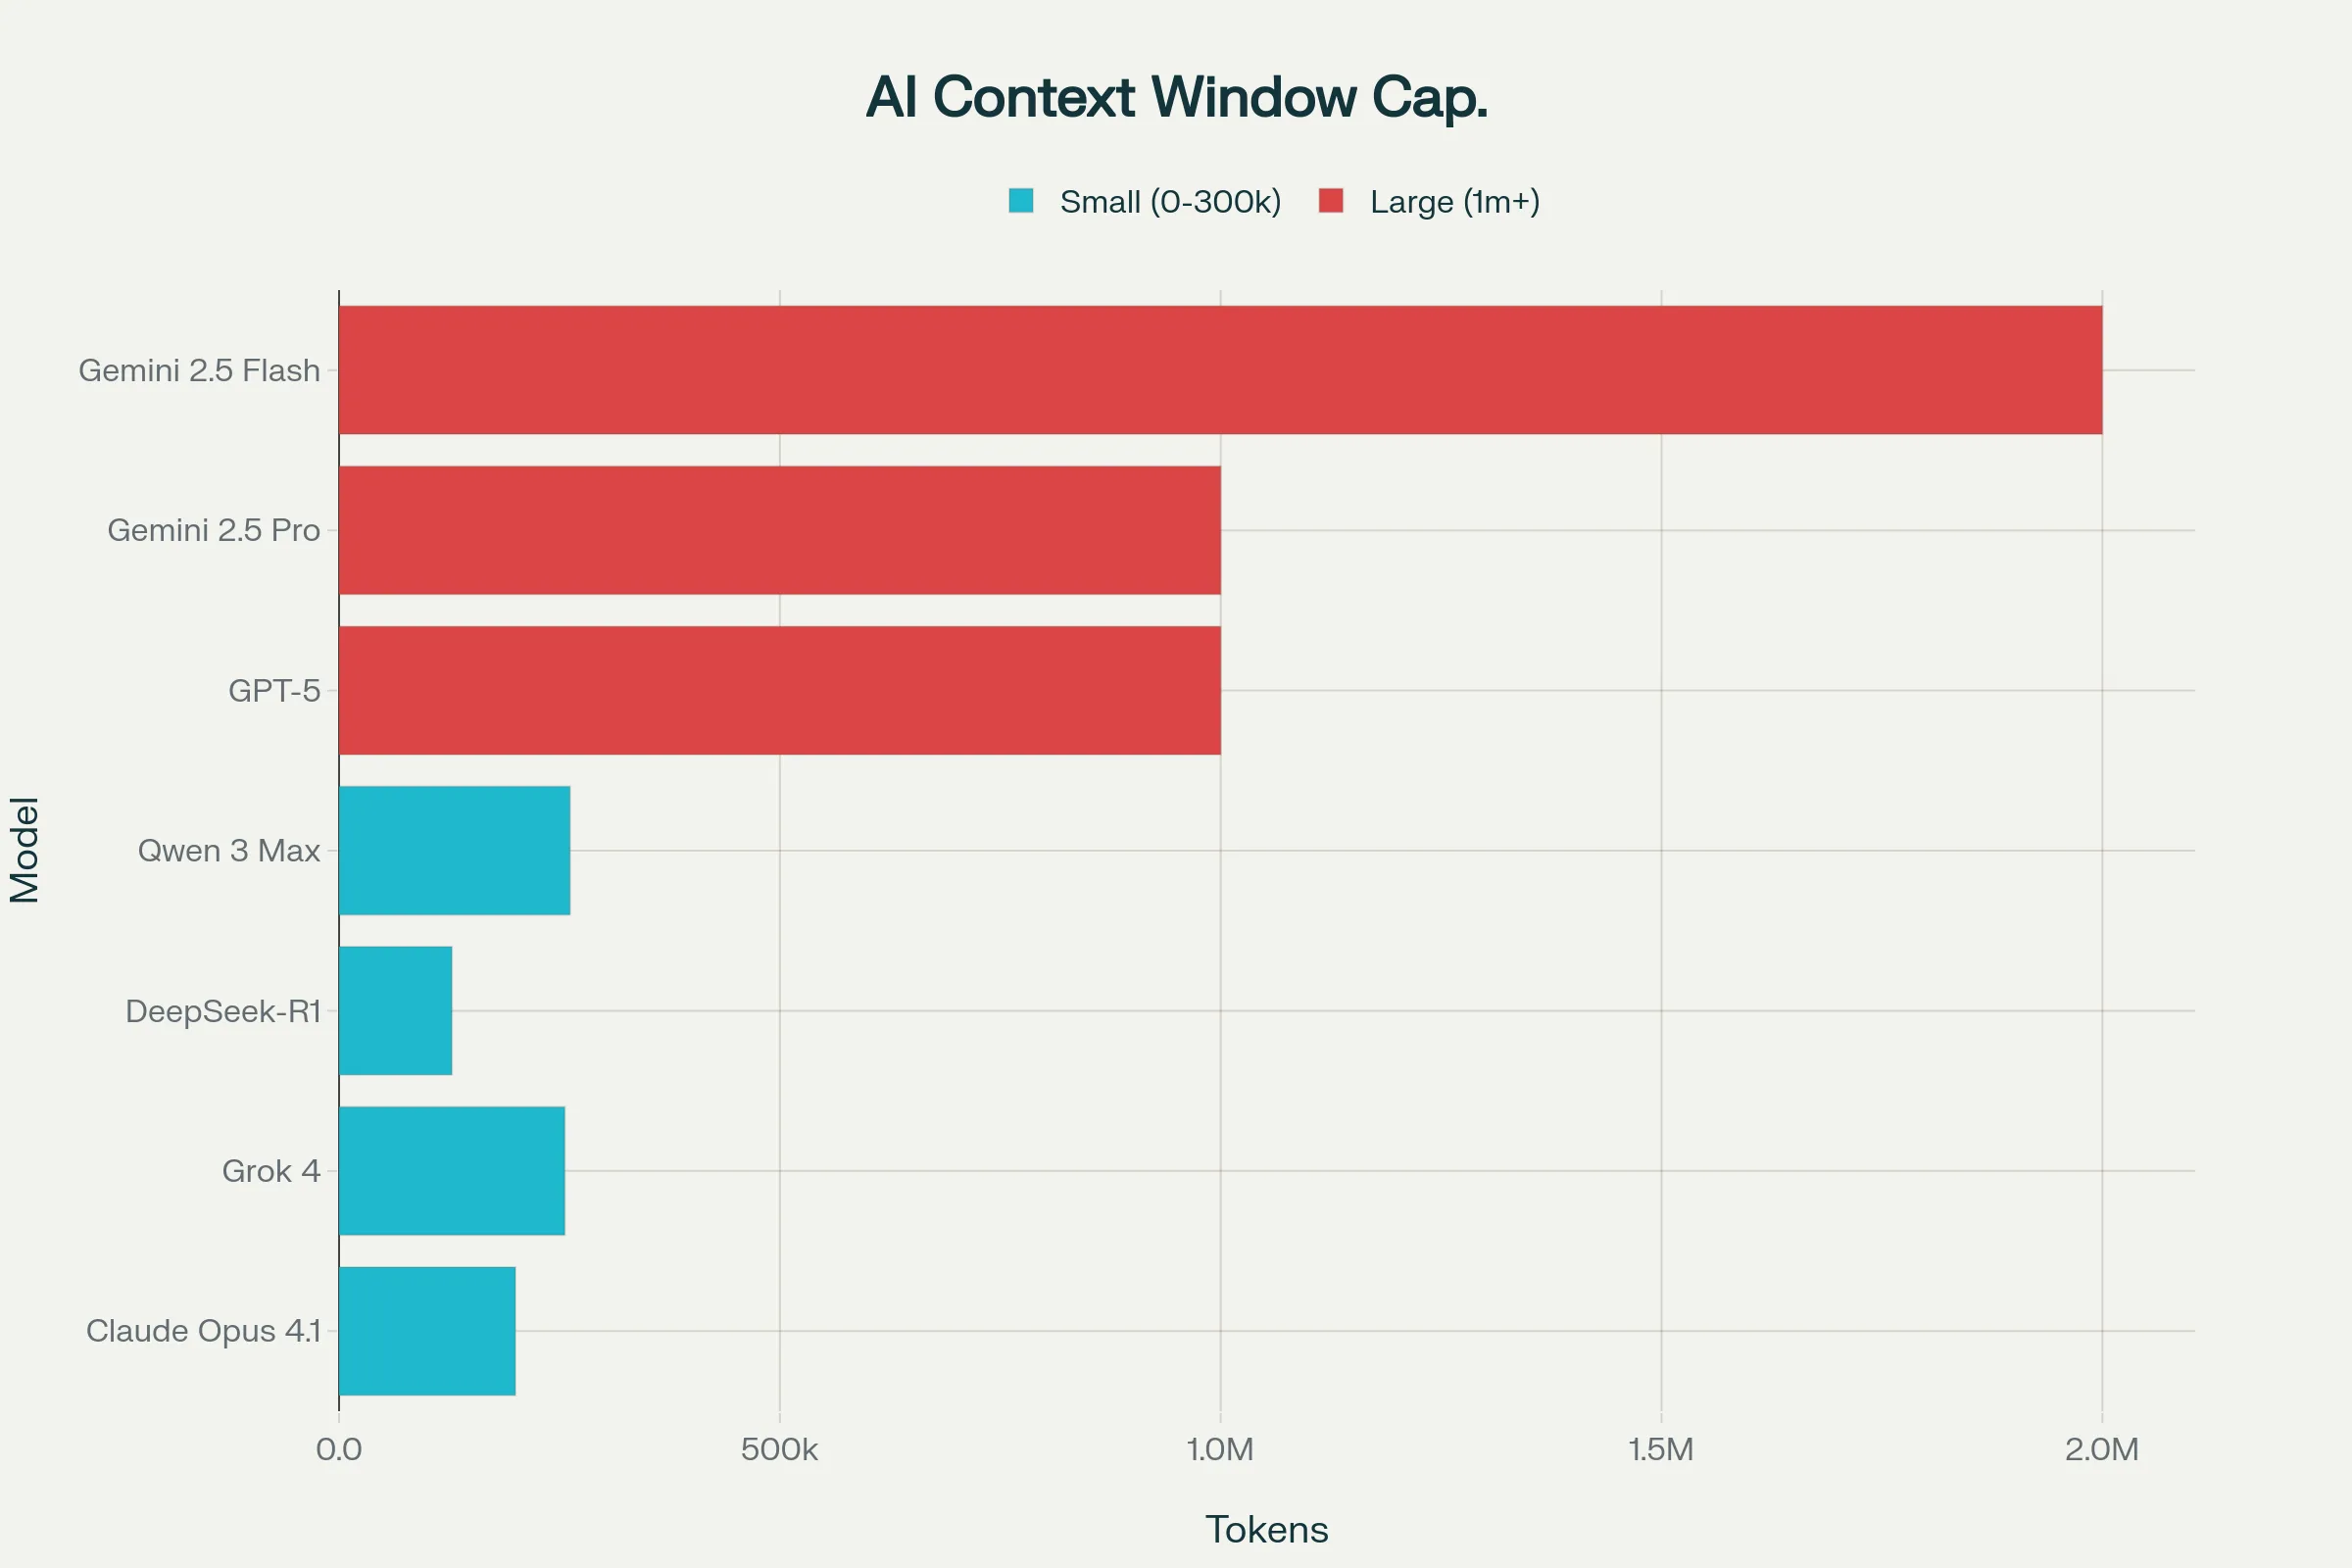
أداء نافذة السياق يقيس مقدار المعلومات التي يستطيع النموذج معالجتها في آن واحد. وقدرة Gemini 2.5 Flash البالغة 2 مليون رمز تعادل نحو 1,500 صفحة من المستندات القانونية أو الأوراق البحثية أو سجل المحادثات. أما مليون رمز لدى GPT-5 فيدعم نحو 750 صفحة. وهذا يهم أكثر مما يدركه المستخدمون العاديون—فنافذة سياق أقل من 200K رمز (مثل نماذج Claude الأقدم) تفرض عليك تقسيم المشاريع الكبيرة إلى أجزاء، مما يقلل التماسك ويُدخل أخطاءً.
الحدود الناشئة: المعايير التقليدية “تتشبّع” (أي تصل النماذج إلى درجات شبه كاملة)، لذا قدّمت 2025 اختبارات جديدة قاسية. ويغطي Humanity’s Last Exam (HLE) خمسة عشر سؤالًا ملائم الصعوبة عبر العلوم والتقنية والعلوم الإنسانية، بمكوّنات متعددة الوسائط. وحتى GPT-5 لا يسجّل سوى نحو 25% في HLE—أي 4 أسئلة صحيحة من 15—مما يجعله مقياسًا صادقًا لحدود الذكاء الاصطناعي الحالية. ويمثّل FrontierMath رياضيات معقدة لا تحل فيها أنظمة الذكاء الاصطناعي سوى 2% من المسائل، بينما يحقق BigCodeBench للبرمجة دقة 35.5% فقط.
الأداء في العالم الحقيقي: أين يتفوّق كل نموذج فعلاً
تخلق درجات معايير القياس سردًا مقنعًا، لكن الاستخدام في العالم الحقيقي يحكي قصة مختلفة. فالنماذج المختلفة تتفوّق فعلاً في مهام مختلفة.
للمهام الرياضية والاستدلالية: GPT-5 يتصدّر
درجة 94.6% في AIME ليست هامشية—إنها فارق 6 نقاط عن المنافس التالي. وعمليًا، إذا كنت تعمل على مسائل رياضية معقدة أو حسابات فيزيائية أو استدلال منطقي متعدد الخطوات، فإن GPT-5 يتفوّق باستمرار على البدائل. والفرق يهم أكثر في حل المشكلات حيث تنتشر الأخطاء الرياضية الدقيقة. ولمساعدة الواجبات الرياضية العابرة، هذه الميزة غير مرئية؛ أما للعمل الاحترافي، فهي حاسمة.
لتحليل المستندات الطويلة والبحث: Gemini 2.5 Pro يتصدّر
تتيح نافذة السياق البالغة مليون رمز لـ Gemini 2.5 Pro استيعاب أطروحة كاملة أو مجموعة بحثية أو مدونة مستندات قانونية في موجّه واحد. ولطلاب الدكتوراه الذين يحللون 500 صفحة من البحث الخلفي أو المحامين الذين يراجعون ملفات القضايا، فإن قدرة Gemini 2.5 Pro على الحفاظ على السياق عبر مستندات ضخمة حقًا تخلق فرقًا نوعيًا في القدرة التحليلية. كما تميّزه القدرات الأصلية متعددة الوسائط (مدخلات نصية وصورية وفيديو وصوتية) في مشاريع البحث متعددة الوسائط.
لمهام البرمجة الذاتية: Claude Sonnet 4.5 يتقدّم
إنجاز Anthropic الرائد هو التحمّل. فـ Sonnet 4.5 قادر على تشغيل سير عمل برمجي ذاتي لأكثر من 30 ساعة دون فقدان التماسك أو تدهور جودة المخرجات. وللمطورين الذين يؤتمتون إعادة هيكلة معقدة لملفات متعددة، أو يبنون خطوط توليد أكواد، أو يديرون جلسات تطوير مطوّلة، فإن ميزة المتانة هذه تحويلية. وتعكس درجة 77.2% في SWE-Bench توليد أكواد عمليًا جاهزًا للإنتاج.
للبيانات الفورية والأحداث الجارية: Grok 4 يفوز
نافذة السياق البالغة 256K رمز لدى Grok 4، مقترنة بتكامل مباشر مع X (تويتر) وبحث ويب فوري، تخلق ميزة فريدة للبحث الحسّاس للوقت. وإذا كنت تحتاج تحليلًا بالذكاء الاصطناعي للأخبار العاجلة أو اتجاهات سوق الأسهم الحالية أو المشاعر الاجتماعية الناشئة، فإن قدرة Grok 4 على جلب بيانات مباشرة من شبكة X تميّزه عن المنافسين المقيّدين بحدود معرفة ثابتة. وحد المعرفة في سبتمبر 2024 (أقدم من حد GPT-5) لا يهم عندما تصل إلى معلومات فورية.
للمطورين الحريصين على التكلفة: DeepSeek-R1 يتصدّر
بأداء 87.5% في AIME، ووصول كامل إلى المصادر المفتوحة، وترخيص MIT، وتكلفة صفرية، وبلا حدود استخدام، وبإمكانية التشغيل محليًا على أجهزتك، يمثّل DeepSeek-R1 أفضل قيمة مقابل السعر في الذكاء الاصطناعي. والمقايضة هي التطور—فبعض مهام الاستدلال الحدّية تتطلب حوسبة استدلال إضافية توفّرها النماذج الطليعية—لكن في 95% من التطبيقات العملية، لا يُضاهى مزيج القدرة والحرية في DeepSeek-R1.
لسير العمل متعدد اللغات والمؤسسي: Qwen 3 Max يتفوّق
يُظهر Qwen 3 Max من Alibaba (أكثر من تريليون معامل) قوة خاصة في المعالجة متعددة اللغات والتعامل مع البيانات المهيكلة. ونافذة السياق البالغة 262K رمز، مقترنة بتسعير متدرّج مرن، تجعله جاذبًا للمؤسسات والمنظمات متعددة اللغات. ويوفّر حد المعرفة في ديسمبر 2024 (الأحدث من بعض المنافسين) معلومات أطزج لتحليل الأحداث الجارية.
لعبة أسعار API: أين تهمّ الاقتصاديات الحقيقية
بالنسبة للمطورين والشركات، يصبح تسعير API المتغير الحاسم. فقد يكون النموذج مثاليًا لحالتك، لكن التسعير غير المستدام يقتل المشروع.
الأكثر تكلفة: Claude Opus 4.1 بـ$15 للإدخال و$75 للإخراج لكل مليون رمز. هذه هي طبقة المؤسسات. ولعمل الاستدلال الجاد مع تطبيقات كثيفة الإخراج، قد تكون تكلفة Opus 4.1 ضعف إلى ثلاثة أضعاف المنافسين. ومع ذلك، تبرّر جودة الاستدلال وموثوقيته العلاوة للتطبيقات الحرجة.
متميز لكنه تنافسي: GPT-5 بـ$1.25 للإدخال و$10 للإخراج لكل مليون رمز. هذا أرخص من معظم المنافسين رغم أنه النموذج الرائد الأقدر. ويعكس التسعير العدواني استراتيجية OpenAI السوقية—التفوّق في السعر مع الهيمنة في القدرة.
أفضل قيمة في الفئة المتوسطة: Claude Sonnet 4.5 بـ$3 للإدخال و$15 للإخراج لكل مليون رمز. وبكونه أفضل من GPT-5 في كثير من مقاييس البرمجة وأرخص بكثير من Opus 4.1، يمثّل Sonnet 4.5 النقطة المثلى لمعظم التطبيقات الإنتاجية.
اقتصادي للغاية: Gemini 2.5 Flash بـ$0.30 للإدخال و$2.50 للإخراج لكل مليون رمز. وبنحو عُشر تكلفة GPT-5، فإن Gemini 2.5 Flash مثالي للتطبيقات عالية الحجم حيث تهمّ السرعة الخالصة أكثر من أقصى دقة. والمقايضة حقيقية—فهو أقل قدرة بشكل ملحوظ من النماذج الرائدة—لكن لتوسيع روبوتات المحادثة وأتمتة خدمة العملاء والتحليل الروتيني، يبرّر توفير التكلفة انخفاض القدرة.
الفائز المطلق: DeepSeek-R1 بمجانية تامة للوصول إلى المصادر المفتوحة. وحتى على API التجاري لـ Alibaba Cloud، يظل التسعير المتدرّج (بدءًا من $0.861 لكل مليون رمز إدخال للموجّهات الصغيرة) أرخص بكثير من أي بديل مملوك. وللتطبيقات الحسّاسة للسعر على نطاق واسع، فإن DeepSeek-R1 لا يُقاوم اقتصاديًا.
تمييز الميزات: ما الذي يفصل هذه النماذج حقًا
بعد المعايير والأسعار، تخلق ميزات محددة مزايا حقيقية في سير العمل.
قدرات الصوت: تتضمن خطة ChatGPT Plus وضع صوت متقدم بذكاء عاطفي، مما يتيح محادثة طبيعية مع GPT-5. ويدعم Gemini الإدخال والإخراج الصوتي. ويبقى Claude نصيًا فقط. ولإمكانية الوصول وسير العمل دون استخدام اليدين، يهمّ تفوّق ChatGPT في الصوت.
الرؤية وتعدد الوسائط: يدعم Gemini 2.5 Pro مدخلات أصلية نصية وصورية وفيديو وصوتية—تعدد وسائط حقيقي. ويستطيع ChatGPT تحليل الصور لكن تحليل الفيديو محدود. ويتعامل Claude مع الصور بفعالية لكنه يفتقر إلى الفيديو والصوت. وللتحليل متعدد الوسائط (تحليل نصوص الفيديو، معالجة مجموعات بيانات الصور، إلخ)، تبقى قدرات Gemini وحيدة.
البحث الفوري في الويب: يدمج Grok 4 بيانات X المباشرة؛ ويستخدم ChatGPT بحث Bing؛ ويدمج Gemini بحث Google ولديه بيانات فورية من X. ولا يملك Claude بحثًا في الويب. وللبحث في الأحداث الجارية وتحليل الأخبار واحتياجات المعلومات الفورية، يوفّر ChatGPT وGemini قدرات متقاربة بينما يقدّم Grok 4 أسرع وصول إلى المشاعر الاجتماعية.
توليد الأكواد: يعمل تكامل GitHub Copilot مباشرة مع واجهات API الخاصة بـ ChatGPT وClaude وGemini. ويوفّر Claude Code تكاملًا مباشرًا مع بيئة التطوير، مما يتيح لنماذج Anthropic تعديل الملفات مباشرة دون نسخ ولصق يدوي. وللمطورين، يزيل التكامل المحكم لـ Claude مع بيئة التطوير الاحتكاك.
نماذج GPT المخصصة والضبط الدقيق: تتيح OpenAI للمستخدمين إنشاء نسخ مخصصة من ChatGPT لمهام محددة. ولا تقدّم Anthropic وظيفة مكافئة في الطبقات المجانية. ولسير العمل المخصص وشخصيات الذكاء الاصطناعي الخاصة بالعلامة التجارية، يخلق نهج OpenAI ارتباطًا.
تحليل التكلفة والعائد: أي نموذج ذكاء اصطناعي تختار فعلاً؟
هنا يلتقي البحث بالبراغماتية. فأفضل نموذج ذكاء اصطناعي لك يعتمد كليًا على حالتك المحددة.
للطلاب والمستخدمين العاديين:
ابدأ بـ Gemini Free. حد الـ120 رسالة يوميًا مع وصول غير محدود إلى Flash ووصول محدود إلى Pro يوفّر أقصى قدرة بلا احتكاك. أضف Claude Pro ($20/شهر) إن كنت تحتاج استخدامًا يوميًا غير محدود. التكلفة الإجمالية: $20/شهر مقابل وصول غير محدود فعليًا إلى نموذجين قويين مختلفين.
لمنشئي المحتوى والكتّاب:
Claude Pro ($20/شهر) يقدّم أفضل جودة كتابة، خصوصًا للمحتوى الطويل وتوليد المقالات والعمل التحريري. وأسلوب Claude في الكتابة أكثر دقة طبيعية من المنافسين، والطبقة المجانية البالغة 25 رسالة يوميًا (مع استخدام خمسة أضعاف في Pro) توفّر سير عمل متواصلًا. وإن كنت تحتاج استدلالًا متطورًا للمفاهيم المعقدة، أضف ChatGPT Plus ($20/شهر) لمهام الاستدلال المحددة. التكلفة الإجمالية: $20-40/شهر.
لمطوري البرمجيات:
Claude Pro ($20/شهر) للبرمجة اليومية، مقترنًا بـ DeepSeek-R1 محليًا لاستدلال متقدم بلا تكلفة أثناء التطوير. ويوفّر المزيج قدرة شبه غير محدودة مع إبقاء التكاليف في حدها الأدنى. وإن كنت تبني أنظمة إنتاجية، أضف ChatGPT Plus ($20/شهر) للميزة البرمجية الطفيفة في المشاريع المعقدة. وللواجهات API، استخدم Gemini 2.5 Flash للمهام الروتينية عالية الحجم وClaude Sonnet 4.5 للعمل المكثّف بالاستدلال.
للباحثين والأكاديميين:
Google One AI Pro ($19.99/شهر) يفتح نافذة السياق البالغة مليون رمز في Gemini 2.5 Pro، مما يتيح تحليل ورقة أو أطروحة كاملة في جلسة واحدة. وهذا لا يُعوَّض لمراجعة الأدبيات على نطاق واسع. أضف Claude Pro ($20/شهر) كمساعد بحث ثانٍ لمنظور فريد وتحقق متقاطع من التحليل. التكلفة الإجمالية: $40/شهر لقدرة ذكاء اصطناعي بمستوى البحث.
للشركات الصغيرة:
ابدأ مجانًا: استخدم الطبقات المجانية من ChatGPT وClaude وGemini للتجريب لتحديد سير عملك الفعلي. وبعد أن تحدد أين يضيف الذكاء الاصطناعي قيمة، استثمر في اشتراك مدفوع أساسي واحد ($20-40/شهر) بدلًا من الدفع مقابل طبقات متميزة متعددة لن تستخدمها. ومعظم الشركات الصغيرة تحقق عائدًا على استثمارها من توفير الوقت لمساعد واحد في غضون أسابيع.
للمؤسسات الكبرى:
تفاوض على عقود API مباشرة مع المزوّدين (OpenAI وGoogle وAnthropic) بدلًا من استخدام اشتراكات المستهلكين. فاتفاقيات المؤسسات توفّر خصومات الحجم واتفاقيات مستوى الخدمة والدعم المخصص والحوسبة المخصصة التي تبرّر تعقيد التفاوض. ولمهام الاستدلال المكثّفة، استخدم Claude Opus 4.1 رغم تسعيره المتميز ($15/$75 لكل مليون رمز). وللمهام السلعية عالية الحجم (خدمة العملاء، التحليل الروتيني)، استخدم Gemini 2.5 Flash.
المجاني مقابل الاحترافي: الفرق الحقيقي في 2025
أهم رؤية هي هذه: فجوة الجودة بين الطبقات المجانية والاحترافية قد انهارت. في 2024، كانت النسخ المجانية تستخدم نماذج قديمة. وفي 2025، تستخدم النسخ المجانية غالبًا النماذج الرائدة نفسها التي تستخدمها الطبقات المدفوعة، مع قيود مصطنعة (حدود الرسائل، وتحديد المعدل) بدلًا من قيود القدرة.
هذا يغيّر كل شيء في معادلة التكلفة والعائد. يستطيع طالب أو مستقل واقعيًا استخدام الطبقات المجانية فقط والحصول على مساعدة ذكاء اصطناعي بمستوى احترافي. فالطبقات المجانية كافية فعلاً لـ80% من حالات الاستخدام. ويلتقط اشتراك $20/شهر الـ20% المتبقية—استخدام غير محدود، ومعالجة ذات أولوية، وزيادات هامشية في القدرة، لا قفزة أداء جوهرية.
نظرة إلى الأمام: ما القادم في أواخر 2025
تستمر حدة المنافسة. ويُتوقع أن تطلق OpenAI GPT-4.5 بقدرات “operator” جديدة لتنفيذ المهام ذاتيًا. وتوسّع Anthropic قدرات Claude الوكيلية بنوافذ سياق أطول وتخطيط محسّن. وتطرح Google Gemini 2.5 Ultra باستدلال أكثر تقدمًا. وتواصل Alibaba تطوير Qwen، مع تلميحات إلى أن الإصدار الكامل من Qwen 3 Max سيتجاوز أداء النسخة التجريبية.
الاتجاه واضح: القدرات تزيد، والأسعار تنخفض أو تستقر، والطبقات المجانية تصبح أكثر سخاءً. وبحلول 2026، ستصبح قدرة النماذج الطليعية الحالية على الأرجح مجانية أو شبه مجانية، مع تخصيص الطبقة المتميزة لميزات استثنائية (تكامل فوري مثالي، اتفاقيات مستوى خدمة مضمونة، إلخ) بدلًا من الأداء الأساسي.
الخاتمة: اتخاذ قرارك
اعتبارًا من نوفمبر 2025، يقدّم مشهد نماذج الذكاء الاصطناعي قيمة غير مسبوقة. فلم يعد الاختيار بين الطبقات المجانية والاحترافية يعني التضحية بالقدرة—بل يعني الاختيار بين راحة الاستخدام وأحدث الميزات على الإطلاق. ولمعظم الناس، توفّر طبقة مجانية مختارة استراتيجيًا مع اشتراك واحد بـ$20/شهر كل ما يحتاجونه لمساعدة ذكاء اصطناعي متقدمة.
الفائزون في الطبقة المجانية هم: ChatGPT (GPT-5)، وClaude (3.5 Sonnet)، وGemini (2.5 Flash)—كلها قوية حقًا، وليست مجرد نسخ دعائية. الطبقة الاحترافية الأكثر أهمية تعتمد على حالتك المحددة: Claude Pro للكتابة والاستدلال، أو ChatGPT Plus للاتساع، أو Google One AI Pro لبحث السياق الطويل، أو Grok للبيانات الفورية. أفضل قيمة مقابل السعر تبقى DeepSeek-R1، مجانية تمامًا بترخيص MIT، وتحقق أداءً قريبًا من الطليعة دون أي قيود.
انتهى عصر الذكاء الاصطناعي المكلف الذي يحرس البوابة. وبدأ عصر الذكاء الاصطناعي الوفير والمتاح. والسؤال ليس هل تستطيع تحمّل تكلفة مساعدة الذكاء الاصطناعي—بل أي أداة ذكاء اصطناعي تناسب سير عملك المحدد. اختبر الطبقات المجانية. واختر اشتراكًا مدفوعًا مكمّلًا واحدًا إن احتجت المزيد. ثم ابنِ قدرتك حول أدوات محسّنة لعملك الفعلي، لا حول أحدث إعلان في دورة الضجيج.